







本文围绕ChatGPT文生图能力的更新展开,探讨了其从依赖DALL·E模型到采用非自回归模型的转变,分析了新模型在图像生成准确性、效率及多模态融合等方面的优势,同时对比了不同文生图工具的表现,思考了OpenAI技术路线调整背后的原因与意义
昨晚,Open AI更新了ChatGPT文生图能力。
准确来说,这次升级是一次小革命。以前,它借助DALL—E来生成图像,现在功能直接融入到ChatGPT里面了。
新能力能让ChatGPT生成的图片更准确。什么叫准确?按照官方意思,能贴合你的要求。要让它生成一个戴眼镜的猫咪,它会先思考一下,然后画出来一个更详细的戴眼镜的猫咪。
最后一项是修改图像。哪些细节不满意,直接告诉它就能修改。
官方直播活动中,也演示了几个例子。有两名研究人员和奥特曼拍了一张合影,然后他们让ChatGPT把这张普通的照片变成动画风格的画。结果,ChatGPT轻松地就完成了这个任务。
另一个是,团队要求ChatGPT在生成的图像上加一些文字,比如在图片上写上“Feel The AGI”。ChatGPT也顺利地做到了。
看不少介绍的文章后,感觉有些吹捧,于是上午见完朋友,下午回来赶紧试了试。问题是,怎么区分不同模型之间的能力差异呢?
我让Qwen帮我写了个提示词:
“想象一个赛博朋克风格的场景,霓虹灯一闪一闪的,到处都是高楼大厦,楼上有大广告屏,街上跑着悬浮车,天上飞着无人机,还有一轮紫色的月亮挂在天上,地上的行人穿着高科技的衣服。从高处往下看整个城市,画面要高清,细节越多越好”。
写完后,把提示词分别给了GPT和即梦AI。不到20秒,GPT出图了,它和即梦AI的图对比来说,每个模型对提示词的理解不同,两张图都有赛博朋克的感觉,但细节上各有特点。
要评价的话,两张图片都比较模糊。但即梦AI操作起来比较方便,直接点击细节修复、超清功能,就能有效提升清晰度,效果明显。
GPT在这方面稍显不足,我让它生成高清一点的图,结果它又生成了一张图,遗憾的是,依然没有达到我的预期。
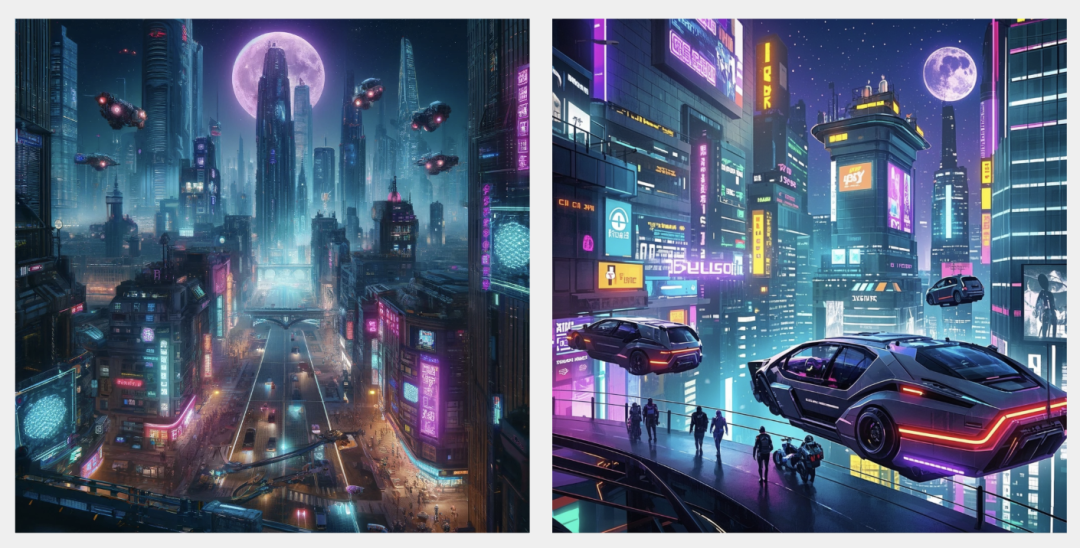
图释:左,Chat GPT;右,即梦AI
因此,从图像清晰度控制的可控性来看,GPT可能稍弱一些。不过它也有自己的优势;比如:在调整尺寸上,我提出要1:1尺寸的图片时,它会给到两个不同的解决方案,并问我,你觉得哪个更高?更倾向哪个?
重复试了好几个提示词,结果依然这样。
我又试了一下它的新能力:世界知识的功能。官方说,这功能让AI在生成图片时,能更好地理解,并用上现实世界里的知识,做出的图更贴合用户的要求,也更符合实际逻辑。
说白了,AI在作图时,会考虑现实里的细节,像地理位置、文化背景、还有物理规矩啥的。比如,画个雪山就不会冒出热带植物,画个古代场景不会突然冒出手机。
于是,我让Qwen帮我又写了一个提示词:
“生成一张图,用两个站在滑板上的人推对方的动作来解释牛顿第三定律。要求画面直观,能清楚展示作用力和反作用力的关系。”
给到它后,怎么评价呢?像那么回事。它能展示两个人在滑板上互相推开的关系,而且还增加了一些箭头和英文解释;但是,我为什么觉得这个能力像一个图像PPT功能呢。
紧接着,我又测试几轮,分别生成一个人的头部骨骼、身体骨骼。如果满分是10分,我最多给6分,因为大部分能力字节、腾讯的文生图模型都能做到。
Sam Altman对这款产品评价很高,表示难以相信这是AI生成的,认为大家会喜欢,并期待用户用它创作出更多创意内容。
他的目标是尽量避免生成冒犯性内容,认为将创作自由和控制权交给用户是正确的,但也会关注实际使用情况并听取社会意见。
Altman希望大家理解,他们在努力平衡自由和责任的关系,确保AI的发展符合大家的期望和道德标准。这些都是老生常谈的话。
我觉得,比起它目前的生成能力,更应该关注它为什么要替代DALL·E模型。要知道,DALL·E模型是OpenAI在2021年1月发布的模型。作为老模型,难道不应该持续迭代,让它更强大吗?
实际上,关键在于DALL-E模型核心架构是自回归模型。
什么是自回归模型呢?
它利用自身历史的数据来预测未来的数据。工作方式是把图像拆解为一系列token(类似于文字中的单词),然后像写作文一样,一个token一个token地生成图像。
举个例子:
你要画一只猫,你先画了猫的头,然后根据头的样子再画眼睛,再根据眼睛和头的关系画鼻子,一步步来,不能跳过任何一个步骤。这就是自回归模型的工作方法。
优点是能保证细节,缺点很明显,一,速度跟不上、二,前面要是画错了,后面很难调整;因此,OpenAI选择用新的模型来替代它。
那么,替代后的模型什么样呢?答案是非自回归模型(Non-autoregressive models),它改变了核心架构。
这个架构会先理解整个图的结构和细节,更像学生先听完老师讲完题目,把整张画的轮廓搞出来,再一点点填细节。比如:画只猫,先勾勒出猫的外形,再去细化毛发、眼睛。
这种模型采用一种特殊的编码、解码架构来实现目标。简单来说,编码器负责“读题”,理解你输入的文字;解码器负责“作答”,根据文字生成图片。
优势在于,一,不再像老方法那样一步步、逐像素地生成图像,效率更高,二,整体表现更强,特别是在复杂场景里,能更好地处理多个物体之间的关系,生成的图片更逼真。
好比画一个桌子上有杯子、书本和台灯的场景,非自回归模型能更自然地处理东西的位置和光影效果,不会显得乱七八糟。而且,它对复杂的文字指令理解得更好,生成的图片和描述基本能做到符合逻辑。
还有一个特点:这种模型灵活性强,能融合到多模态里,比如,把它塞进ChatGPT 4.0里,它不仅能看图,还能结合音频或已有的图像,进而生成更多样化的内容。
因此,Open AI这一步本质做了一次小小的自我革命。
春节时,DeepSeek发布一款文生图模型Janus-Pro,关注过的人应该知道,它采用了非自回归的框架。Janus系列中的Janus-Pro-7B模型,在GenEval的准确率上达到了80%,甚至超过DALL-E 3的61%。
我查了一下,这种非自回归模型最早在2018年的ICLR会议上提出,最初应用于神经机器翻译(Neural Machine Translation, NMT)领域,目的是加速推理速度。
从论文综述来看,微软在2022年5月13日进行了进一步研究。而国内2023年左右,阿里巴巴、科大讯飞、昆仑万维、云从科技等一系列企业已经引入这一技术。
本文由人人都是产品经理作者【王智远】,微信公众号:【王智远】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。