






前段时间 OpenAI 发布了针对复杂推理问题的大模型——o1,也就是草莓模型。这款大模型一经发布就引起巨大的关注,但基本上都是关于使用和测评的。这篇文章,我们就来看看,o1模型的背后,其创新、原理分别是什么。
虽然OpenAI 2024年 年化营收预计将从前一年的20亿美元大幅增长至约35亿美元,但仍无法覆盖其90亿的推理、训练成本。
目前来说,OpenAI订阅的商业模式很难称得上是一个好的变现手段,更无法与广告这一互联网时代最佳商业模式相提并论。
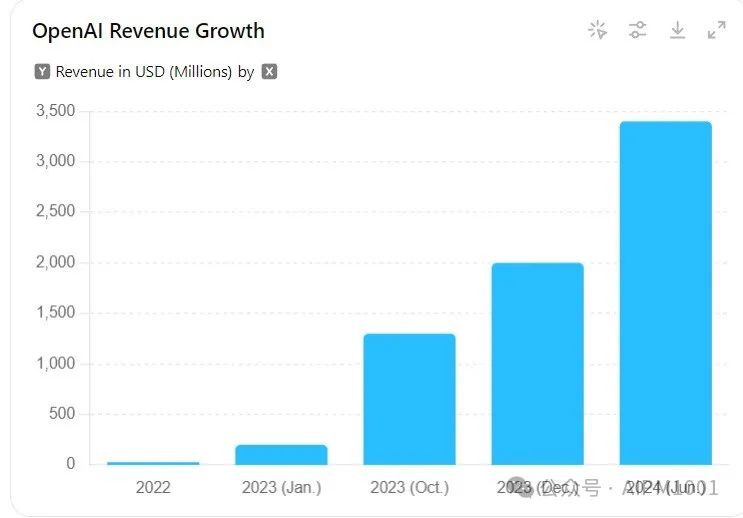
(OpenAI营收变化趋势,来源:tooltester)
在营收构成上,C端用户订阅、企业用户、API和ChatGPT Team业务分别占营收的55%、21%、15%和8%。
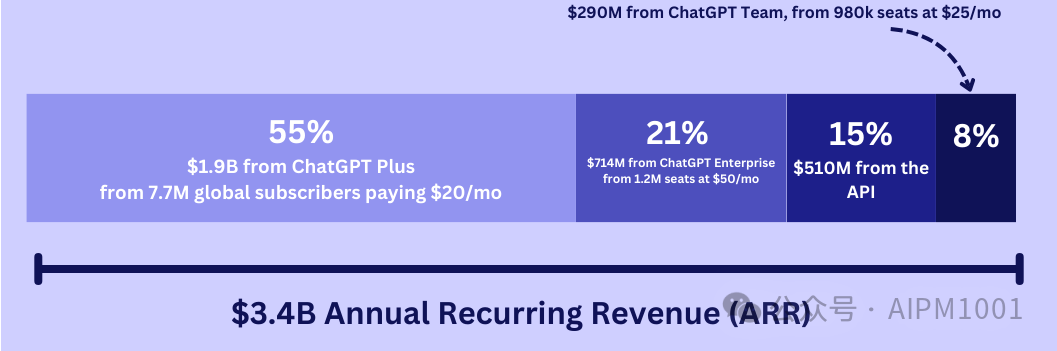
(OpenAI营收构成,来源:tooltester)
据The Information测算,在一年亏损50亿美元的情况下,OpenAI的现金流可能在未来一年内耗尽。因此,继续融资成为了OpenAI必然的选择。据彭博社消息,OpenAI目前正在商谈以1500亿美元的估值融资65亿,这一估值远高于去年10月时的860亿美元。
除此之外,首席科学家Ilya等核心人才出走,流量增长放缓,Sora“期货”迟迟未兑现,GPT-5不停跳票,大语言模型预训练Scaling Law的边际效益递减,增长空间被质疑……在OpenAI发布o1模型之前,由ChatGPT发布引领的大模型革命陷入了前所未有的低谷。
与此同时,OpenAI的主要竞争对手之一Anthropic ,从落后于 OpenAI 18 个月,在o1发布前已经在模型层面追平,甚至有微弱的领先优势了。Anthropic 6月发布的 Claude-3.5-Sonnet ,支持写200行可靠的代码,远超4o的20 行。
如下图所示,OpenAI自2022年11月ChatGPT发布以来的流量增长已经几乎停滞。
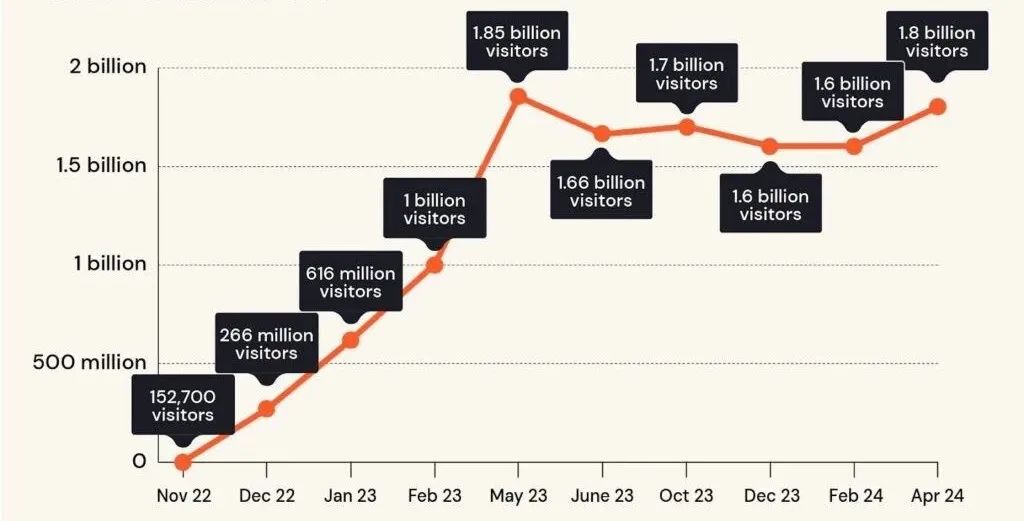
(ChatGPT访问量变化趋势,来源:tooltester)
与此相对应的,一二级市场的AI热潮正在持续降温。
一级市场方面,VC资金对AI初创公司投资占比在持续上升,占比接近30%,但是在金额上已经回落到2020年的水平,降幅明显。
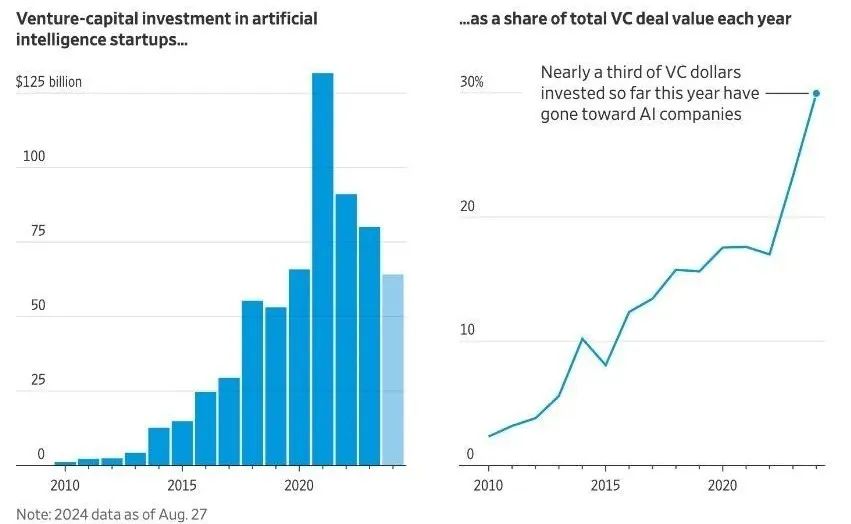
(VC对AI初创公司的投资金额和占比,来源:硅谷科技评论)
二级市场上,投资者的AI抱团追涨行情开始有了瓦解的迹象,以英伟达等公司为代表的美股AGIX指数从高点开始回落,几乎回到了半年前的水平。
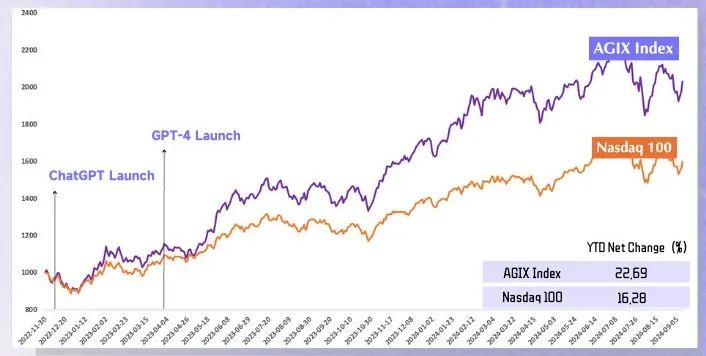
(AGI指数,来源:海外独角兽)
在这样的背景下,通过全新的大模型o1给投资人“画饼”成为了OpenAI绝佳的选择。
作为OpenAI在2023年GPT4发布以来最重要的模型更新,o1在数学、代码等方面推理能力显著提升。
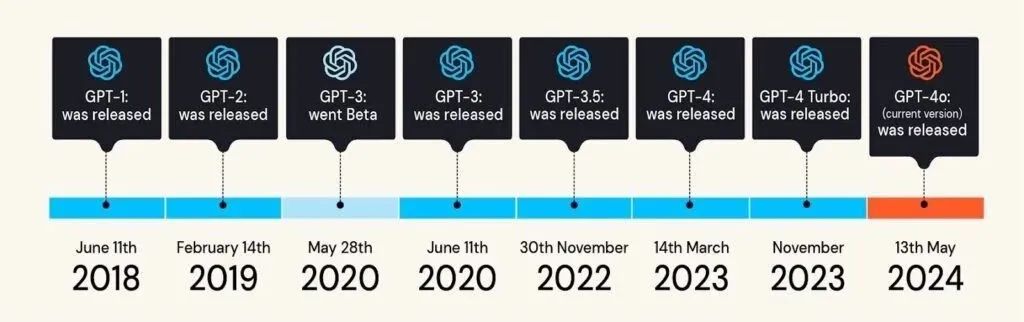
(OpenAI的主要大模型及其发布时间,来源:tooltester)
2.1 数学方面,在2024年的AIME(一个旨在挑战美国最聪明高中生的考试)测评中,GPT-4o只解决了13%的问题,o1的得分是83%。
2.2 编码方面,GPT-4o在竞争性编程问题(Codeforces)上的得分是11%,o1 是89%。
2.3 在博士级别的科学问题(GPQA Diamond),GPT4o是56.1%,o1则超越人类博士69.7%,达到了恐怖的78%。
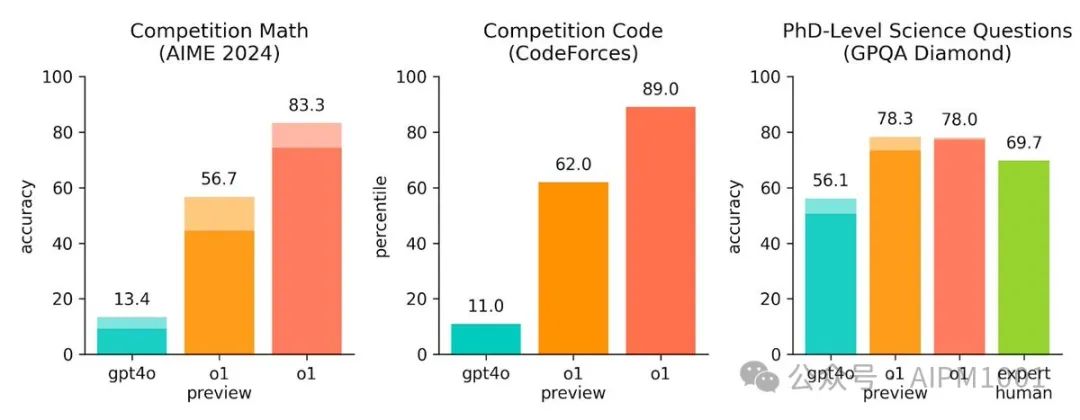
(o1与gpt4o的对比,来源:OpenAI官网)
2.4 在启用视觉感知功能时,多模态o1在MMMU上得分为78.2%,成为第一个与人类专家竞争的模型。在博士级别的科学问题上,特别是物理和化学领域,o1更是大幅领先人类博士。
2.5 在IOI(国际信息学奥林匹克竞赛)中在每题 50 次提交的条件下取得了第 49%/213分。在每题10,000次提交的情况下,该模型的得分达到了362,超过了金牌门槛。
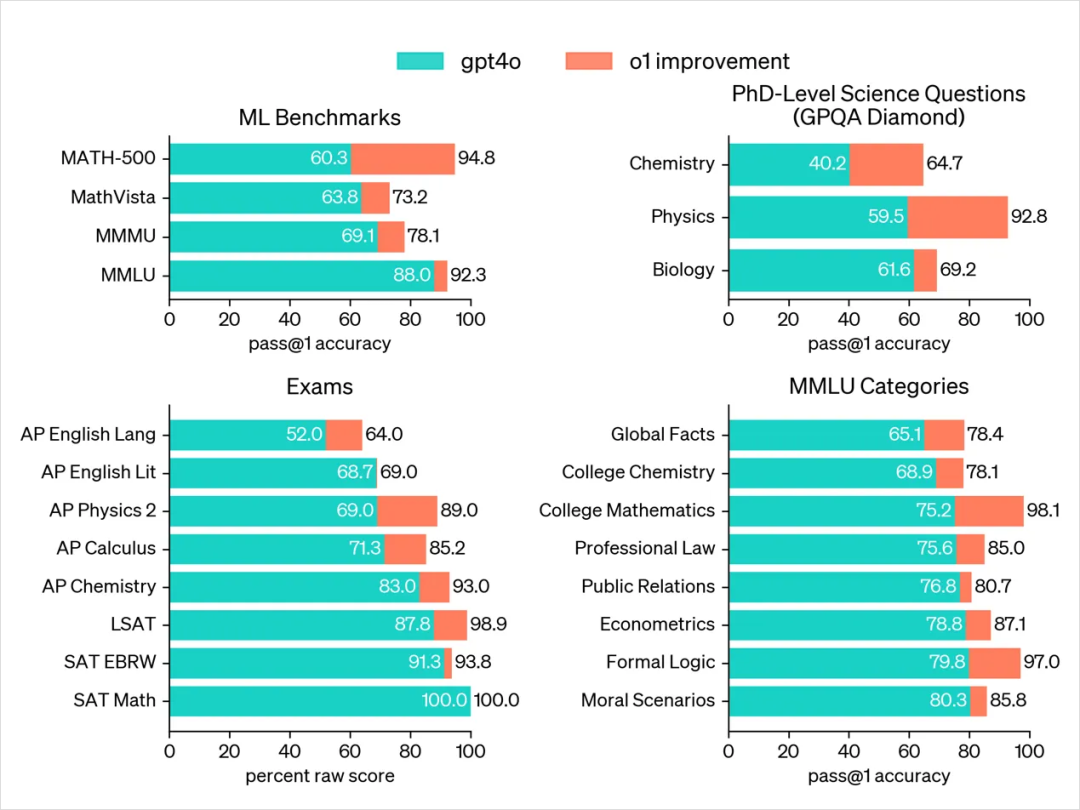
(o1与gpt4o的对比,来源:OpenAI官网)
2.6 安全性
衡量安全性的一种方法是测试模型在用户试图绕过安全规则时(称为“越狱”)是否继续遵守这些规则。在最困难的越狱测试中,GPT-4o 得分为 22/100,而o1-preview 模型得分为 84/100。
2.7 不足
通用人工智能的核心是通用和泛化性,但o1在写作、文字编辑等一些简单的自然语言处理任 务上并没有显著提升,这意味着o1的适用范围有一定的局限性。
作为首个通过大规模强化学习算法训练的模型,o1能够在回答之前深入思考问题。o1不再需要由用户输入复杂的COT提示词,而是通过强化学习的方式,将思维链内化之后进行持续训练。
通过思维链式的问题拆解,模型可以不断验证、纠错,尝试新的方法,这一过程显著提升了模型的推理能力。
o1的性能随着更多的强化学习(训练时间计算)和更多的思考时间(测试时间计算)而持续提高。
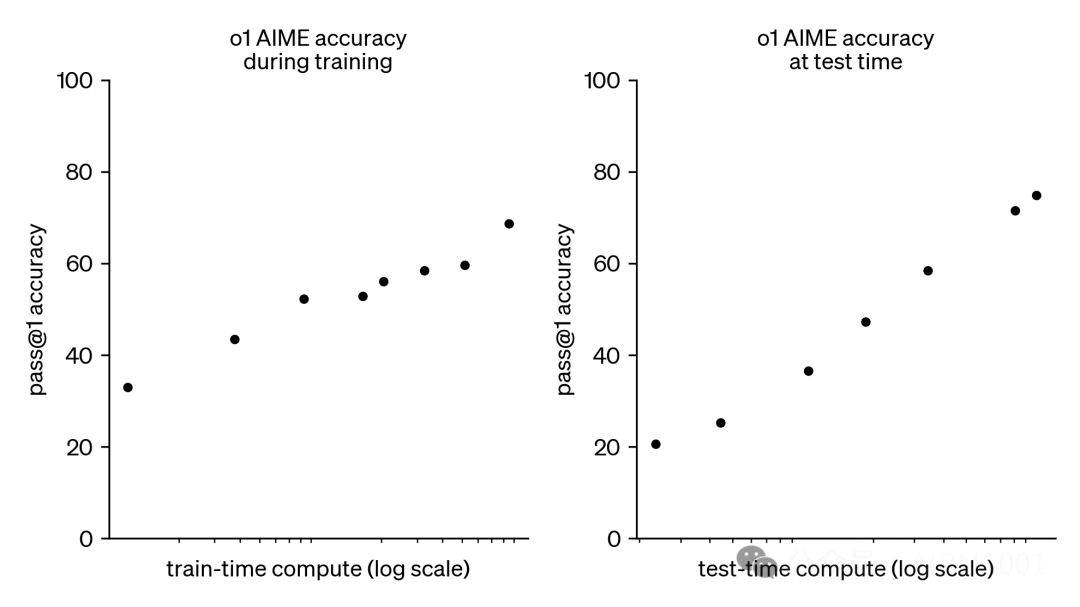
(o1 性能随着训练时间和测试时间计算而平稳提升,来源:OpenAI官网)
通过强化学习+内化思维链的方式,o1不仅在量化的推理指标上有了显著提升,在定性的推理可解释性上也有了明显的改善。可信的思维链使模型变得可解释,让用户可以用简单的英语“读懂模型的思维。
内化的思维链为监控模型提供了独特的机会。假设它是忠实且清晰的,内化的思维链允许OpenAI“读取”模型的思考过程。未来OpenAI可能希望监控思维链是否有操控用户的迹象。为了实现这一目标,模型必须能够以未经修改的形式表达其思想,因此OpenAI不能在思维链上训练任何政策合规性或用户偏好。
可以这样理解,模型进行的是系统1思维,而思维链则解锁了系统2思维。
众所周知,通过提示模型“逐步思考”可以提升大模型的性能。而通过强化学习训练,逐步拆解问题并从头到尾持续试错,将会进一步大幅提升大模型的性能。正如我们之前在围棋方面的AlphGo以及其它游戏方面的算法模型上所看到的。
系统1与系统2来自诺贝尔经济学奖得主丹尼尔·卡尼曼的《思考,快与慢》,其核心观点包括:
系统 1:快速、直观、自动的思维方式。
这种思维模式通常是无意识的,依赖于直觉和经验,能迅速做出反应。例如,看到一个熟悉的面孔时,我们几乎无需思考便能认出它。
系统 2:慢速、深思熟虑、逻辑性的思维方式。
这种思维模式需要有意识的努力和思考,用于解决复杂问题或做出深思熟虑的决策。例如,解决数学题或计划长期目标时,我们会调动系统 2 的思维。
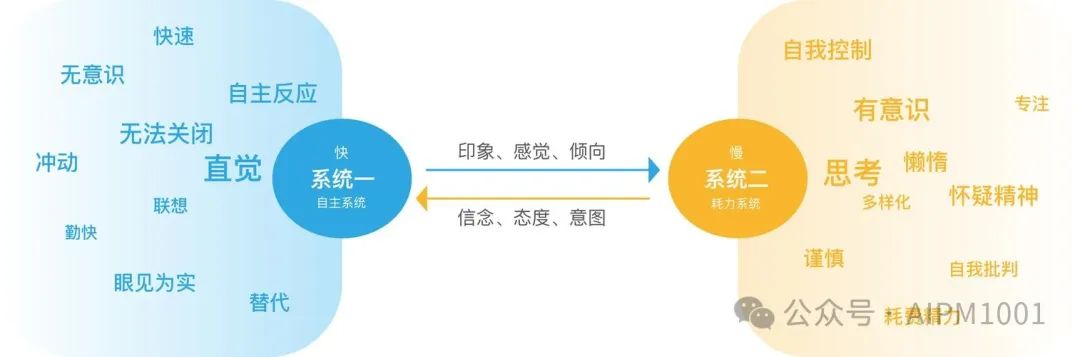
(系统1与系统2的对比,来源:简书)
案例网上很多,这里只简单提下“草莓”这个最经典的案例。
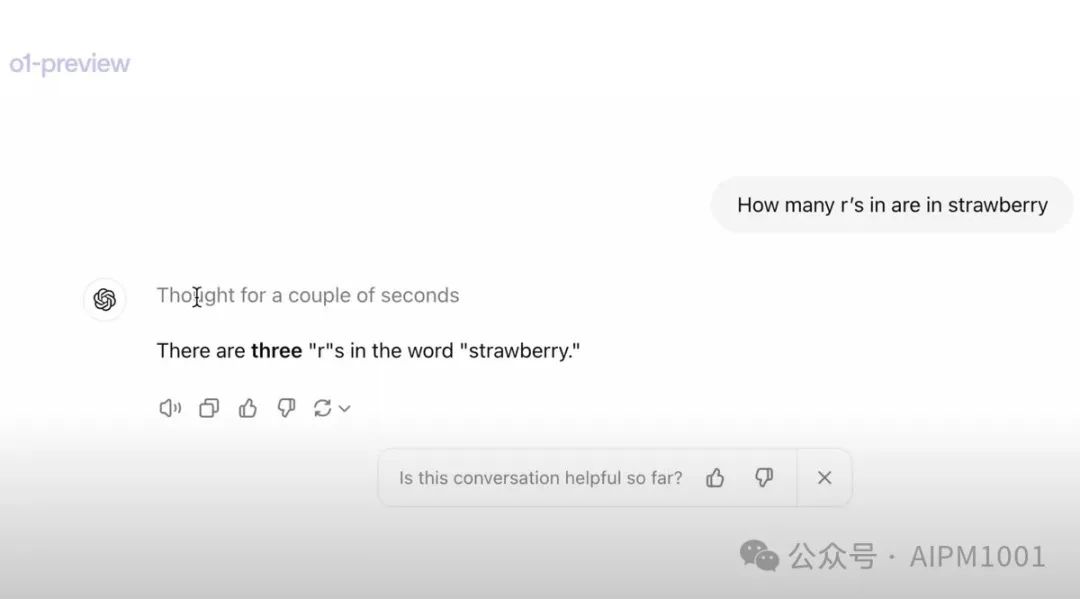
草莓的梗最初是因为人们测试GPT系列的时候,发现了模型无法数对草莓这个单词里面的r的数量。而OpenAI的新模型可以通过self-play的方式提升模型Reasoning的能力,从而数对r的数量。于是这个名叫草莓的模型就开始在网上不断发酵,并在Sam各种有意无意的暗示中升温。
6.1 正面观点
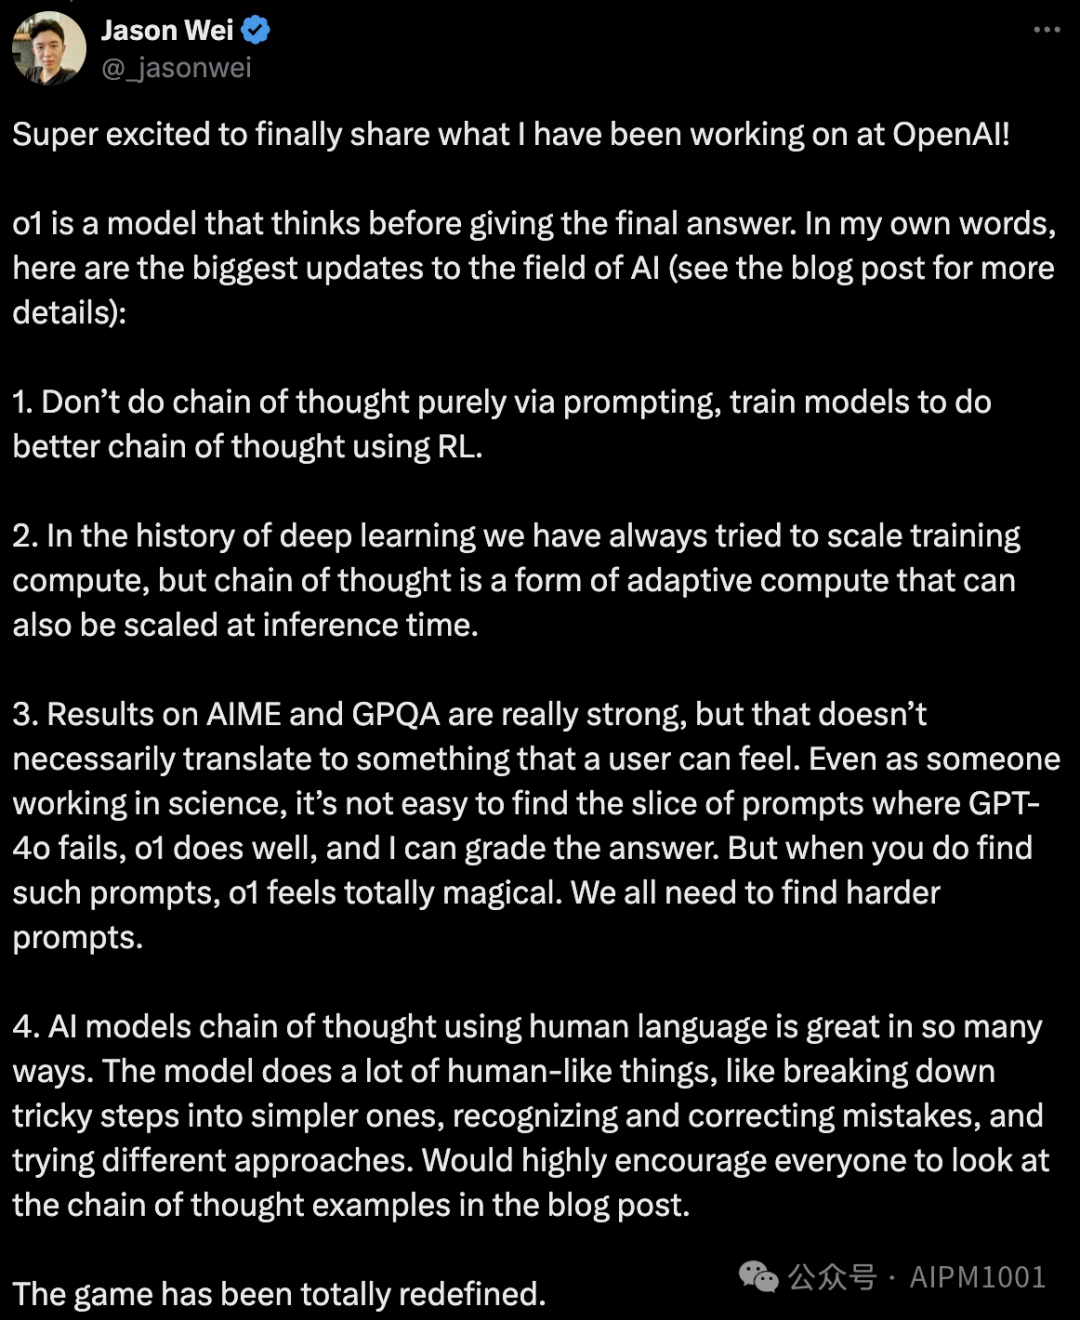
Jason Wei,OpenAI研究员,COT作者:
“通过将复杂步骤分解为更简单的步骤、识别和纠正错误,以及尝试不同的方法,o1 的表现完全令人惊叹,游戏规则已经被彻底重新定义。”
杨植麟,Kimi创始人:
“规模定律之后,大模型发展的下一个范式是强化学习。对于通用智能AGI来讲,可能会有三个层面:最底层是规模化定律,这是第一个层次的创新机会,它被OpenAI发现,并且做到极致。第二个层次的创新机会,就是Scaling law框架下有一些问题没有解决,比如怎么把所有的模态用统一的表示放到同一个模型里面去?这是第二个层次的挑战。第三层次的问题,比如能够去做更长的上下文,能够有更强的 reasoning 或者 instruction-following 。
决定这一代AI技术的上限,核心是文本模型能力的上限,如果文本模型能持续提升智商,就能做越来越复杂的任务。AI产品的能力由模型能力的决定,这和互联网时代有本质不同,模型能力不强,产品体验就不会好。AI时代的超级应用,大概率会是一个AI助理。这一代AI最大的变量,还是在生产力端。现在社会里面每一单位的生产力可能都会有十倍提升的机会。”
肖仰华,复旦计算机科学技术学院教授、博导:
“o1模型的出现意味着大模型的推理能力完全能够达到专家级水平,算得上是人工智能里程碑式的进展,将给模型在企业端的应用带来极大的提升。但随着模型在知性、感性和理性三方面的能力均不断提升后,其将超越人类的能力,未来人工智能将对人类产生何种影响还很难预测,人工智能的发展速度现在超过了人类对其认知的速度,人工智能治理将是一个巨大挑战。
大规模强化学习算法教会模型如何在训练过程中有效使用其思维链进行思考,o1模型可以在回应用户之前产生一个很长的内部思维链。以前的大语言模型更像一个文科生,距离理科生的水平仍然较远。但人类智能的核心能力是思考和思维,OpenAI新推理模型o1系列将人的思维过程展现出来。
我们发现o1的表现超过了一些人类专家,成为第一个在这个基准上做到这一点的模型。这些结果并不意味着o1在所有方面都比博士更有能力,只是模型在解决博士需要解决的一些问题方面更熟练。人类目前对人工智能基本认知框架都有所欠缺,这是一个巨大的治理挑战,就业、经济、伦理、社会关系等话题将引起广泛讨论。”
6.2 负面观点
复旦NLP实验室:
“博士级”模型GPT-o1折戟中学数学“陷阱”问题,准确率仅为24.3%
我们的最新研究结果却给这个”AI天才”泼了一盆冷水——在面对中学数学水平的”陷阱”问题时,GPT-o1惨遭滑铁卢:在我们最新的中学陷阱问题测试集MathTrap_Public上,调用GPT-o1-preview官方API后生成的回答准确率仅为24.3% 。
我们在 GSM8K 和 MATH 数据集问题的基础上,加入了一些“陷阱”,构造了 MathTrap 数据集。这些改编后的题目很多时候没有定义明确的答案或者无解,只有能够同时理解原题和“陷阱”所涉及知识的模型,才能找出其中的矛盾点,发现“陷阱”所在。
因此,单靠“刷榜”来提高在 GSM8K 和 MATH 上的成绩,是没办法在 MathTrap 上取得好成绩的,因为这些模型缺乏质疑题目条件的能力。
相关研究:Exploring the Compositional Deficiency of Large Language Models in Mathematical Reasoning Through Trap Problems
论文链接:https://arxiv.org/pdf/2405.06680
7.1 ChatGPT付费用户
ChatGPT Plus和Team用户从9月12日可以开始在ChatGPT中访问o1模型。o1-preview和o1-mini可以在模型选择器中手动选择,o1-preview的每周消息限制为50条,o1-mini 为每天50条。ChatGPT Enterprise 和 Edu 用户将在下周开始访问这两个模型。
符合 API 使用等级 5 的开发者可以立即开始在 API 中使用这两个模型,限制为每分钟 20 次请求。OpenAI还计划将 o1-mini 的访问权限扩展到所有 ChatGPT 免费用户。
详见https://openai.com/index/introducing-openai-o1-preview/
7.2 非ChatGPT付费用户
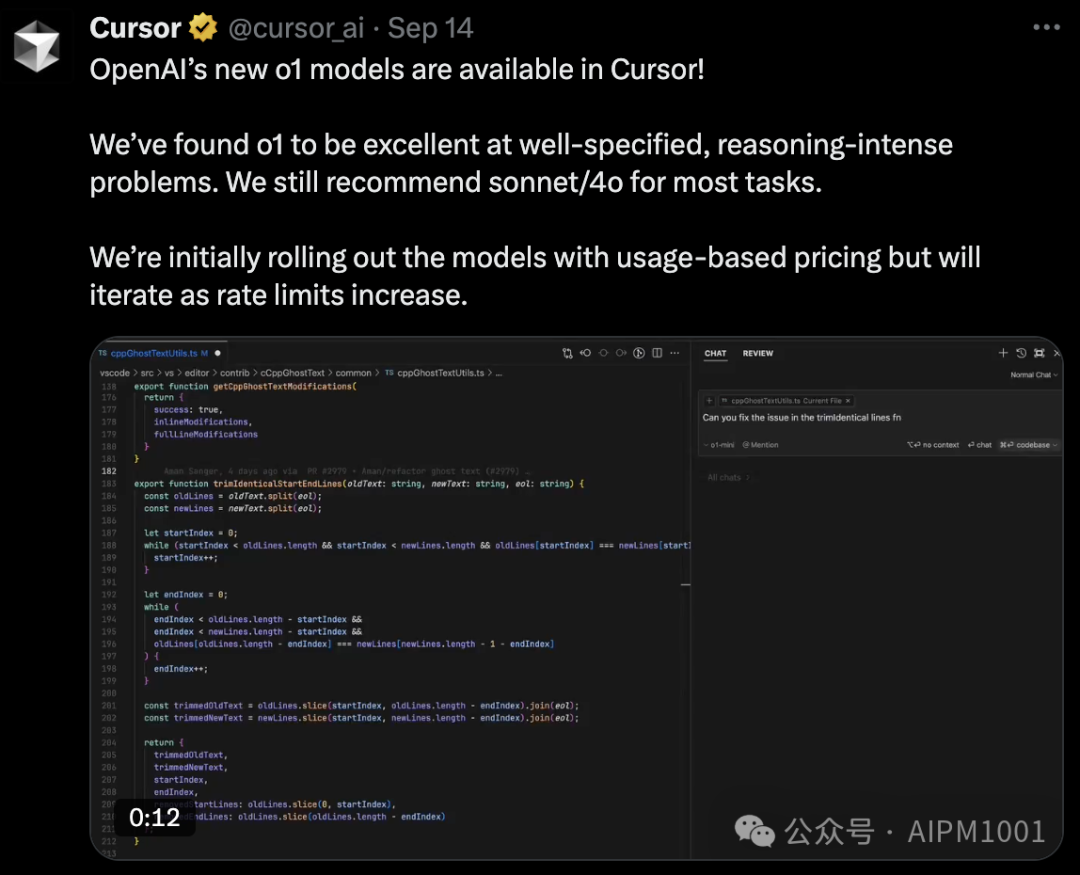
Cursor已经支持了最新的o1模型,没有ChatGPT会员权限的可以通过这个产品进行体验。
8.1 对大模型行业的影响
新的Scaling Laws —— Post-Training Scaling Laws(后训练扩展定律)已经出现,并可能引发行业对于算力分配、后训练能力的重新思考。
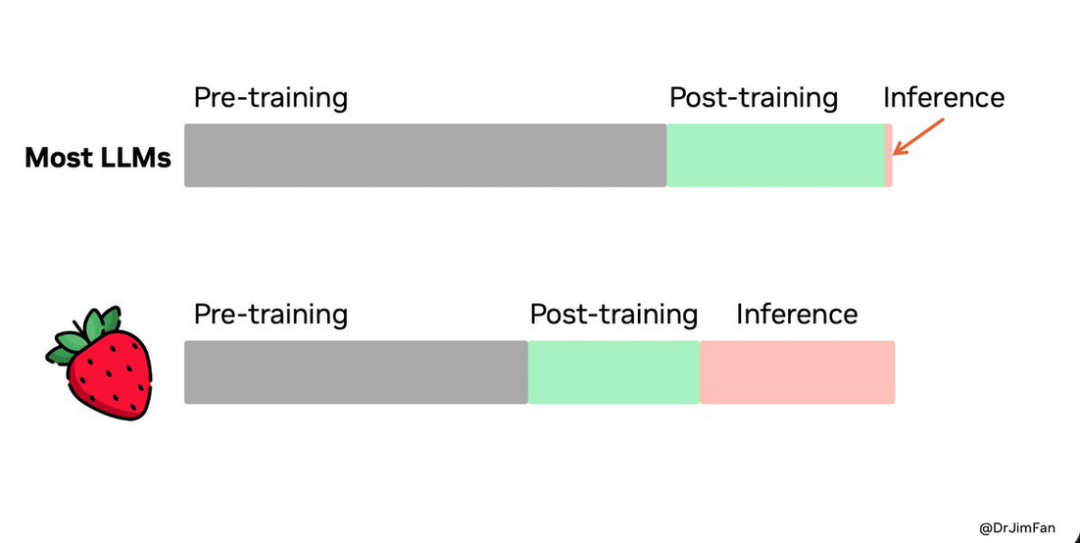
o1 模型的发布,意味着 AI 能力的提升不再局限于预训练阶段,还可以通过在 Post-Training 阶段中提升 RL 训练的探索时间和增加模型推理思考时间来实现性能提升,即 Post-Training Scaling Laws。
数据飞轮 + Bootstrap -> SuperIntelligence : 基于自我反思的模型将能够实现自举 Bootstrap,并提升大大提升模型对于未见过的复杂问题的解决能力,模型的推理过程形成大量高质量数据的飞轮,并最终有可能向 SuperIntelligence 更进一步。
8.2 AI能力的等级跃迁
AI开始具备推理能力,且复杂问题的解决能力可以与人类相媲美,这意味着AI从仅能利用工具和规则的 Level 1 水平开始进化到了 Level 2 的阶段,并向第3阶段开始探索。
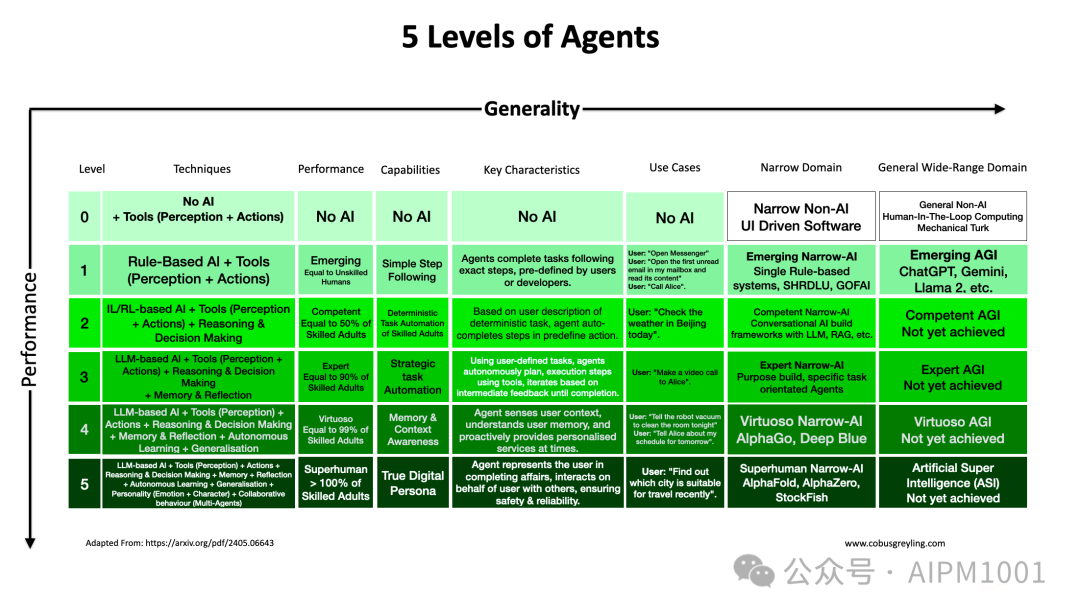
(5 Levels Of AI Agents,来源:cobusgreyling)
8.3 对从业人员的影响
1)AI产品经理的危与机
危:一方面,随着o1将思维链内化进模型,大幅降低了提示词工程的难度。这意味着AI产品经理未来大概率不再需要设计复杂的提示词,刚刚兴起1年多的“提示词工程师”岗位风雨飘摇,AI产品经理也同样将因此受到很大的冲击。
之前解决复杂问题,需要人写非常复杂的Prompt,而o1本质上是COT等复杂Prompt的自动化,所以之后是不需要用户自己构造复杂Prompt的。
机:另一方面,随着o1代码能力的大幅提升,代码编写的门槛得到了一定程度的降低,AI产品经理有机会设计、开发、上线一条龙完成,大大提升AI产品MVP迭代的效率。
2)工程
虽然AI取代工程开发还言之尚早,但大模型在短时间内的进步之大还是让人震惊,初级开发的门槛与AI越来越模糊。也许在不远的将来,英文就将成为最流行的编程语言。
而短期来说,工程开发的效率有望借助o1模型和Cursor等工具产品进一步提升。
3)算法
虽然强化学习算法在InstructGPT的论文中就已经被提及,但之前更多是作为RLHF基于人类反馈的强化学习的视角进行切入,很少作为单独的方向被重点提出。
o1模型发布后,强化学习的重要性大大提高,其在大模型领域的应用有望成为接下来一段时间国内大模型公司混战的新焦点。
1.1 强化学习
机器学习算法主要分为监督学习、无监督学习和强化学习三类。无监督学习相当于学生自学,没有任何老师指导,完全依靠学生自己琢磨;监督学习相当于有老师指导,有明确对错的学习;强化学习则是做对题目有奖励,做错题目有惩罚的学习。
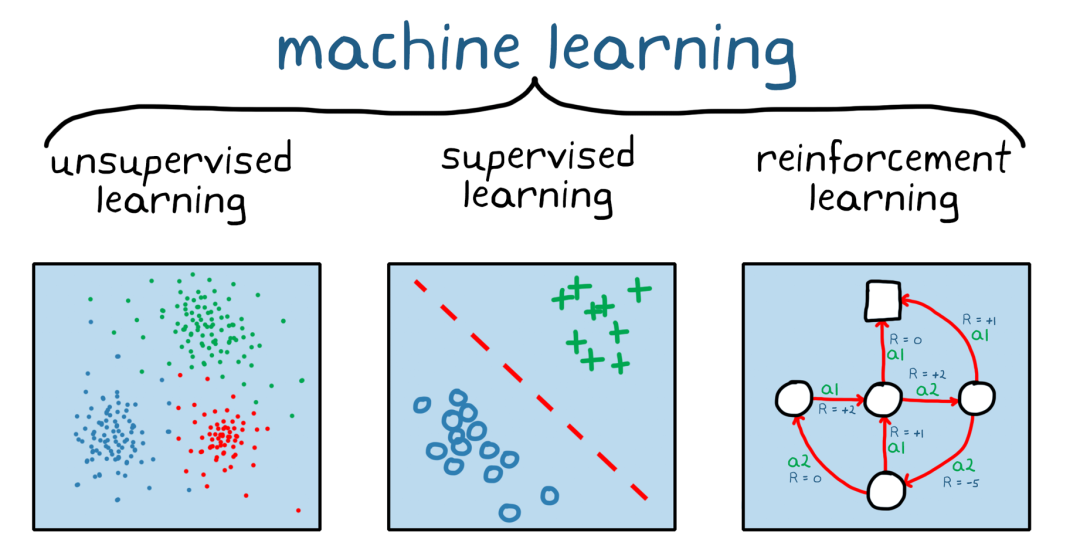
强化学习(Reinforcement Learning,RL)是一种基于反馈的学习方法,对算法执行的正确和不正确行为分别进行奖励和惩罚的制度,目的是使算法获得最大的累积奖励,从而学会在特定环境下做出最佳决策。“强化”一词来自于心理学,心理学中的“强化”就是通过提供一种刺激手段来建立或者鼓励一种行为模式。这种“强化”具体分为两种:
积极强化,是指在预期行为呈现后,通过给予激励刺激以增加进一步导致积极反应。
负面强化,通过提供适当的刺激来减少出现负面(不希望的)反应的可能性,从而纠正不希望出现的行为。
想象一下,当你第一次自己玩超级马里奥,你需要在游戏中不断探索环境和重要的NPC,一个错误的举动会导致失去一条“命”,一个正确的跳跃可以把我们带到一个更安全的地方获得金币奖励!在n次奖励和惩罚的探索之后,你对于马里奥游戏的熟练程度越来越高,操作的正确性大大提升,最终成为一个该游戏的高手。
1.2 Self-play
Self-play 是 AlphaZero 等强化学习算法的合成数据方法,最早可以追溯到 1992 年的 TD-Gammon 算法,其本质是利用 AI 无限的计算能力来补足它数据利用效率不够的短板。
以 AlphaZero 为例,在每一局对弈中,模型使用蒙特卡洛树搜索(Monte Carlo Tree Search,MCTS)来选择动作。MCTS 结合了当前神经网络提供的策略(policy)和价值(value),从而在每个游戏状态下评估出最优的行动。其具体步骤如下:
1) 随机初始化:模型从完全随机初始化的状态开始,没有任何人类先验知识。
2) self-play:模型自己与自己进行对弈,生成大量的游戏数据。其中好的结果用于更新模型的参数。
3) MCTS:在每一次对弈中,AlphaZero 会使用 MCTS 来搜索最佳动作。MCTS 使用策略网络 (policy network) 提供的动作概率分布和价值网络提供的局面评估结果来引导搜索。
4) 策略更新:根据自我对弈的结果,使用强化学习的方式来更新神经网络的参数,使得模型逐步学习到更优的策略
1.3 Self-play强化学习、RLHF
早在2018 年,Ilya Sutskever就认为强化学习与 self-play 是通往 AGI 路上最关键的方法之一。Ilya 用一句话概括了强化学习:让 AI 用随机的路径尝试新的任务,如果效果超预期,那就更新神经网络的权重,使得 AI 记住多使用这个成功的事件,再开始下一次的尝试。
1)传统强化学习与self-play的区别:传统强化学习与今天的 self-play 强化学习相比,最大的区别是强化学习算法模型(如AlphaZero)是一个千万参数的神经网络,和今天的语言模型相差 3-4 个数量级。
2)Self-play 强化学习与RLHF 的区别:RLHF 的目的不是获取机器智能,而是人机对齐,使得 AI 能够更像人,但不能超越人成为超级智能。简单来说:RLHF 像人类一样,更喜欢好理解的东西,而不是喜欢逻辑更严密的内容。而 self-play 强化学习的目标是如何提升逻辑能力,绝对强度更高,甚至超越最强人类、专家。
3)RLHF 的核心是通过强化学习训练语言模型,但由于缺乏奖励函数这一必要因素,因此需要通过收集人类的反馈来学习一个奖励函数。
4)强化学习不是一个模型,而是一整套的系统,其中包含了很多因素,第一,强化学习包括了智能体,其中的 agent 就是模型。第二,包括了环境,环境可能是狗主人的家,也可能是编程环境,也可能是垂直领域。第三,包括了动作,是狗坐下,还是一些其他模态的输出。第四,包括了奖励模型,这也很重要。最重要的两个因素是环境和智能体。智能体的目标是得到更多奖励。
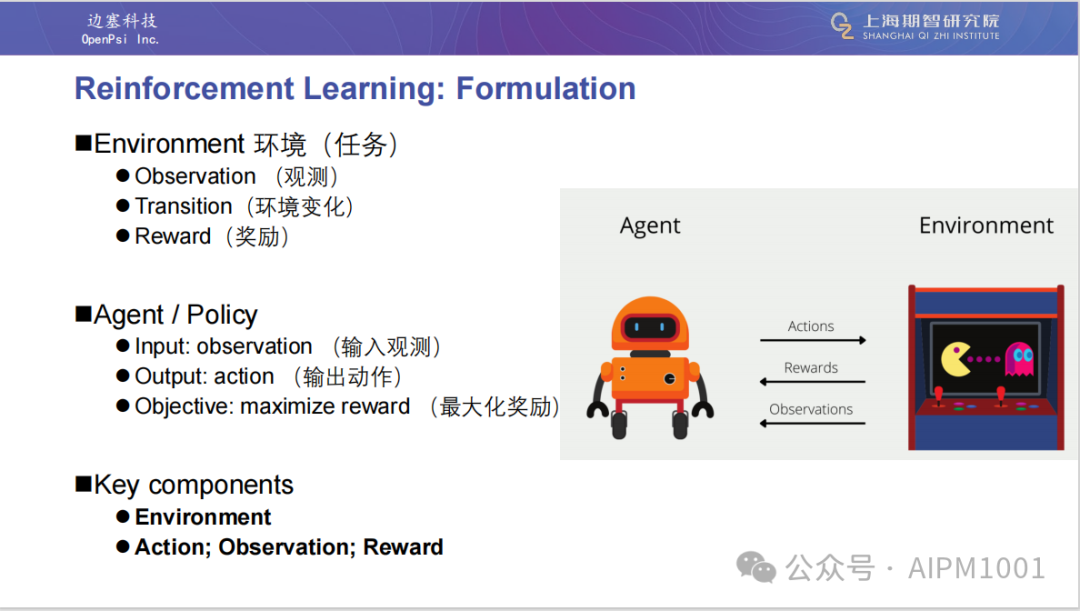
(强化学习构成,来源:海外独角兽)
强化学习在语言模型中的思路,本质上是 inference time 换 training time 。
1.4 为什么 RLHF 的效果优于 SFT?
PPO 算法的提出者是Berkeley PhD,OpenAI前研究员 John Schulman,他针对 RLHF PPO 提出了两个观点:
第一,SFT 会导致 hallucination :
John Schulman 认为,大型模型之所以会产生幻觉,是因为它们在 SFT 阶段学到了一些不正确的认知。SFT 过强的监督信号导致人类实际上在引导 ChatGPT 说它不知道的东西。还有一种可能性,即 GPT 实际上知道答案,但标注人员不知道。
第二,RLHF 让大模型“知道”自己“确实不知道”。
RLHF 的过程不仅帮助模型意识到不确定性,更重要的事情是 RLHF 帮助模型提高了 reasoning 能力。
只有通过正向和反向的双重实验,我们才可以判断这种药物对头痛有效。如果只有正向的例子,例如说患者吃了感冒药,感冒变好了,并不能证明感冒药能治好感冒。只能说明,感冒药与患者感冒的好转有一定相关性。而 RLHF 正是成功利用了负向数据,使得模型有机会真正掌握因果性。
总结来说,RLHF 有以下优势:
使用 negative signal 进行对比学习,通过对比的过程可以帮助模型降低 halluciation。
强化学习不是一个固定的过程。它允许模型随着能力的不断提升,通过不断地问问题、给出答案、评判,从而让模型不停地从当前能力的边界进行主动探索,并不断拓宽自己的能力边界。
这两个因素共同作用能够形成 counter-factual reasoning 的作用,有可能解锁因果学习(casual learning)的巨大潜力,让模型具备更强的 reasoning 能力。
1.5 PRM与ORM
PRM(Process reward model)是奖励好的推理步骤,而不仅仅是正确的结果。这更接近人类的学习和推理方式,实现方式常常是用 COT 来表示推理过程,对每一步进行打分。这是因为 LLM 的语义理解能力才成为可能的。在传统 RL 中,我们按照最终结果评分,其评分模型称为 ORM(outcome reward model);而通过专门训练 LLM 成为 process verifier ,新的评分模型叫做 PRM,往往是使较小 LLM fine-tune 得到。
OpenAI 的 verify step-by-step 也是最近最重要的 paper 之一。他们训练的 PRM 在解决 MATH 数据集测试集中 78.2%的问题时表现优于 ORM。在今年 Google Research 的一篇 paper 中提到,PRM 在过程中一旦成功发现第一个错误,就能使 RL 训练效果显著提升。
1.6 Critic Model
随着任务复杂度的提高,仅仅依靠模型的自身推理能力可能无法提供有效的奖励信号。这使得对于模型内部的复杂推理过程的监督变成了一个可扩展监督问题。
具体来说,o1的隐式思维链的训练过程中应当也引入了Critic的方法。通过将推理过程进行过程分解,并且利用额外的更强更专项的Critic Model,可以将推理过程的监督扩展到更复杂的问题上。这也一定程度缓解了仅仅是通过推理过程能否导出正确结果的来确定奖励信号的稀疏问题。
OpenAI的CriticGPT通过RLHF方法训练模型能够为真实世界中的代码任务书写自然语言反馈,并成功泛化到OOD(模型在训练过程中没有遇到过的数据)的分布上。这种反馈可以用来帮助人类进行更准确的评价,从而实现对于复杂输出的有效奖励反馈。
2.1 OpenAI官方的“提示”
通过强化学习,o1 学会了精炼其思维链并优化所用的策略。它学会了识别并纠正错误,将复杂的步骤分解为更简单的部分,并在当前方法无效时尝试不同的途径。这一过程显著提升了模型的推理能力。
o1 模型引入了推理标记。模型使用这些推理标记进行“思考”,分解对提示的理解并考虑多种生成响应的方法。生成推理标记后,模型会将答案生成为可见的完成标记,并从其上下文中丢弃推理标记。
以下是用户与助手之间多步骤对话的示例。每个步骤的输入和输出标记都会被保留,而推理标记则会被丢弃。
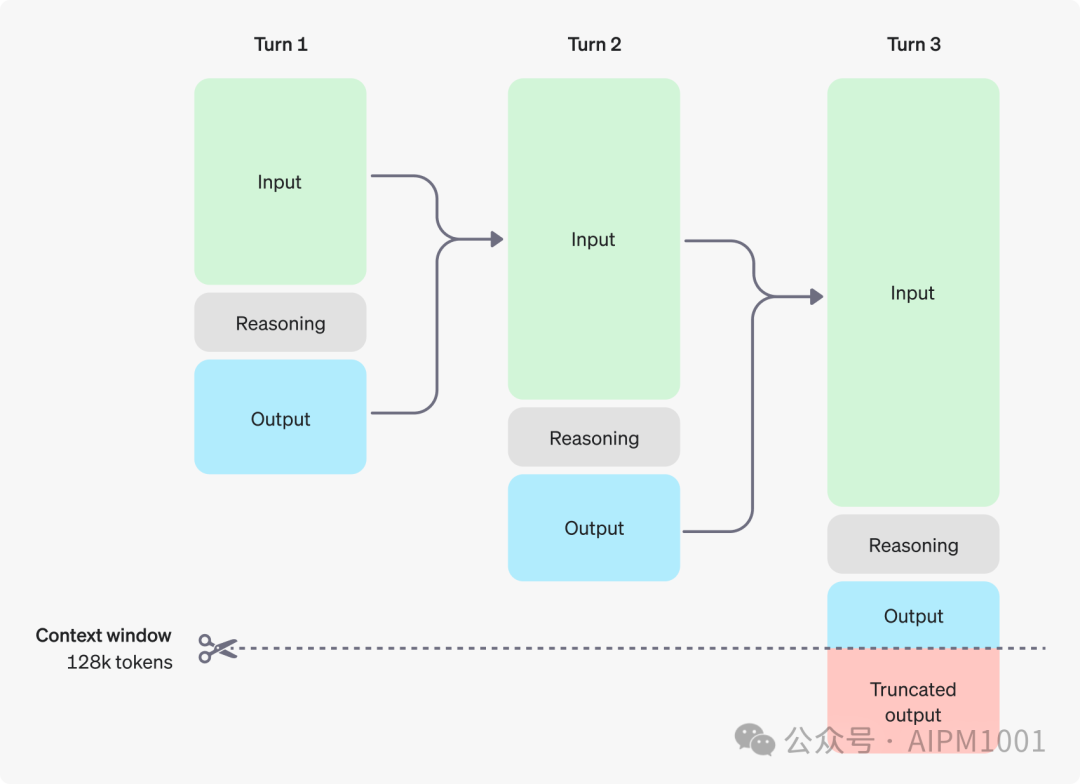
(推理是如何进行的,OpenAI官网)
2.2 猜想1
张俊林:MCTS搜索技术路线
OpenAI o1提到了关于RL在训练和推理时候的Scaling law,并指出这与预训练时候的Scaling law具有不同特性。很明显,如果o1走的是MCTS搜索技术路线,那么把COT拆分的越细(增加搜索树的深度),或提出更多的可能选择(节点的分支增多,就是说树的宽度越宽),则搜索空间越大,找到好COT路径可能性越大,效果越好,而训练和推理的时候需要算力肯定越大。看上去有着效果随着算力增长而增长的态势,也就是所谓的RL的Scaling law。这其实是树搜索本来应有之义,我倒觉得把这个称为RL的Scaling law有点名不副实。
2.3 猜想2
腾讯科技 周小燕 郝博阳:PRM仅在答案不可接受时进行MCTS式的搜索,或者用的是更节约的Beam Search。
从反应时间和token消耗两方面看,根据Hackernews上使用了API的开发者推算,o1进行推理所消耗的token是其给出答案token的10倍,是未进行思维链的GPT-4o mini 所用token的60-100倍。如果采用能看三步的、每步形成5个候选,单层深度的Lookahead Search就会消耗45倍token。但用到了思维链每步都需要进行一次Lookahead Search的话,就会远超100倍token。另外考虑到MCTS这么大的计算量,目前o1的反馈时间是远远不够的。
但如果仅用思维链,即使是非常复杂的问题,token消耗最多也就是达到5-10倍。其60倍token消耗又太大了。
2.4 猜想3
北大对齐团队:o1运用的技术关键还是在于强化学习的搜索与学习机制,基于LLM已有的推理能力,迭代式的Bootstrap模型产生合理推理(Rationales)的能力,并将 Rationales 融入到训练过程内,让模型学会进行推理,而后再运用足够强大的计算量实现Post-Training阶段的Scaling。类似于STaR的扩展版本。
模型学习的是产生合理推理的过程,MCTS 在其中的作用是诱导合理推理过程的产生或构建相应的偏序对形成细粒度奖励信号,而非直接搜索过程和最终答案。
为了优化这一过程,产生了一系列方法,其中包括在 Token 级别或子句级别提供奖励信号,帮助模型调整生成的回答。这些方法如MCTS,将输出建模为一系列节点,这些节点可以是 Token 级别或句子级别。例如:
Token 级别的节点:每个节点对应生成序列中的一个 Token。通过 MCTS,模型可以探索不同的 Token 序列,最终生成更连贯的响应。
句子级别的节点:在复杂推理任务中,每个节点可以代表一个完整的句子或推理步骤,帮助模型更好地处理多步推理任务。
3.1 Jason Wei 的 Chain-of-Thought Prompting Elicits Reasoning in Large Language Models,也就是著名的COT。
主要内容:通过一系列中间推理步骤,能显著提高大型语言模型执行复杂推理的能力,提出了一种名为“chain of thought prompting”的方法,通过提供几个思维链条示例,无需对模型进行微调,就能自然地激发大型语言模型的推理能力,实验结果表明该方法在算术、常识和符号推理任务上显著提高了三种大型语言模型的表现。
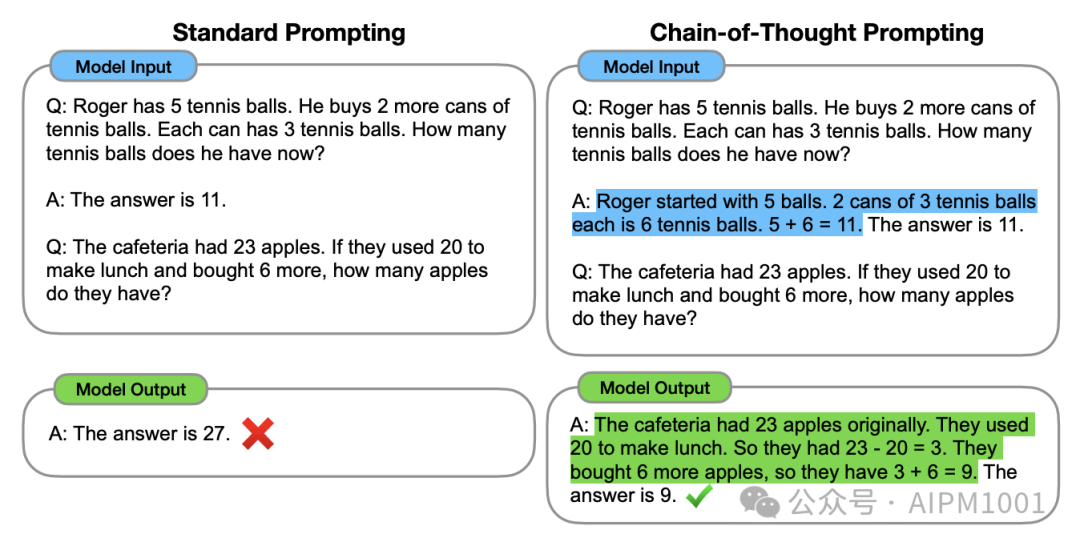
链式思维推理能力的涌现:链式思维推理能力并非所有模型都具备,而是随着模型规模的扩大而逐渐涌现。对于需要多步推理的任务,链式思维提示能够显著提升模型性能,尤其是在大型语言模型上表现尤为突出。
该方法也为提升模型可解释性和鲁棒性提供了新的思路。
CoT 通过分步推理的方式,要求模型在生成最终答案之前,先生成一系列中间推理步骤。这种 “思考链” 的生成过程有助于增强模型的推理能力,尤其在数学和代码生成等任务中表现出色。
然而,CoT虽然能够生成中间步骤,但并未教会模型如何从内部深入思考问题的关联。特别是对于尤其复杂且需要多步推理规划的任务,这样的合理的中间 CoT 推理过程(Rationales) 更为重要。
3.2 Ilya等人的Let’s Verify Step by Step
主要内容:比较了两种训练大型语言模型进行复杂推理的方法:结果监督和过程监督,并得出以下主要贡献:
1)过程监督比结果监督更有效
研究表明,过程监督训练出的奖励模型比结果监督更可靠,能够解决 MATH 数据集 78.2% 的问题,而结果监督只能解决 66.4%。过程监督提供了更精确的反馈,指出了错误发生的具体位置,有助于模型更好地进行信用分配和学习。
2)大型奖励模型可以有效地近似人类监督
研究发现,大型奖励模型可以有效地近似人类监督,用于训练小型奖励模型,从而降低了数据收集的成本。这为大规模数据收集消融实验提供了可能性,并可以用于评估不同监督方法的效果。
3)激活学习提高了过程监督的数据效率
研究发现,激活学习可以将过程监督的数据效率提高 2.6 倍,这意味着可以使用更少的数据获得更好的模型性能。激活学习通过选择最有价值的模型输出进行人工标注,从而提高了数据收集的效率。
4)发布了 PRM800K 数据集
论文发布了 PRM800K 数据集,包含 800,000 个步骤级别的标注数据,用于训练奖励模型。
3.3 斯坦福&谷歌STaR: Bootstrapping Reasoning with Reasoning
1)主要原理
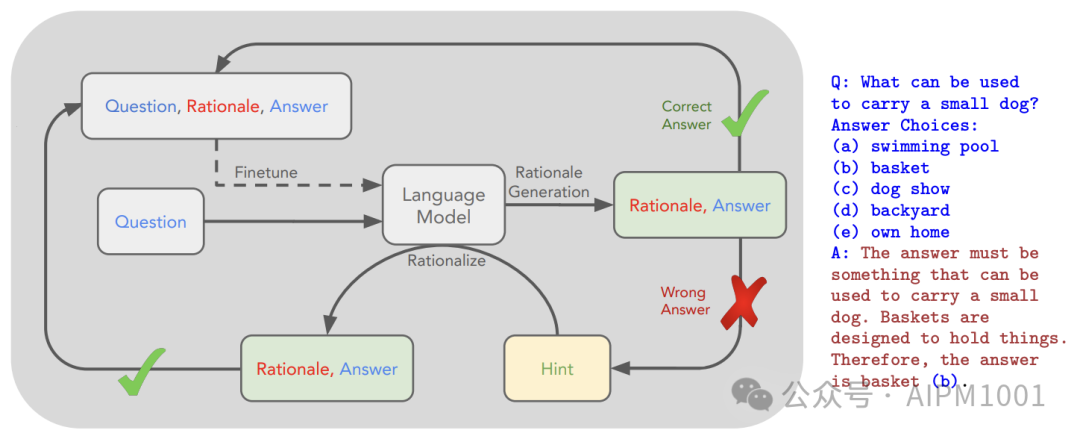
STaR 的核心思路是利用 LLM 已有的推理能力,迭代式的 Bootstrap 模型产生合理推理过程(Rationales) 的能力,并将 Rationales 融入到训练过程内,让模型学会进行推理。其基本流程如下:
推理:起始数据集仅有 [Question, Answer] ,首先利用一些带有推理过程的 Few-Shot Examples 来 Prompt 模型对于数据集中的问题生成对应的推理过程和答案。
过滤:如果生成的答案正确,则将推理过程加入到原有的数据集中;如果生成的答案错误,则尝试在给出正确答案的前提下再次生成推理过程。将最终生成正确答案的推理收集,构建一个构建一个微调数据集 [Question, Rationale, Answer ] 进行微调。
迭代:重复这一过程,且每次获得一个新的数据集,都从原始的模型开始进行 Fine-tune 从而防止过拟合。
2)创新点
迭代引导:STaR 不需要构建大规模的推理链数据集,而是通过少量示例引导 LLM 生成自身的推理链,实现自我提升。
Rationalization 技术:STaR 引入了 Rationalization 技术,通过提供正确答案作为提示,帮助 LLM 生成新的推理链,克服了正向推理训练的局限性,能够从失败案例中学习。
3)STaR 的优势
提升推理能力:STaR 能够有效提升 LLM 在数学推理、常识推理等复杂任务上的性能。
降低数据需求:STaR 不需要大规模的推理链数据集,降低了数据获取的难度和成本。
提高鲁棒性:STaR 能够让 LLM 从失败案例中学习,提高其在复杂问题上的鲁棒性。
4)STaR 的局限性
初始模型要求:STaR 需要初始模型具有一定的推理能力,否则难以启动引导过程。
对少样本示例的依赖:STaR在推理任务中高度依赖少量的Few-Shot推理示例,这导致模型的推理能力较为有限,难以应对复杂和广泛的任务。
泛化能力受限:STaR虽然能够通过迭代的方式提升模型的推理能力,但其应用主要局限于特定的结构化任务(如问题回答),难以在开放域或任意文本生成任务中取得同样的效果。
数据质量影响:STaR 的性能受初始推理链质量的影响,如果初始推理链存在偏差,则可能导致 STaR 学习到错误的推理模式。
解释忠实度:STaR 生成的推理链可能无法完全反映 LLM 的内部推理过程,存在解释忠实度的问题。
5)STaR 与强化学习目标的相似之处
迭代更新:STaR 和强化学习都采用迭代的方式更新模型,不断优化其性能。
奖励信号:STaR 通过迭代的方式生成推理链,并使用正确答案作为反馈信号,类似于强化学习中的奖励信号,用于指导模型的更新方向。
6)STaR 与强化学习目标的区别
目标函数:STaR 的目标函数与强化学习中的策略梯度目标不完全相同,STaR 更关注推理链的生成和优化。
模型结构:STaR 使用预训练的 LLM 模型,而强化学习可以采用各种类型的模型。
训练方法:STaR 使用基于梯度的方法进行模型更新,而强化学习可以采用多种训练方法,例如 Q-learning、Sarsa 等。
3.4 微软的 rStar:Mutual Reasoning Makes Smaller LLMs Stronger Problem-Solvers
1)主要贡献
rStar 是一种创新的self-play自我推理方法,旨在提升小语言模型 (SLM) 的推理能力,无需微调或高级模型的支持。其核心思想是将推理过程分解为 生成 和 鉴别 两个阶段,并通过自我博弈的方式实现 SLM 之间的相互学习。
2)主要创新点
丰富的推理动作:rStar 引入了五种人类似推理动作,模拟人类在推理过程中的行为,这使得 SLM 能够生成更高质量的候选推理轨迹,有效探索解决方案空间。
相互一致性鉴别:rStar 使用另一个与目标 SLM 能力相似的 SLM 作为鉴别器,对生成的候选推理轨迹进行评估。鉴别器通过完成部分推理步骤并提供反馈,帮助目标 SLM 选择更可靠的推理路径。
无需微调或高级模型:rStar 不依赖于微调或高级模型的指导,能够独立提升 SLM 的推理能力,使其在无需额外资源的情况下获得显著的性能提升。
实验结果表明,rStar 能够有效解决多种推理问题,并在多个 SLM 上取得了显著的性能提升。例如,在 GSM8K 数据集上,rStar 将 LLaMA2-7B 的准确率从 12.51% 提升至 63.91%,将 Mistral-7B 的准确率从 36.46% 提升至 81.88%。
A. 生成阶段 (MCTS Rollout):
动作空间: rStar 引入了五种人类似推理动作,模拟人类在推理过程中的行为:
A1: 提出一个一步思考。
A2: 提出剩余的思考步骤。
A3: 提出下一个子问题及其答案。
A4: 再次回答子问题。
A5: 重述问题/子问题。
MCTS 搜索: 使用 MCTS 算法,根据当前状态和动作空间,逐步生成候选推理轨迹。
奖励函数: 设计 SLM 定制奖励函数,根据推理步骤对最终答案的贡献程度进行评估,并指导 MCTS 树的扩展。
这些动作帮助模型更好地探索解决方案空间的原因:
多样性: 丰富的动作类型使得模型可以尝试不同的推理策略,避免陷入固定的思维模式。
灵活性: 模型可以根据当前状态选择合适的动作,灵活应对不同的问题。
分解: 通过将复杂问题分解为子问题,模型可以逐步解决,降低推理难度。
验证: 通过重新回答子问题,模型可以验证子问题的答案是否正确,提高推理的准确性。
B. 鉴别阶段 (Mutual Consistency):
鉴别器 SLM: 使用另一个与目标 SLM 能力相似的 SLM 作为鉴别器,对生成的候选推理轨迹进行评估。
部分提示: 将候选推理轨迹的一部分作为提示,让鉴别器完成剩余的推理步骤。
一致性验证: 比较鉴别器完成的推理步骤与原始轨迹的一致性,选择相互一致的轨迹作为最终答案。
互一致性帮助模型选择正确的推理轨迹的原因:
外部验证: 鉴别器作为外部评估者,为模型提供客观的反馈,避免模型自身评估的偏差。
降低难度: 通过部分提示,降低鉴别器推理的难度,提高其提供正确答案的概率。
群体智慧: 两个 SLM 之间的相互验证,类似于人类群体中的同伴互评,可以更有效地识别正确答案。
C. 最终轨迹选择:
最终得分计算: 将候选轨迹的奖励值与终端节点的置信度得分相乘,计算最终得分。
选择最佳轨迹: 选择最终得分最高的轨迹作为最终答案。
3.5 Quiet-STaR: Language Models Can Teach Themselves to Think Before Speaking
1)贡献1
将 STaR 推广到学习推理,也是其与 STaR 的主要区别。STaR 主要针对特定任务进行推理学习,而 Quiet-STaR 则将推理学习推广到更广泛的文本数据中。这使得语言模型能够在更通用的场景下进行推理,并从多样化的文本任务中学习。
2)贡献2:并行采样算法
这是实现 Quiet-STaR 的关键技术之一。并行采样算法能够高效地生成每个 token 的推理,从而使得模型能够从大规模文本数据中学习推理。
3)其他创新点
元 token、混合头、非短视损失函数等创新点都是为了更好地实现 Quiet-STaR 的目标,即让语言模型能够学习推理并提高其预测能力。
3.6 Google Deep Mind 的Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters
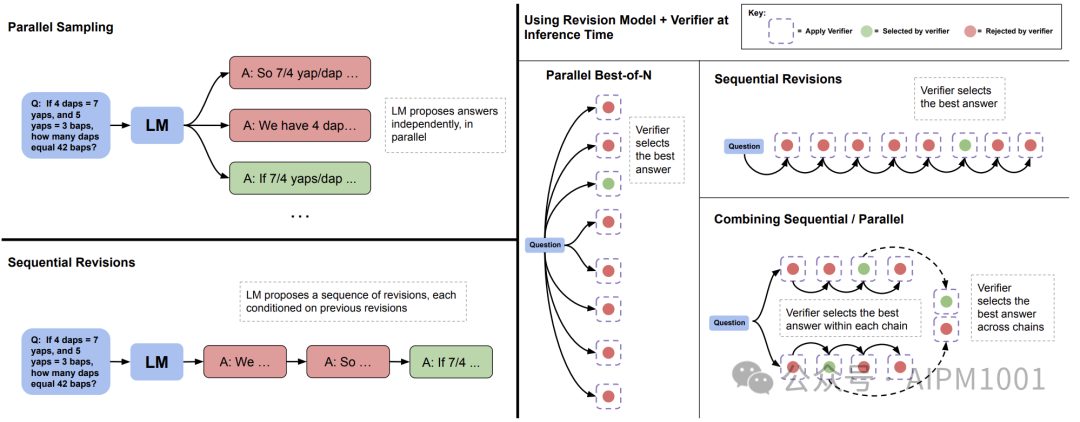
针对现有 LLM 推理能力有限的不足,提出了以下创新方法和策略:
1)创新方法
PRM 验证器和树搜索算法:通过训练一个过程奖励模型来评估每一步的正确性,并利用树搜索算法(如束搜索和前瞻搜索)在解决方案空间中进行搜索,找到最优答案。
迭代修订模型:通过微调 LLM,使其能够迭代地修改其初始答案,使其逐渐接近正确答案。
2)创新策略
推理时计算最优扩展策略:根据提示的难度动态选择最佳的推理时计算策略,以最大化性能提升。
计算预算交换:将推理时计算和预训练计算进行比较,发现对于简单和中等的推理任务,推理时计算可以有效地替代额外的预训练计算,从而降低预训练成本。
3)改进
性能提升:在相同的计算预算下,使用“推理时计算最优扩展策略”可以显著提升 LLM 的性能,并优于传统的最佳-of-N 策略。
预训练成本降低:对于简单和中等的推理任务,可以使用推理时计算来替代额外的预训练计算,从而降低预训练成本。
模型泛化能力提升:通过迭代修订模型,LLM 可以学习从错误中吸取教训,并改进其推理能力,从而提升模型的泛化能力。
Google在研究中提到了从简单到复杂的三种方案,直接在多个答案中选最佳解的方法(Best of N),在思维链中每步都提供多个候选项的方法(Beam Search)和把后续多个步骤联系起来看的MCTS方法的简化版本Lookahead Search。
我们可以尝试着在推理阶段不要求模型一次做对的能力,而是让LLM去尝试一题多解, 然后针对多个答案进行评估打分, 最终输出一个正确的答案. 在答案评估的时候,同时引入对过程的评估,即Process-based Reward Model(PRM)。搜索方法上, 它采用了Lookahead Search, 本质上是MCTS的一种特殊形式.
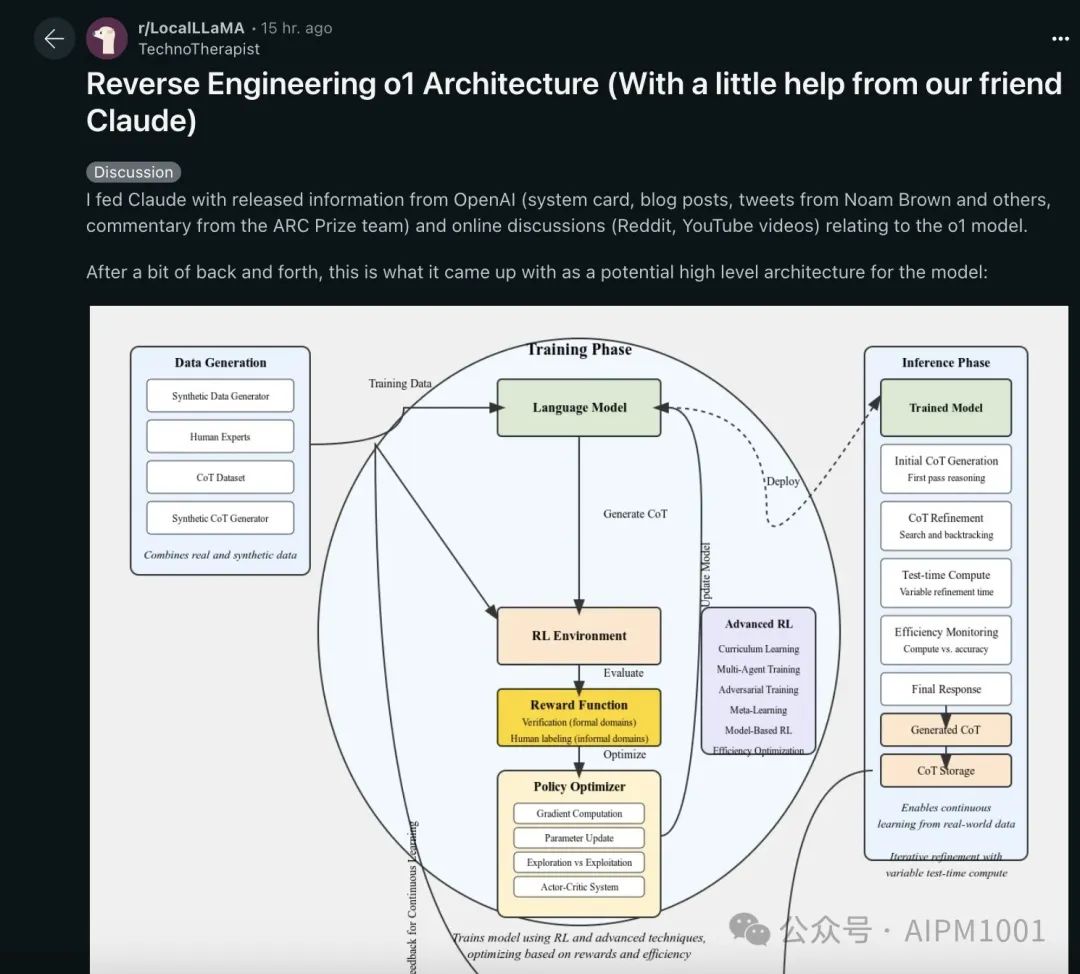
(o1可能的架构图,来源:https://www.reddit.com/r/LocalLLaMA/comments/1fgr244/reverse_engineering_o1_architecture_with_a_little/)
下面是关于这张架构图的详细说明,主要包括四个阶段:
4.1 数据生成
数据生成模块负责创建用于训练的数据,包括:
合成数据生成器(Synthetic Data Generator)、人类专家、CoT数据库(CoT Dataset,链式思维数据库)、现实世界和沙盒数据
这些数据被汇集起来,形成训练数据,用于后续模型的训练阶段。
4.2 训练阶段
训练阶段主要由以下几个模块组成:
语言模型,这是核心的AI模型,负责处理和理解语言数据。
RL环境,强化学习环境用于模型优化。
奖励函数,包括验证(Verification)和人类反馈(Human labeling),用来指导模型学习。
策略优化器(Policy Optimizer),包括梯度压缩、Panzar系统、探索与利用等,用于优化模型策略。在这个阶段,模型通过强化学习和高级技术进行训练,不断优化性能和效率。
4.3 推理阶段
推理阶段包括:
训练好的模型,这是通过强化学习和高级技术优化后的模型。
多任务生成,处理多个任务的能力。
最终响应,生成最终的输出结果。
CoT生成和微调,根据链式思维生成并微调结果。
效率监控:实时监控模型的性能。
4.4 关键注释
大规模CoT存储进入RL环境是作者自己的假设,作者认为OpenAI可能会使用从现实世界中生成的大量链式思维来进一步调整和优化RL模型。举例说明:假设你是一名研究员,想要构建一个能够进行多任务处理的AI系统。
我们可以通过参考这个o1架构按照上面三个模块进行以下工作:
1)首先,收集并生成各种类型的数据,包括合成数据、人类专家提供的数据以及现实世界的数据。
2)接着,利用这些数据训练你的语言模型,并在强化学习环境中进行优化,通过奖励函数和策略优化器不断提升模型性能。
3)最后,将训练好的模型部署到推理阶段,使其能够处理多任务并生成最终响应,同时监控其效率并进行必要的微调。这种架构不仅适用于语言处理,还可以扩展到其他领域,如图像识别、游戏开发等,通过不断优化强化学习过程,使得AI系统更加智能高效。
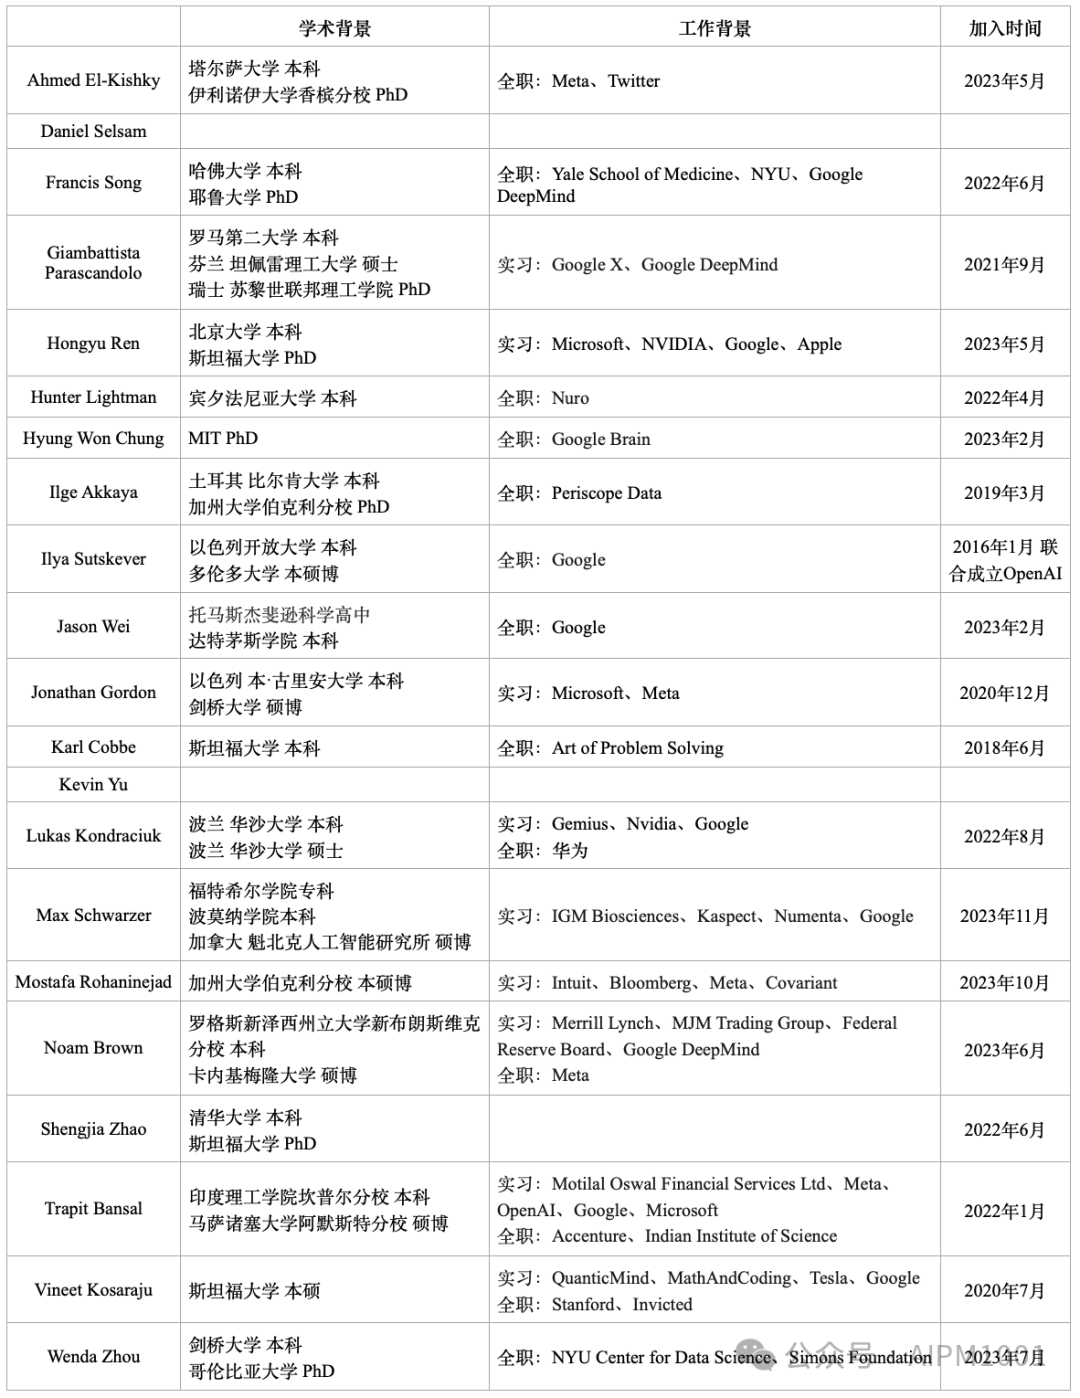
在 OpenAI 公布的o1模型的参与人员中,不仅包括前首席科学家Ilya Sutskever,COT 作者 Jason Wei,还包含了Jiayi Weng等大量华人科学家。
在o1 的21个Foundational贡献者呈现出了高学历、高包容性、多元化、国际化等特点。
注:2人未找到相关资料。
21个Foundational贡献者资料明细
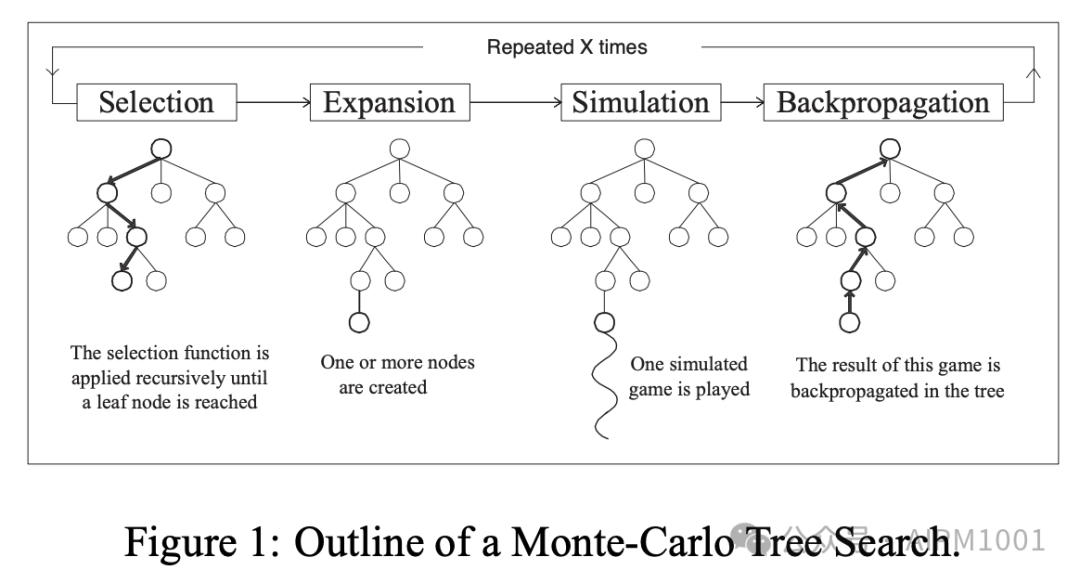
1.1 概念:蒙特卡洛树搜索(Monte Carlo Tree Search,MCTS)是一种用于某些类型决策过程的启发式搜索算法,特别是在双人零和游戏中。它结合了蒙特卡洛模拟的随机抽样和决策树搜索的系统性。MCTS在计算博弈论和人工智能领域中非常有用,尤其是在围棋、国际象棋和其他策略游戏中。
1.2 MCTS的基本步骤
1)选择:从根节点开始,按照特定的策略,选择最有前途的子节点,直到到达一个尚未完全展开(即还有未探索的行动)的节点。
2)扩展:在选择的节点上添加一个或多个子节点,这些子节点代表了可能的下一步行动。这涉及到游戏状态的更新,将游戏向前推进到一个新的状态。
3)模拟:从新添加的节点开始,进行蒙特卡洛模拟,直到游戏结束或达到预定的模拟深度。这个过程不需要完美信息,可以使用随机策略来选择行动。
4)反向传播:将模拟的结果(比如输赢或得分)更新到所访问路径上的所有节点。如果模拟结果是胜利,则增加沿途节点的胜利次数;如果是失败,则相应地更新失败的统计数据。
1.3 关键特点
1)自适应搜索:MCTS能够根据之前的搜索结果自适应地搜索那些更有希望的区域。
2)无启发式:与某些其他搜索算法不同,MCTS不需要领域特定的启发式评估函数。
3)并行化:模拟步骤可以独立进行,因此MCTS很容易并行化,这使得它在多核处理器上特别有效。
1.4 Beam Search、Lookahead Search、MCTS对比
Beam Search:一种启发式的图搜索算法,常用于机器翻译、语音识别等领域的解码过程。它在每一步都从当前节点扩展出一定数量(beam width)的最有前途的子节点,而不是搜索所有可能的子节点,从而减少了搜索空间。
Beam Search的优点是计算效率高,但缺点是可能会错过一些不那么显而易见但最终可能更优的路径。
Lookahead Search:一种在Beam Search基础上的扩展,它在搜索时不仅考虑当前步骤的最优解,还会向前看多步,考虑未来的可能性。这种搜索策略可以帮助算法做出更长远的决策,但计算成本也会随之增加。
Lookahead Search的关键在于它尝试预测并评估不同的决策路径,从而选择最优的行动方案。
MCTS:一种用于某些类型决策过程的启发式搜索算法,它结合了随机模拟和决策树搜索。MCTS通过多次模拟来评估不同的决策路径,并根据这些模拟的结果来选择最优的行动。
MCTS特别适用于双人零和游戏,如围棋、国际象棋等,它通过构建整个树来探索所有可能的行动路径,并通过模拟来评估这些路径。
这是一种重采样技术,用于从原始数据集中生成新的样本集,以此来估计一个统计量(如均值、方差等)的分布。通过这种方法,可以不需要对总体分布做出任何假设,就能够估计出模型参数的不确定性和稳定性。
Bootstrap方法的步骤通常包括:从原始数据集中随机抽取样本,允许重复抽样(即有放回抽样);根据抽取的样本计算所需的统计量;重复上述过程多次(通常是数千次),以获得统计量的分布;使用这个分布来估计原始统计量的标准误差、置信区间或其他特征。
在机器学习领域,Bootstrap方法可以用来提高模型的泛化能力和鲁棒性。例如,通过Bootstrap抽样可以创建多个不同的训练集,然后用这些训练集来训练多个模型。这些模型可以结合起来,形成一个集成模型,如随机森林或Bagging模型,以此来减少过拟合和提高模型的预测准确性。
PPO(Proximal Policy Optimization,近端策略优化)是一种在强化学习领域广泛使用的算法,它属于策略梯度方法的一种。PPO算法的核心思想是在每次更新策略时,限制新策略与旧策略之间的差异,以保持训练过程的稳定性。
PPO算法有两个主要变体:PPO-Penalty和PPO-Clip。PPO-Penalty通过在目标函数中添加一个惩罚项来近似解决一个KL散度约束的更新问题,而PPO-Clip则不直接使用KL散度项,而是通过目标函数中的裁剪操作来限制新旧策略之间的差异。
PPO算法的实现步骤通常包括:
1)初始化策略网络参数。
2)通过与环境交互收集数据。
3)计算优势函数,用于评价动作的好坏。
4)使用裁剪的目标函数或惩罚项来更新策略网络参数。
5)重复以上步骤,直到策略收敛。
PPO算法的优点包括稳定性、适用性和可扩展性。它适用于离散和连续动作空间的环境,并且可以通过并行化来提高训练效率。PPO算法在游戏、机器人控制、自动驾驶等领域都有广泛的应用。
激活学习是一种机器学习方法,其核心思想是选择最有价值的数据进行标注和学习,从而提高学习效率和模型性能。
通常用于以下场景:数据标注成本高、数据集规模庞大、模型性能提升空间有限。
包括以下几个步骤:选择标注策略、选择标注数据、标注数据、训练模型、迭代优化。
在许多领域都有广泛应用,例如图像识别、自然语言处理、推荐系统。
Open AI官网:
1、https://openai.com/index/introducing-openai-o1-preview/
2、https://openai.com/index/learning-to-reason-with-llms/
3、https://openai.com/index/openai-o1-mini-advancing-cost-efficient-reasoning/#model-speed
OpenAI o1、核心成员官推:OpenAI 官推、CEO Sam Altman、总裁&联创Greg Brockman、COT 作者Jason Wei、模型核心成员Noam Brown、Hyung Won Chung、Ahmed El-Kishky、Ren HongYu、ShenJia Zhao
公众号:海外独角兽、 FudanNLP、机器之心、 量子位、数字生命卡兹克、 AI Pioneer、 AI产品黄叔、人工智能与算法学习、AINLP、腾讯科技、 GitChat、AI科技大本营、智能涌现、PaperWeekly、硅谷科技评论、卜寒兮AI、zartbot、投资实习所、AI的潜意识、夕小瑶科技说
作者:AIPM1001 ,公众号:AIPM1001
本文由 @AIPM1001 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。