









在经管、心理学、社会学等实证研究领域,问卷数据的收集与分析往往是一场“豪赌”。好不容易收回几百份问卷,导入 SPSS 或 AMOS,却面临 KMO 极低、信度不达标、因子交叉载荷严重、中介效应不显著等一系列致命问题
为解决这一问题,我用 Python 开发了这套「问卷数据智能生成与柔性寻优系统 」。它并非简单的随机数生成器,而是一个搭载多进程变异寻优算法、内置 Scipy/Statsmodels 统计引擎、严格遵循核心期刊发刊标准的数据沙盒模拟器
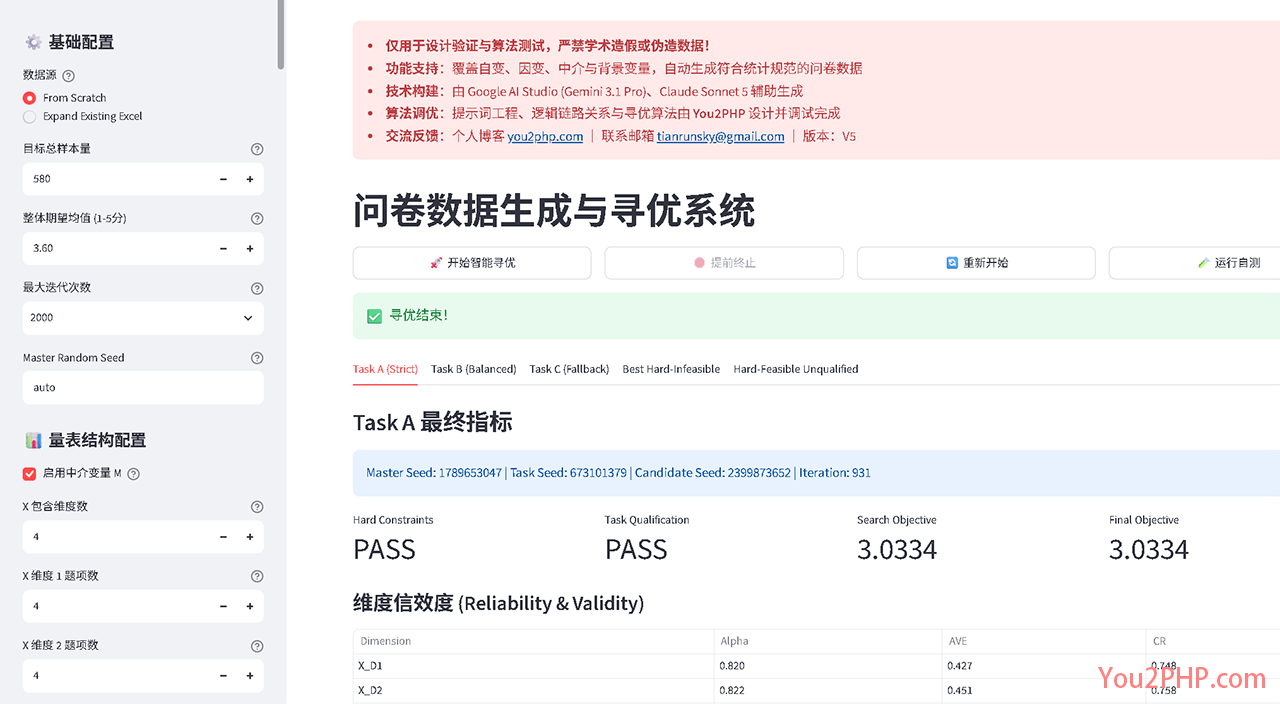
核心特性
[进化寻优引擎解锁] 重构了候选数据集的距离测算算法(归一化 Frobenius 距离 + 欧氏距离)。算法不再是随机碰撞,而是真正实现了“多候选对比、保留多样性、择优繁衍”的智能搜寻。
[实时性能监控面板] 新增全景监控仪表盘。实时追踪已运行时间、系统资源占用,以及精确到小数点的“迭代/秒”运算速度,并配有动态资源占用趋势折线图。
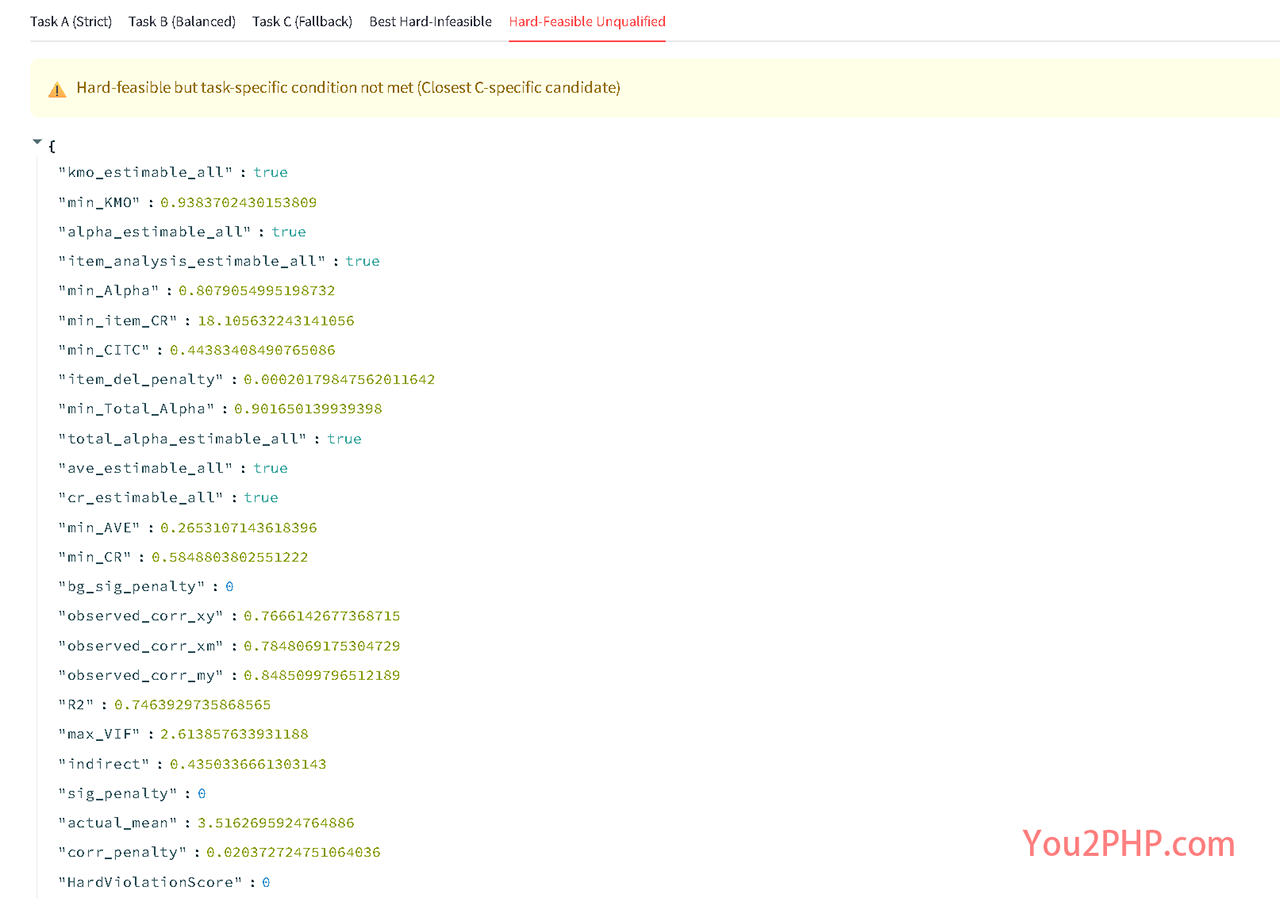
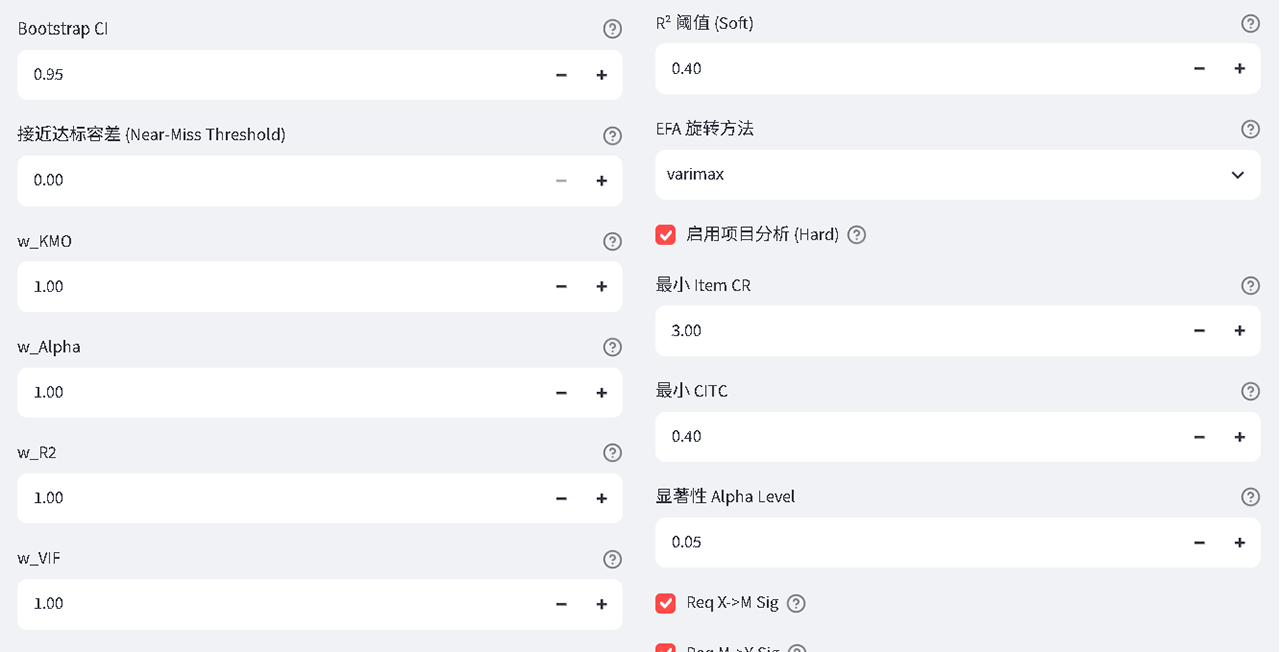
[接近达标容差 (Near-Miss)] 极具人性化的机制。当某个数据集因微弱差距(如 Alpha 差了 0.01)未能通过严苛的“硬约束”时,可设定容差值放行。系统将带上醒目警告为你完整展示报告,把决策权交还给你。
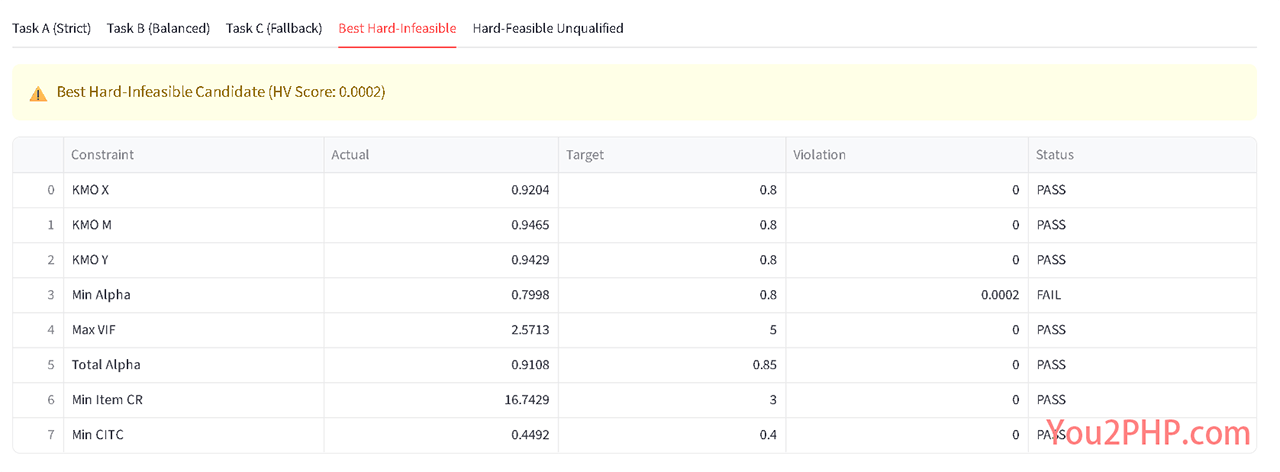
[全局 77 项帮助提示] 为全站所有滑块、输入框、下拉菜单配备了极度详尽的参数说明。悬停即可查看“这是什么”以及“调大会有什么影响”。
全景参数矩阵:你可以控制什么?
系统左侧面板提供了精细且功能齐全的调优选项,涵盖从理论构建到数据导出的每一个数学细节:
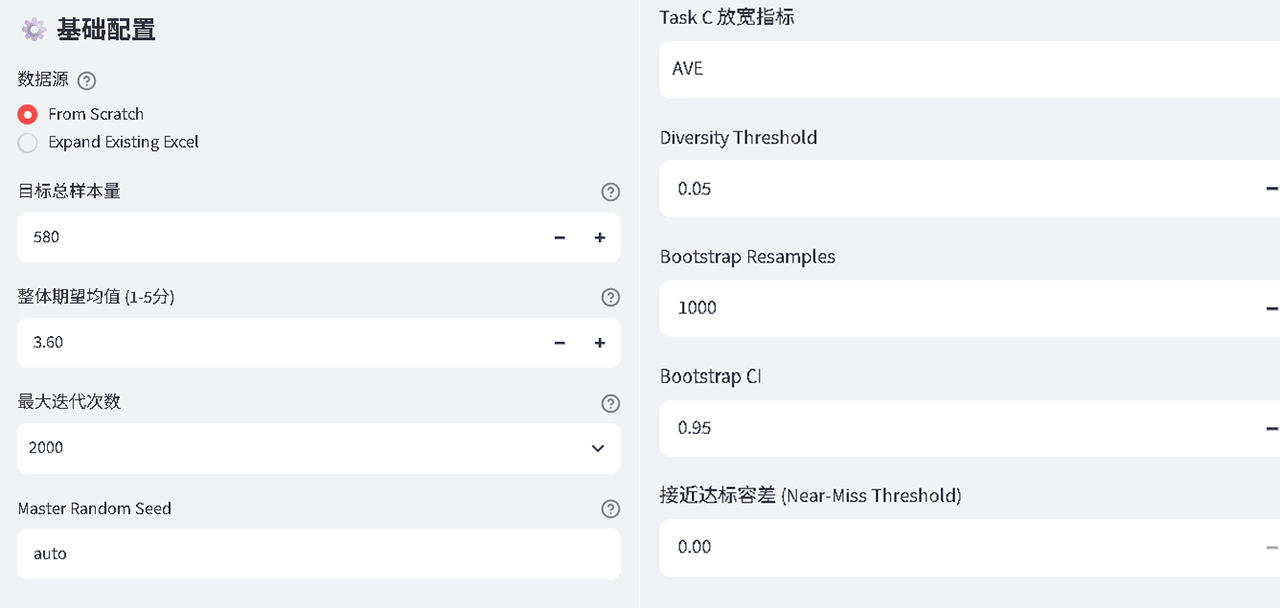
1. 基础配置与数据源引擎
数据源 (Data Source):支持「从零生成 (From Scratch)」纯理论模拟;也可选择「扩充已有 Excel」,上传少量真实问卷,系统提取其特征并用 Bootstrap 抽样补齐目标样本量。
目标总样本量:最终输出的数据行数。样本量越大 EFA 越稳定,但寻优耗时越长。
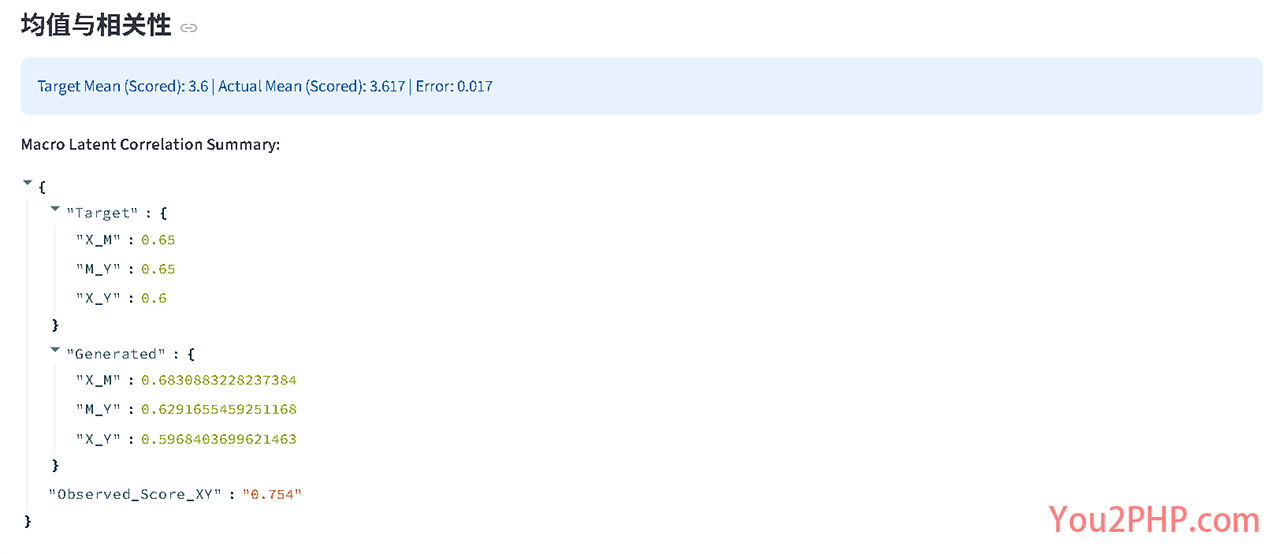
整体期望均值:精确设定 1-5 分量表的总体平均分(如 3.6 分),突破呆板的中心值生成。
最大迭代次数:搜索深度,可选 100 至 2000 次,决定了系统寻找最优解的耐心。
2. 量表结构与嵌套配置
中介变量 M 引擎:一键开启/关闭 X-M-Y 三变量中介效应架构。
多维度精细嵌套:为 X、M、Y 分别指定包含几个子维度,以及每个子维度包含几道题。完美映射任何复杂的量表。
反向计分题项:下拉多选反向题,后台自动翻转计分进行信效度评估,但导出时保留原始填写习惯。
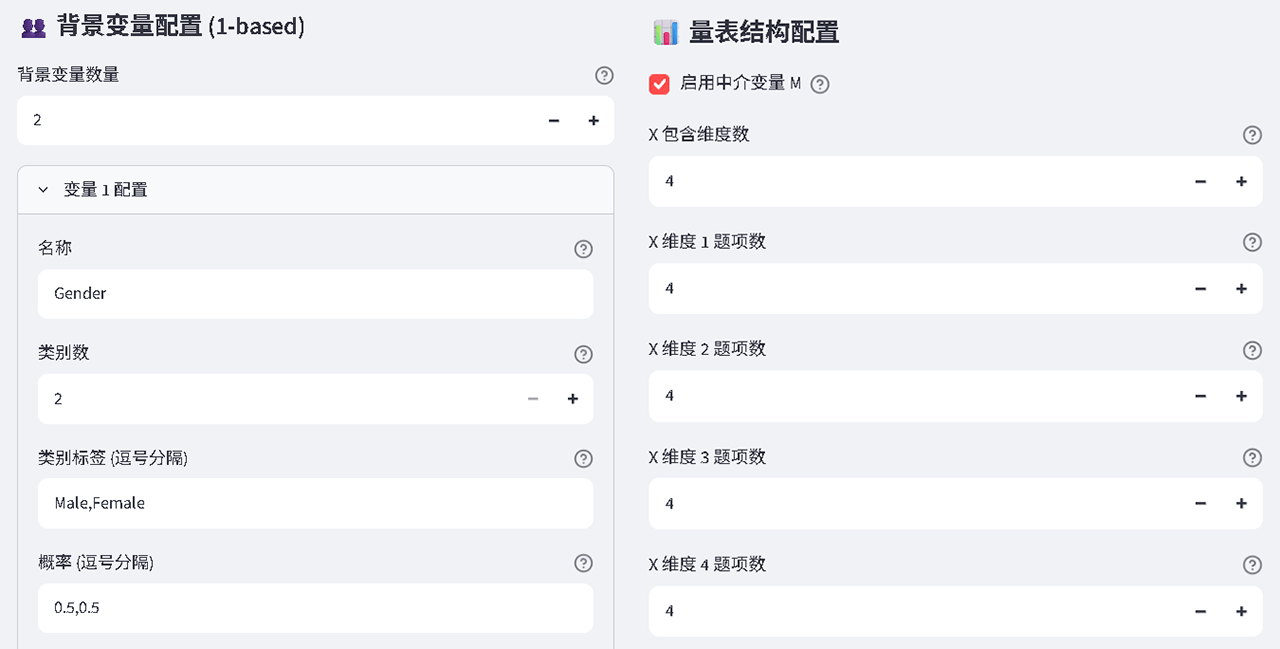
3. 动态背景变量控制台 (Demographic)
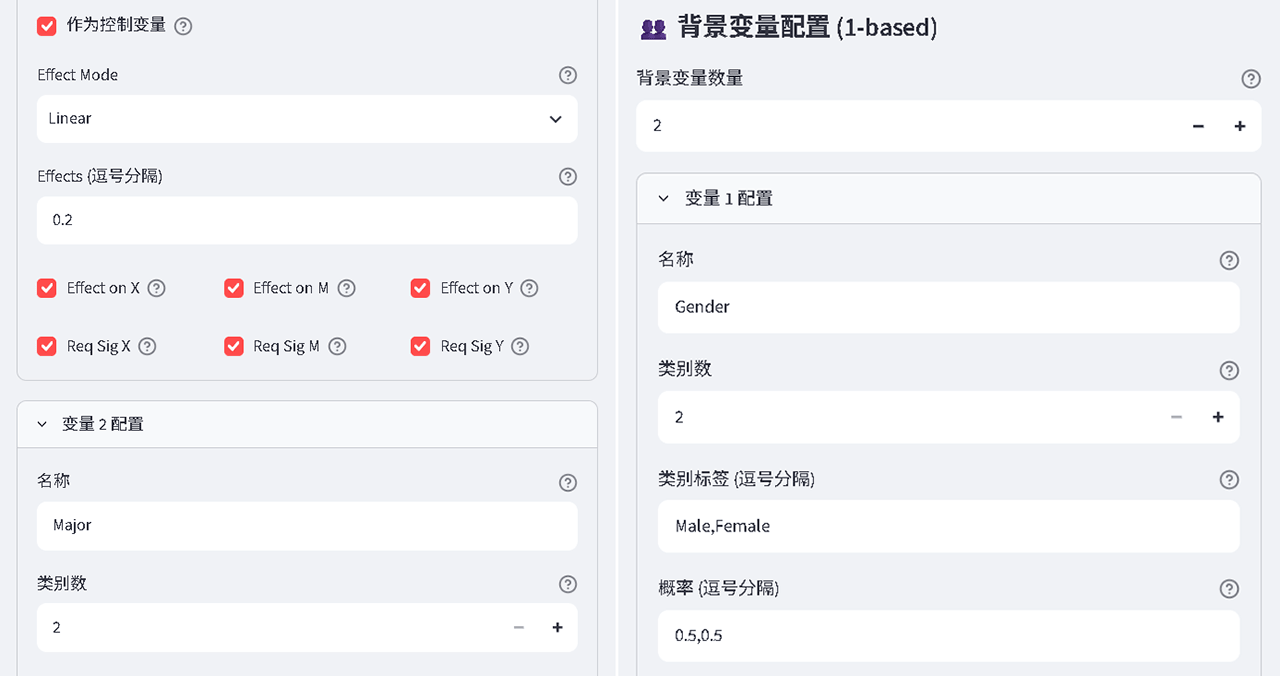
真实比例与分类:自定义变量名(如性别、专业),设定分类数,通过概率数组(如 0.6, 0.4)控制生成人口占比。
效应模式 (Effect Mode):支持线性递增效应 (Linear),也支持为每个类别设定组间效应差值 (Category-specific)
控制变量引入 (Control):一键勾选,系统自动做虚拟变量 (Dummy) 编码并将其纳入最终 OLS 回归作为控制变量。
定向显著性狙击 (Req Sig):勾选后,底层强制注入均值偏移。确保最终出炉的数据在独立样本 t 检验或方差分析 (ANOVA) 中,p 值绝对小于 0.05。
4. 宏观相关与硬性约束边界
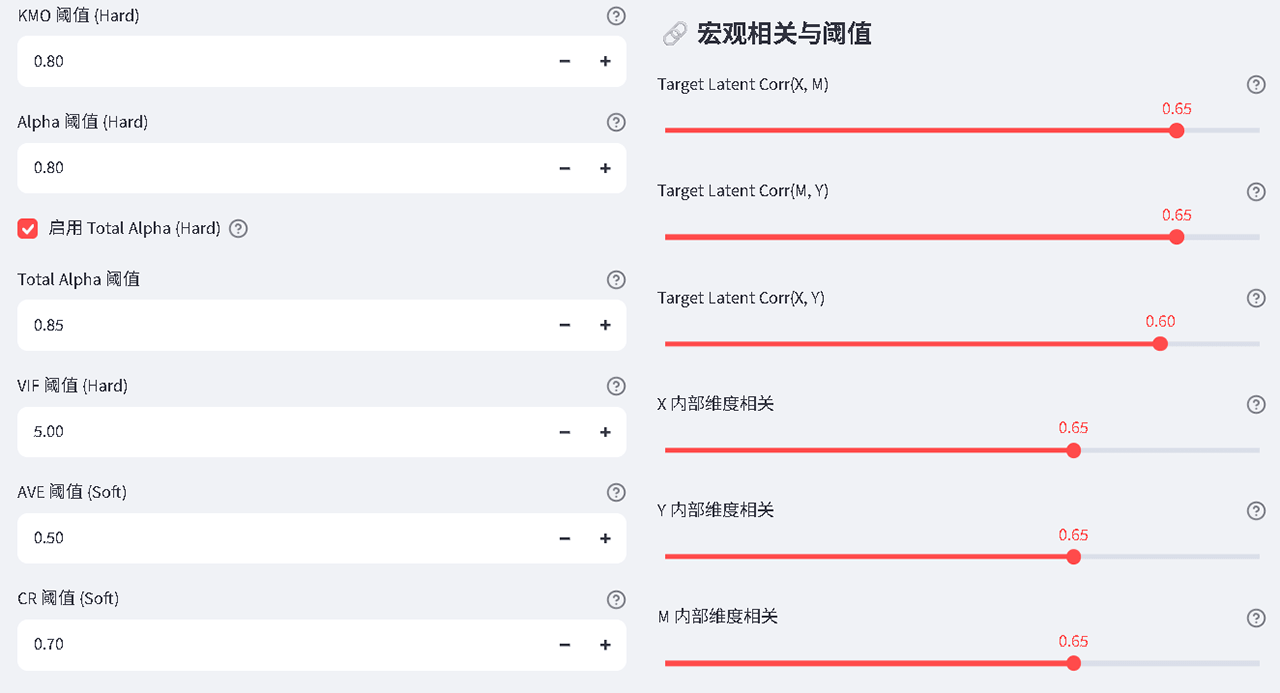
潜变量目标相关:通过滑块精细设定 X-M、M-Y、X-Y 之间的相关系数。这是保障回归解释变异量 (R²) 突破 40% 的核心开关。
信效度一票否决:强制设定 KMO (>0.80) 与维度 Alpha 阈值 (>0.80)。支持开启“总 Alpha 约束”,强行制造总量表信度大于分量表信度的完美阶梯感。
项目分析清道夫:开启后强制校验高低 27% 分组的 Item CR (临界比 >3.0) 与 CITC (>0.40),剔除无区分度废题
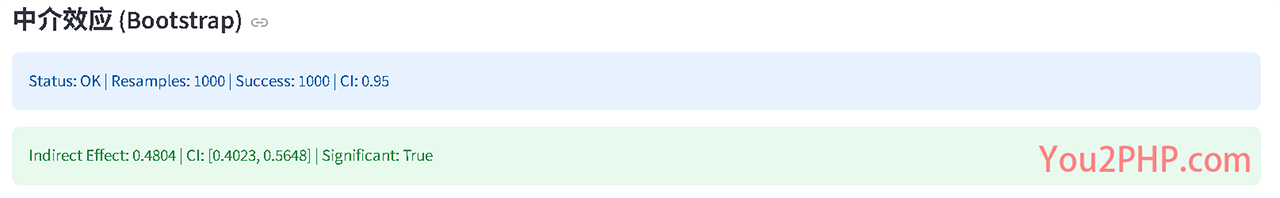
Bootstrap 强制显著:开启中介路径的 Sig 要求后,系统边生成边执行 1000 次重抽样,间接效应 95% 置信区间不跨零才算合格。
5. 底层惩罚函数权重 (Loss Weights)
提供多达 12 项底层目标函数的权重滑块(如 w_KMO, w_Sig, w_Path)。遇到极难收敛的超大矩阵时,调高 w_Sig 可逼迫算法优先保住假设显著性,实现柔性寻优。
实战指南:场景化操作步骤
场景一:从零构建复杂中介模型 (无原始数据)
应用场景:论文初期需要一套完美数据来验证理论框架,自变量(X)对因变量(Y)有影响,且需要学习投入(M)作为中介,同时包含性别、专业的组间差异检验。
1. 数据源选择「From Scratch」,设定样本量 580,均值设为 3.6,迭代次数设为 1000。
2. 勾选「启用中介变量 M」。配置 X 为 4 维度,M 为 3 维度,Y 为 4 维度,根据量表依次填入题项数。
3. 背景变量设为 2 个。变量 1 命名“性别”,2 类,概率 0.5/0.5,勾选“作为控制变量”及“Req Sig X/M/Y”。变量 2 命名“专业”,取消控制变量,同样勾选所有 Req Sig 以保证 ANOVA 显著。
4. 宏观相关区:将 X-M, M-Y 拉到 0.65,X-Y 拉到 0.6。KMO 与 Alpha 设为 0.8。勾选「Req X->M Sig」、「Req M->Y Sig」、「Req Indirect Sig」保障中介显著。
5. 点击「开始智能寻优」,等待进度条完成,直接下载 Task A 数据集即可跑通所有假设。
场景二:从零构建【仅含直接效应】的基础实证数据
应用场景:论文架构简单,仅探讨 X 对 Y 的影响,无中介变量,且不要求各背景变量在各维度上一定显著。
1. 选择「From Scratch」,样本量设 300,迭代设 500。
2. 确保「启用中介变量 M」处于关闭状态。此时面板会自动隐藏所有与 M 相关的配置。
3. 配置 X 和 Y 的维度数与题项数。
4. 配置人口学变量,可取消勾选所有的「Req Sig X」与「Req Sig Y」,让其顺其自然生成(不强求显著性,跑分更快)。
5. 在宏观相关区,仅将 Target Latent Corr(X, Y) 拉到 0.6 左右,勾选「Req X->Y Sig」,点击开始即可极速出结果。
场景三:利用已有少量残缺数据扩充样本 (含缺失值)
应用场景:手头仅回收到 50 份有效问卷,想要在保留原有调查群体特征的基础上,将总数扩充至 300 份,用于直接效应回归分析。
1. 数据源切换为「Expand Existing Excel」,上传你的 .xlsx 数据文件,缺失值处理选择 Listwise deletion (剔除空行)。目标样本量设为 300。
2. 在弹出的 Excel 映射区,依次将“性别”、“学历”映射到表中的对应列。并为原始数据中的字符串(如“男”)指定系统分类编号(如 1)。
3. 在“问卷题项列”多选框中,严格按照 X、Y 维度的顺序,依次选中表里的题项列名。
4. 关闭「启用中介变量 M」。其他统计阈值保持默认。
5. 运行后,系统将自动测算你上传这 50 份数据的协方差,通过 Bootstrap 抽样扩充并补全剩余 250 份,融合后的 CSV 浑然一体。
场景四:精准操控回归系数,避免数据“假得离谱”
应用场景:普通机器生成的数据常常过于完美(如回归 Beta > 0.8),在盲审时极易被专家识破。你需要一组效应大小适中(如 Beta = 0.35),且信度呈现自然分布的真实感数据。
1. 调低潜变量约束:在宏观相关区,将潜变量相关性滑块降至 0.45 左右,刻意保留数据噪音。
2. 勾选「启用路径目标 Loss」,将 Target X->Y 系数强行瞄准 0.35 等真实区间,算法会自动惩罚过高或过低的系数。
3. 勾选「启用 Total Alpha (Hard)」,将总量表的信度设为极高的 0.90;但同时将各个子维度的基本 Alpha 阈值降至 0.75。
4. 这样跑出的数据会呈现出一种极度真实的“自然质感”:量表总分极其稳定,但内部各维度各具特色,且影响效应“显著但不过分”。
场景五:超大题量矩阵的“极限闯关”与容差拯救
应用场景:你的模型包含 50 道甚至 80 道以上的题项。在真实统计学中,极难让这么多题目同时满足所有维度 Alpha > 0.8,且完全没有交叉载荷,算法寻优往往“全军覆没”。
1. 将迭代次数拉满至 2000 次,为多进程提供充足的底层变异池。
2. 在侧边栏最下方,找到 V5 的专属功能「接近达标容差 (Near-Miss Threshold)」,设定为 0.05 左右。
3. 将「Task C 放宽指标」设为 AVE(平均方差提取量),允许在极端困难的寻找中适度牺牲收敛效度以保全全局信度。
4. 运行结束后,即使 Task A 未能显示绿色 PASS,系统也会根据容差值捕获“最接近的次优解”。你往往会发现只是某一个维度的 Alpha 卡在了 0.79,此时直接提取这组真实感拉满的数据稍作解释,即可通关。
场景六:包含“反向计分题”的真实量表还原
应用场景:为了测谎或防随意勾选,你的原问卷中设置了反向描述的题目(如“我不喜欢环保”)。你需要生成的数据在表面上呈现低分(反向填答),但在背后计算信效度时又要完美合格。
1. 在量表结构配置区完成题项划分后,找到「选择反向计分题项」的下拉菜单。
2. 将属于反向题的题目(如 X_D1_Q3)选中。
3. 点击运行。系统引擎会在底层先生成高分数据,然后自动应用公式 (6 - 原始分) 将其翻转。
4. 最终下载的 CSV 数据集里,该题会自然呈现出 1 分、2 分等符合常理的“低分”,而完全不会破坏总体的 Alpha 信度和结构效度。导入 SPSS 时,只需按常规操作先进行一次重新编码 (Recode) 即可使用。
场景七:突破高度相似变量的“多重共线性陷阱 (VIF)”
应用场景:你的自变量其实是同一个概念的不同维度(例如:绿化意识、节水意识、节能意识),它们在概念上极其相似。普通软件生成这种数据时,由于自变量高度相关,回归分析的 VIF 往往会突破 10,导致模型报废。
1. 在统计学约束面板,将「VIF 阈值 (Hard)」强制设为非常严格的 3.0 或 5.0。
2. 适度调低侧边栏的「内部维度相关」,例如将 X 内部维度相关降至 0.45 左右,强迫算法拉开各个子维度之间的距离。
3. 提高底层权重 `w_VIF` 到 5.0,逼迫系统优先消灭共线性。
4. 系统会在数百次迭代中,自动寻找一组“既能保持显著正相关,又能避开共线性红线”的协方差矩阵。跑出来的数据,VIF 绝对安全,可以直接截图放进论文。
场景八:极度不平衡样本的显著性“强制狙击”
应用场景:由于行业特殊性,你收集的样本男女比例严重失衡(如 护士群体,女性 280 人,男性仅 20 人)。在真实情况下,这种 9:1 的悬殊比例极难跑出显著的 t 检验差异。
1. 在动态背景变量控制台,将“性别”类别的概率数组设定为真实的畸形比例,例如填入 0.9, 0.1。
2. 勾选“性别”变量的「Req Sig X/M/Y」强迫显著复选框。
3. 将「Effect Mode」设定为 Category-specific,并在 Effects 里填入足够大的拉伸值(如 0.0, 0.6),人为放大那 10% 小群体的均值差异。
4. 算法引擎会自动根据这一悬殊比例注入强烈的均值偏移 (Mean Shift)。最终即使某一组只有寥寥二三十人,独立样本 t 检验的 p 值依然会被“死死钉在”小于 0.05 的显著区间。
详尽的智能诊断报告输出
倒杯咖啡的时间,系统将为你呈现无需加工、可直接用于论文撰写的全景报告:
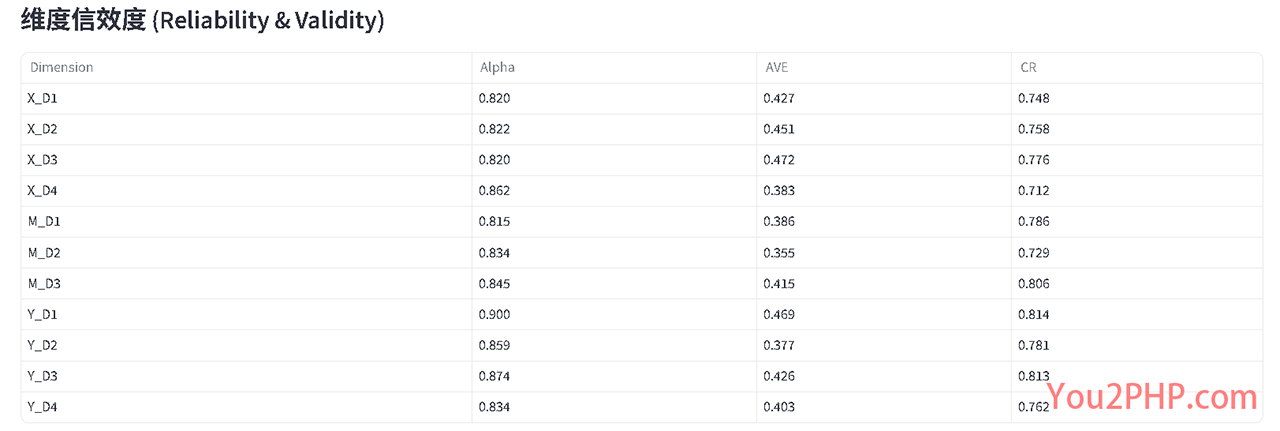
[维度信效度表] 清晰列出每个子维度的 Alpha、AVE、CR。
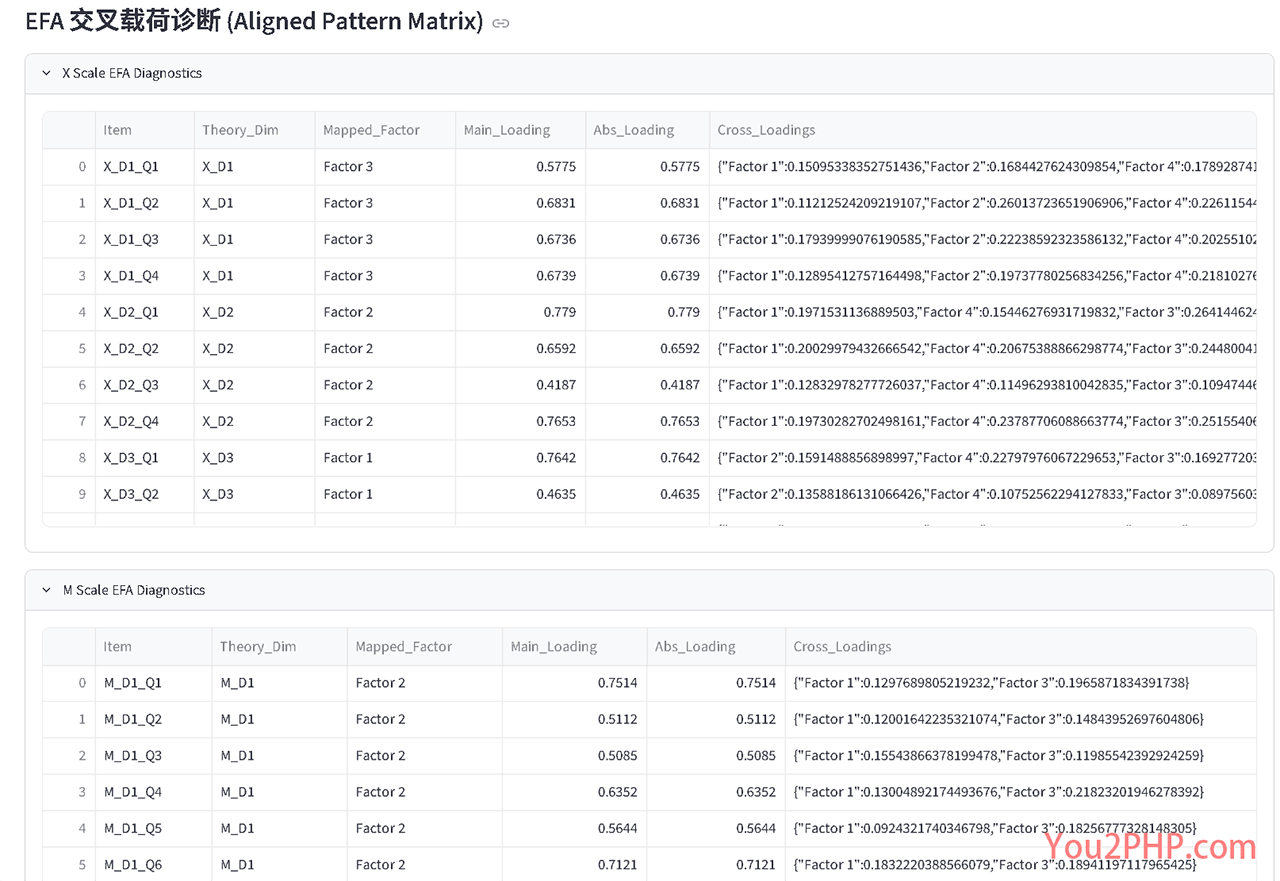
[EFA 交叉载荷阵] 运用匈牙利对齐算法计算的因子载荷矩阵,主副载荷一览无余,确保因子结构纯粹。
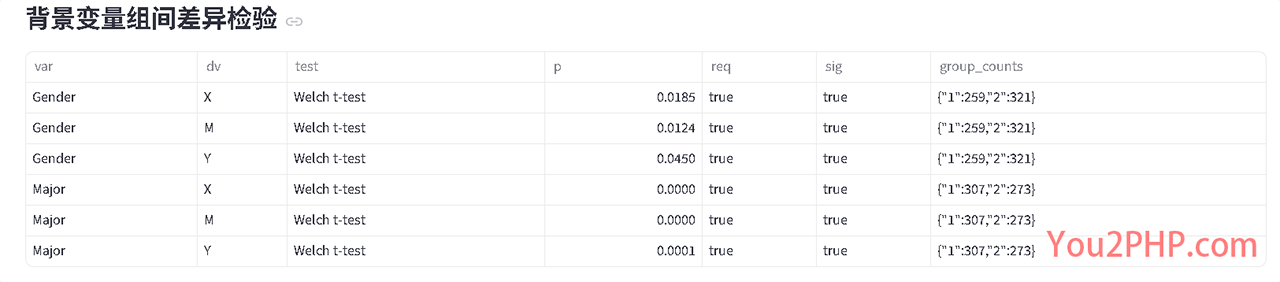
[组间差异检验表] 自动输出背景变量的 Welch t 检验或 F 值、p 值与真实 N 数。
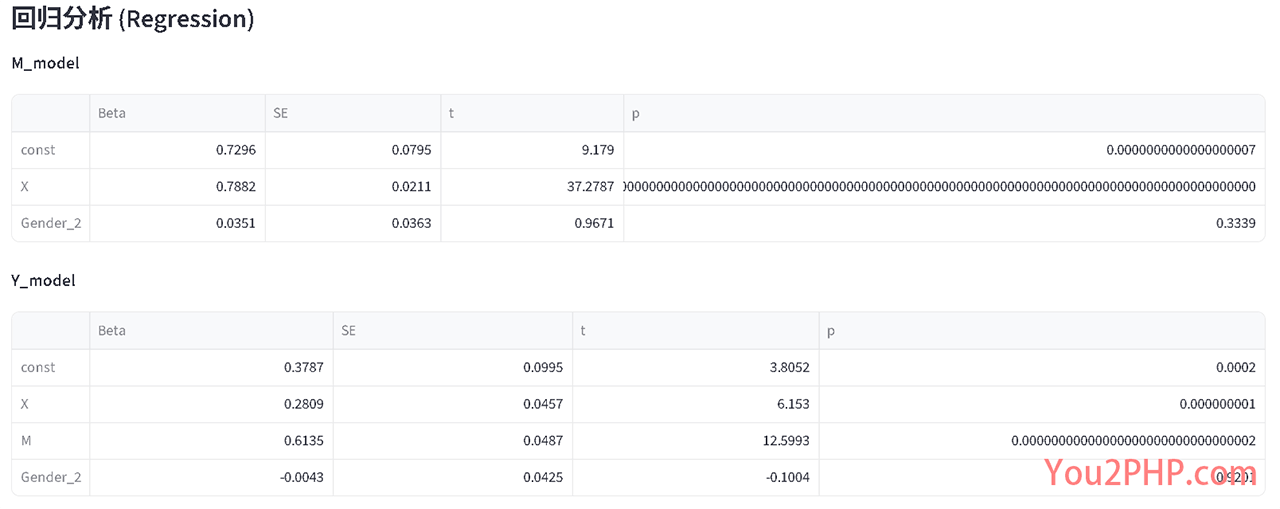
[回归与中介分析表] 包含标准误 (SE)、t 值、回归系数、模型 R²,以及 1000 次 Bootstrap 的置信区间结果。
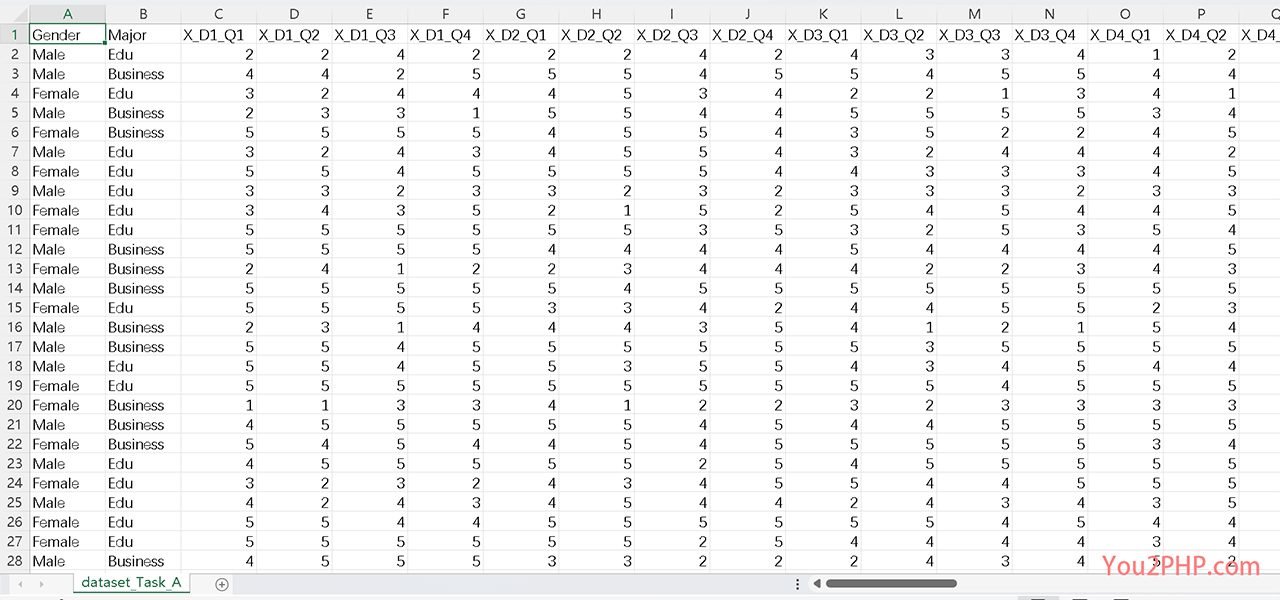
[一键导出] 提供反向计分还原后的 .csv 原始数据极速下载。
特别说明与学术诚信声明
开发本系统的初衷,旨在为广大学者、研究生提供一个“问卷预调研设计工具”、“统计学算法测试环境”以及“理论模型沙盒”。本系统生成的任何数据,其本质仍为高维多元正态分布的蒙特卡洛(Monte Carlo)抽样产物。严禁任何人将其用于伪造真实的学术调查结果,或进行学术造假!请将精力放在打磨扎实的理论推演、深度的文献对话以及真实的社会调研上。工具永远只是帮助验证想法的脚手架,绝不能代替科学探索。
工具下载 (Download)
为了提供更稳定的下载体验并减轻服务器流量压力,本程序的打包版本已上传至 MEGA 云盘。
考虑到不同电脑环境的杀毒软件机制差异,这里提供 两个版本 供您自选:
【版本说明与防误报指南】
1. 单文件版 (Single EXE):整个程序只有一个 EXE 文件,极致清爽。但由于其运行时需在后台向临时目录释放依赖库并执行,这一动作极易触发杀毒软件(如卡巴斯基、360等)的启发式行为误报。如果您了解白名单添加机制,可选择此版本。直接在虚拟机中运行也是一个不错的办法!
2. 文件夹版 (.rar 压缩包):原生 Standalone 模式。解压后是一个包含各种依赖文件的文件夹,双击里面的 exe 即可运行。它不会在系统后台进行释放操作,完美避开了杀毒软件的行为学查杀拦截。如果您不想折腾杀软白名单或不熟悉虚拟机配置,推荐下载此版本
资源名称: SPSS-Questionnaire-Data-Generation-and-Optimization-Tool
[注] 国内用户如遇 MEGA 网盘无法正常打开的情况,请使用合理的网络代理环境进行访问。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。