








今年七月初,我看见了一条消息:美团推出了 LongCat 2.0 模型!还有 ¥9.9 的 Token Pack!
— Meituan LongCat (@Meituan_LongCat) June 30, 2026Introducing LongCat-2.0 🐱
1.6T parameters · MoE with ~48B active · 1M context
The full model behind Owl Alpha on @OpenRouter — now available.Built for agentic coding from the ground up:
◆ LongCat Sparse Attention (LSA) — scales efficiently for 1M-context tokens
◆… pic.twitter.com/zum2SdZ0Z2
但实际上 LongCat 2.0 在我这的表现实在不太行(可能也跟我用的 Harness 是 OpenCode 有关)。有一次编辑器莫名其妙对一个 Bun 项目里的 scripts 报 tsc 错误,说找不到 node:fs 的类型定义,我就叫 AI 帮我看看。结果 LongCat 2.0 非要给我装 @types/node,但 Bun 项目根本不需要单独装这个,bun-types 已经内置了。换 GPT-5.6 Sol high 却能直接指出正解:你的 tsconfig.json 忘记把这个脚本 include 进去了。
……我勉为其难地拿它糊了一段时间个人项目以后,实在是不太想用了,但 Token Pack 里的配额还远远没用完。为了「浪费」掉这些 Token,让我自己的 Telegram 小团体热闹一点,我决定搞个群宠 Bot 玩玩……!
当然,为了烧一点 Token,我还不至于一开始就自己写一套 Agent Harness。2026 年已经有不少能直接接入 IM 的通用 Agent 产品了,比如 OpenClaw。我最后选了 Memoh,它跟 OpenClaw 差不多,但把 Agent 的工作空间放进了容器里,安全隔离做得更彻底,同样也提供官方的 Telegram 集成。
就这样,「塑料碗」上线了,给我群群友们带来了很多欢乐。
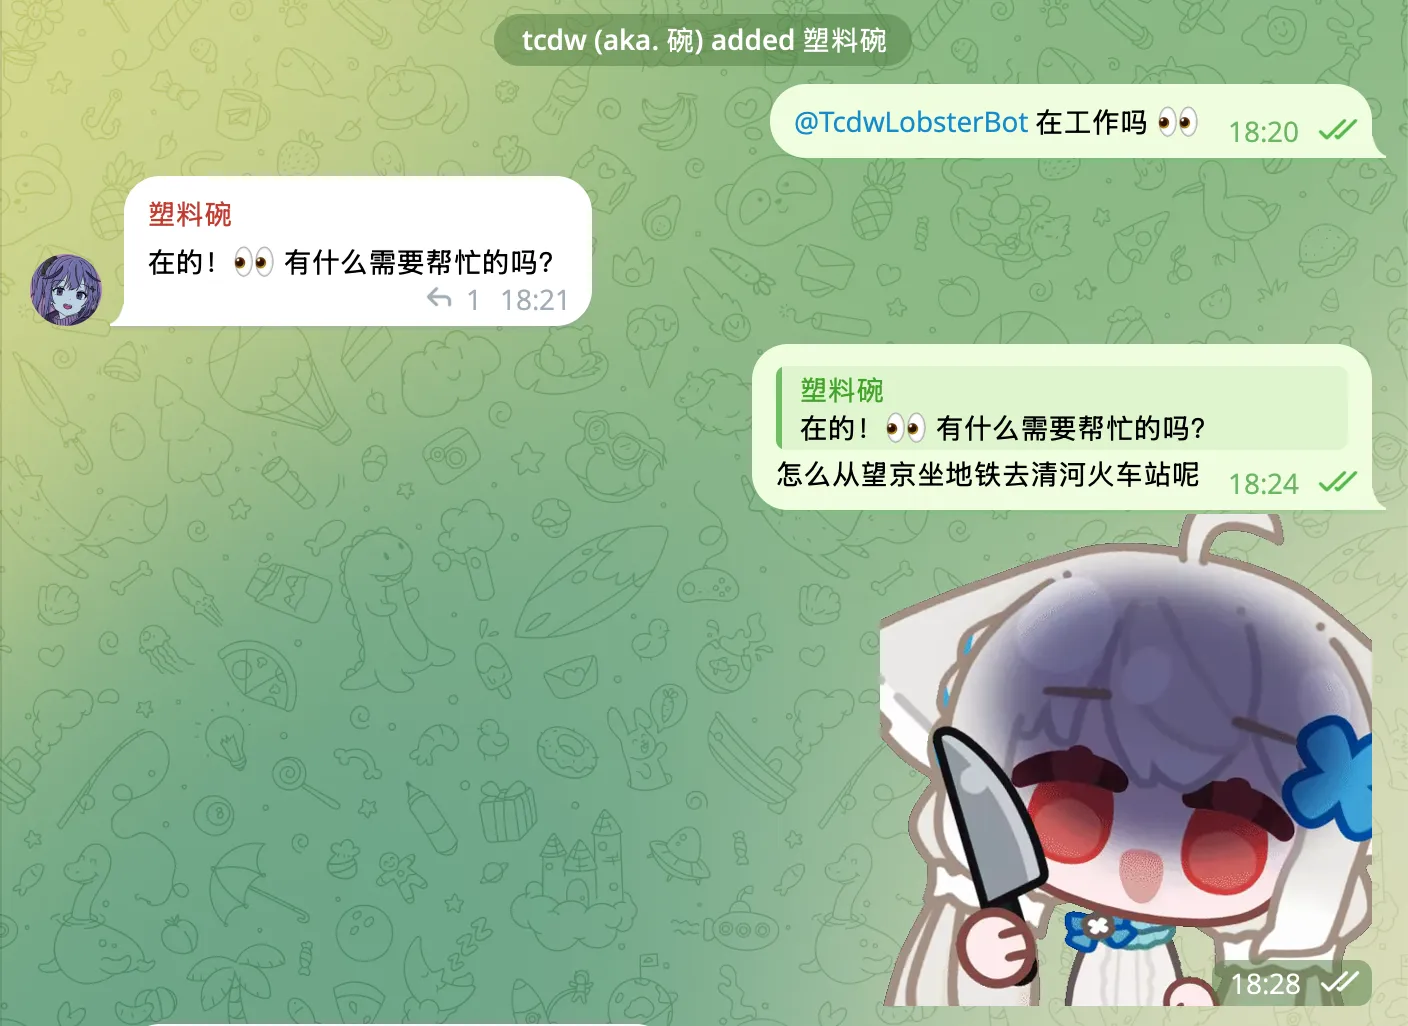
然后我发现,Memoh 有个设计,对普通 Agent 来说非常合理,对「群宠」却很奇怪:一个 Telegram 群,对应一个永久存在的 Agent Session。如果 Session 是围绕明确任务建立的,比如跟 Bot 私聊,或者几个人共享一个 Agent 协同干活,那这样其实没什么问题;毕竟我们开新会话的时候,一般都是叫 LLM 盯着一件具体的事一直干下去。
这种别扭在话题比较固定的小群还不算太显眼,就算模型注意力开始涣散、回答变得不对劲,手动重开一个新的 Agent Session 就好了。但群里人一多,问题就来了:
这时候,「一个群组就是一个会话」这个设计就开始变得奇怪了。消息确实按时间顺序一条条涌进群组,但这不意味着它们在内容上也属于同一场对话。更麻烦的是,我甚至很难指出一个明确的「新话题开始了」的时间点。话题 A 不一定在话题 B 开始的时候就结束了;它可能只是暂时没人说了,十分钟后又被人一条 Reply 重新捡起来。
既然如此,能不能不要让一个群对应一个 Session,而是在同一个群里同时维护多个 Session?
如果 IM 本身已经划好了对话边界,这个方案其实很好做。比如 Slack 的 Thread,大家围着一条消息聊,一个 Thread 自然就是一个 Agent Session;Session 的创建和切换根本不需要 LLM 判断,因为人在发消息的时候,顺手就已经替它把话题分好了。但 Telegram 的普通群聊不是这样,所有消息混在同一条时间线上。于是我还是得回答刚才那个绕不过去的问题:一条新消息,到底应该送进哪个 Session?
一个很符合 Agent 时代直觉的答案是:那就让 LLM 自己判断。
但仔细想想,「判断当前在聊什么,把每条消息准确地分到不同话题」,这对人类来说都不算容易。群聊里的话题经常交错、暂停、又重新冒出来,一句话也未必只属于一个话题。为了给 Bot 做一套精确的话题路由,反而可能越搞越复杂,Token 用量还蹭蹭往上涨。
这时候我换了一个思路:我们自己打开群聊的时候,通常也不会从几千条历史消息开始一条条回看,而是扫一眼最近几十条,大致判断一下大家在聊什么,然后自然地接上话。既然塑料碗本来就是个模仿人类群聊行为的群宠 Bot,那不如直接把这种方式搬过来。于是,塑料碗的工作流变成了这样:
实际把它放进多个群聊里跑了一段时间以后,我发现这套看起来相当朴素的方案,对大多数日常群聊场景已经够好用了。塑料碗确实只能直接看到最近 20 条历史消息,但群聊里的人本身就在不断地重复、引用和延续上下文。有人会回复前面的消息,有人会重新提起一个话题,也有人会顺手补一句「刚才那个……」。换句话说,群友自己就在帮它保存和传递上下文。
于是,塑料碗并不需要真的记住群里发生过的一切。很多时候,它只要像一个刚刚打开 Telegram 的普通人一样,看一眼最近发生了什么,就已经足以自然地把聊天接下去了。
不过,光靠「看一眼最近 20 条消息」还是不够的。群友们总会说一些自己的计划、偏好或者约定,比如「我明天要去杭州」「以后别用那个称呼叫我」。如果这些事情刚刚滑出 20 条消息的窗口,塑料碗就马上忘得一干二净,还是会显得很尴尬。
我一开始确实考虑过 RAG,但很快就放弃了:这场景根本用不着那么重的东西。群宠 Bot 不需要「从三个月前的聊天记录里检索出某条相关消息」,只需要「记住刚才说好的那件事」。为了这点需求上 Embedding、向量数据库加相关性召回,多少有点杀鸡用牛刀。于是我给塑料碗做了一个极轻的短期记忆系统,只给了它两个工具:
add_memory(content, ttl?)
delete_memory(id)
每条记忆就是一句话,Prompt 要求模型尽量控制在 100 字以内,Harness 这边则设了 150 字的硬上限。默认 TTL 一天,模型也可以自己估一下这件事大概能「活」多久,设长点或短点。所有当前有效的记忆拼成一个列表,直接塞进 System Prompt,不做任何检索,反正通常也没几条。
遗忘有两种路子。一种是自然遗忘:TTL 到期,自动消失。另一种是主动遗忘:塑料碗自己发现某条记忆过时了或者写错了,调用 delete_memory 删掉。模型不光能写记忆,也能忘。至于修改……先删掉旧的,再加一条新的就够了。所以这些记忆并不是一份只增不减的聊天摘要,更像是塑料碗自己维护的一小块临时状态:随手往头上贴的便利贴,想起什么就写一张贴上去,过期了就撕下来。
这里还有个带工程味的小细节:记忆列表严格按创建时间从早到晚排列,而且整块放在 System Prompt 的最末尾,前面依次是固定的系统指令和会话开始时间。这样一来,一次普通的 add_memory 基本就是在列表末尾追加一行,不会因为相关性、重要性或者剩余 TTL 变化,让已有的记忆反复重新排序。如果你用的模型支持 Prefix Cache,这样也能尽量保住已经缓存好的前缀。当然,TTL 到期或者调用 delete_memory 的时候,删除位置后面的缓存前缀还是会失效。但我觉得这完全可以接受。毕竟这套系统存在的意义,本来就是简单。
最后还有长期记忆的问题。塑料碗可以主动给一条记忆设很长的 TTL,系统并不会拦着它。但当 TTL 超过一个阈值(默认 30 天)时,这条记忆会在管理面板里被特别标出来,由我来判断是保留、删除,还是把它转进 System Prompt,正式变成长期设定。也就是说,模型可以提名哪些东西值得长期记住,但最终拍板固化的是人。
至于更复杂的记忆、检索和总结机制……等塑料碗真的需要记住三个月前发生的事情,再说吧。
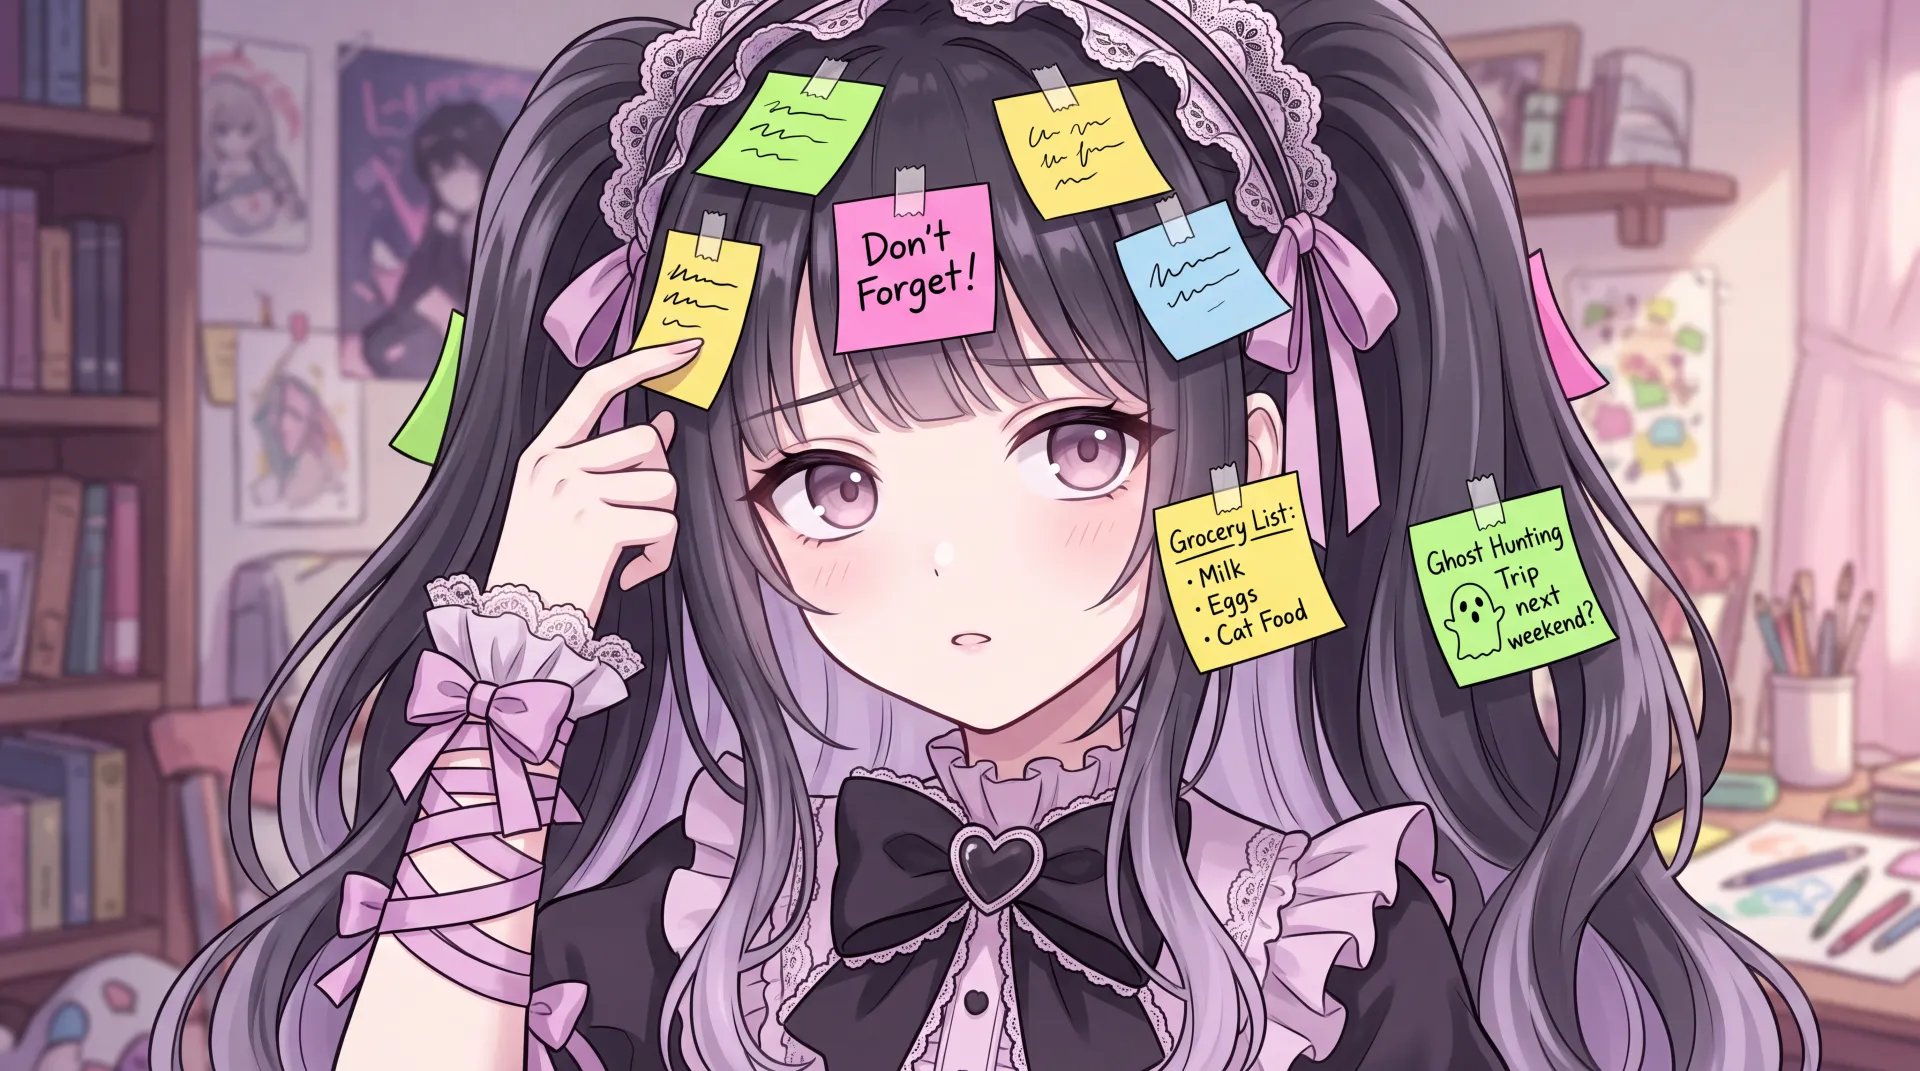
gemini-3.1-flash-image-preview到这里,最初那个「想办法把 ¥9.9 Token Pack 浪费掉」的目标,其实早就跑偏了。我原本只是想找一个现成的 Agent,接进 Telegram 群,烧一点用不完的 Token,顺便给群友们找点乐子。结果为了让它更像一个真正待在群里的「群友」,我先是换掉了现成的 Agent Harness,又重新设计了消息该怎么调度、上下文怎么管理,最后还给它做了一套只有两个工具的记忆系统。
嗯,初代塑料碗其实没有什么特别复杂的技术。它不会试图理解群里同时存在多少个话题,不会把所有聊天记录永久塞进 Context,也没有向量数据库替它回忆几个月前的事。它只是每次醒来看看最近的聊天,该记的就往头上贴几张便利贴,然后决定自己该说什么、做什么,或者干脆不说话。但这恰好越来越接近我想要的东西:不是一个被拉进群里的通用 Agent,而是一个真正为群聊这种环境设计的 Bot。
当然,这远远不是塑料碗最后的样子。它在多个群组里跑得越久,一些当初根本没想过的问题也开始冒出来;随着 Harness 的能力越来越多,现有的架构也渐渐碰上了自己的天花板。不过,那就是下一阶段的故事了。毕竟一开始我真的只是想浪费掉那点价值 9.9 的 Token,结果为了这一瓶醋,我不但包了一盘饺子,还顺手造了个厨房。
未完待续。
想要试玩塑料碗嘛?其实现在就可以加入我的 「塑料碗橱」Telegram 群组 来试玩,或者来博主的 Telegram 频道 的讨论群也行(入群需审核)。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。