

惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

酷 壳 – CoolShell
酷 壳 – CoolShell
G
Google Developers Blog
L
LangChain Blog
Y
Y Combinator Blog
Vercel News
Vercel News
WordPress大学
WordPress大学
大猫的无限游戏
大猫的无限游戏
博客园 - Franky
V
Visual Studio Blog
小众软件
小众软件
月光博客
月光博客
A
About on SuperTechFans
H
Hackread – Cybersecurity News, Data Breaches, AI and More
T
The Blog of Author Tim Ferriss
有赞技术团队
有赞技术团队
M
MIT News - Artificial intelligence
阮一峰的网络日志
阮一峰的网络日志
Last Week in AI
Last Week in AI
博客园 - 【当耐特】
让小产品的独立变现更简单 - ezindie.com
MongoDB | Blog
MongoDB | Blog
Jina AI
Jina AI
美团技术团队
量子位

陈少文的网站

巨变与机遇的未来十年 Kubernetes 平台管理软件压力测试方案 使用镜像部署 Hexo 静态页面 终于等到你 - GitHub 镜像仓库服务(ghcr.io) 一起来学 Go --(6)Interface 一起来学 Go --(5)Goroutine 和 Channel 什么是函数式编程 如何在 Kubernetes 集群集成 Kata 柯里化与偏函数 使用 PyGithub 自动创建 Label 软件产品是团队能力的输出 Helm 2 、Helm 3 比较 IoT 变现 Kubernetes 中的 DNS 服务 国内的 Helm 镜像源 Harbor 使用自签证书支持 Https 访问 DevOps 工具链之 Prow 如何使用 kfctl 安装 Kubeflow VS Code 无法下载 Go 插件的工具包 工程师更应具有服务精神 你不知道的 Docker 使用技巧 使用 Docker 运行 Tensorflow 论中国 什么是左移 如何清空 Git 仓库全部历史记录 一禅小和尚 有风吹过厨房 时间的玫瑰 如何在 CentOS 安装 GPU 驱动 开发 Tips(19)
什么是 PD 分离
微信公众号 · 2024-09-08 · via 陈少文的网站

Please enable Javascript to view the contents

1. 定义

LLM 推理过程中存在着两个截然不同的阶段,PD 分离就

  • 计算密集型的 Prefill 阶段,

LLM 处理所有用户的 input,计算出对应的 KV Cache

  • 显存密集型的 Decode 阶段,

顺序的产生一个个的 token,每次访存只计算一个 token

2. 指标

2.1 prefill 性能评估指标

TTFT(Time To First Token),表示生成第 1 个 token 所用的时间

P90 TTFT SLO = 0.4s,意味着我们对该系统的要求是:90%的 request 的 TTFT 值都必须<=0.4

2.2 decode 性能评估指标

TPOT(Time Per Output Token),产出每一个 response token 所用的时间

P90 TPOT SLO = 0.04s,意味着我们对该系统的要求是,在 90% 的 request 的 TPOT 值都必须<=0.04s

3. PD 分离带来的优势

在 long context 背景下,prefill 和 decode 阶段对计算和显存的需求非常不平衡。

  • 充分利用设备资源

prefill 采用高算力的 GPU,decode 采用低算力大显存的 GPU

  • 分开优化,能同时提升 TTFT 和 TPOT 指标

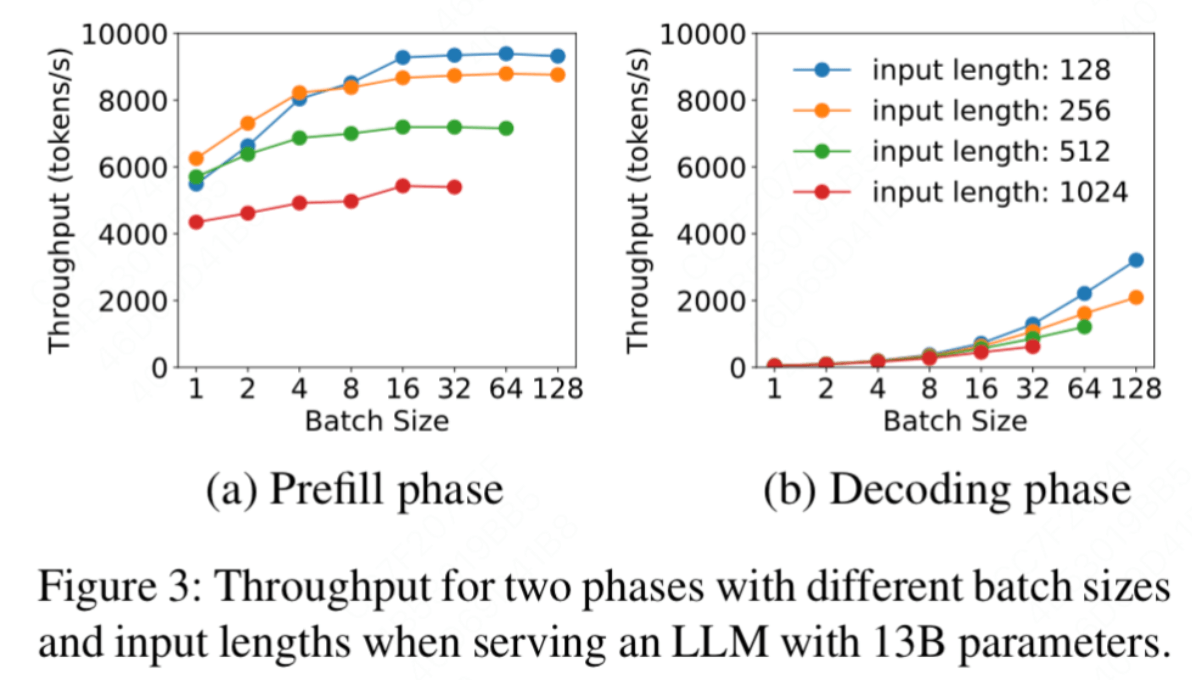
prefill 阶段应该限制 Batch Size 大小,decode 阶段应该增大 Batch Size 大小

4. batching 策略
  • prefill 阶段

因为 prefill 阶段是计算密集型,随着 batch size 的增加,算力受限,吞吐量的增长趋势趋于平缓。

  • decode 阶段

因为 decode 阶段是带宽、内存密集,随着 batch size 的增加,吞吐量的增长趋势越来越显著。

5. 参考


微信公众号