





1. 为什么需要定义应用运行时
运行时更多选择。传统的应用运行时有,物理机、虚拟机、云主机。容器时代,常见的运行时有 Docker、Kubernetes。这些运行时,提供给我们的不再是一个单一的运行时选择。
应用拓扑更复杂。如果由 CMDB 统一存储应用的拓扑结构,当然是最好的,其他系统有了统一的数据源。但现实是,我们很难有这样的远见,当急需这样的拓扑时,开发功能、录入数据、保持一致性都极其不易。
不同运维系统使用这些运行环境时,呈现的拓扑可能会不一样。如下图:
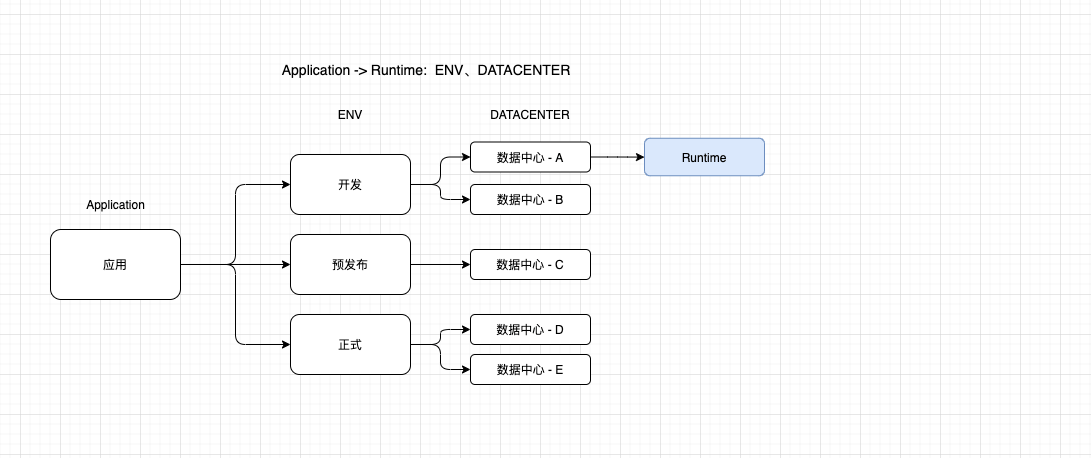
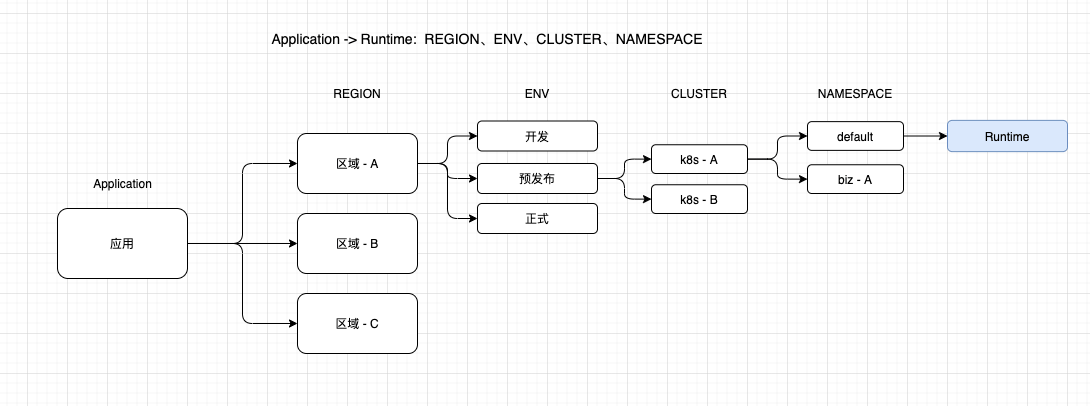
这里有两个运维系统:
- A 的视角是应用下,先有环境,再分数据中心,才能定位到某一个具体应用。
- B 的视角是应用下,先要选区域,再选环境,接着选集群,还有命名空间之后,才能定位到某一个应用。
缺少统一应用拓扑带来的问题就是,每个运维系统都需要描述一套自己的应用拓扑。由此带来的问题不言而喻,新业务接入成本高,系统与系统之间不容易对接,各个运维系统使用难度大。对开发、运维开发、运维,都会产生消耗。
推动 CMDB 统一存储应用拓扑的方案在此不表,我们需要思考的是如何定义应用的运行时,能够解决当前的问题: 在不同运维系统视角,应用的拓扑不一致,但却提供给用户一致的体验。
2. 应用运行时的定义
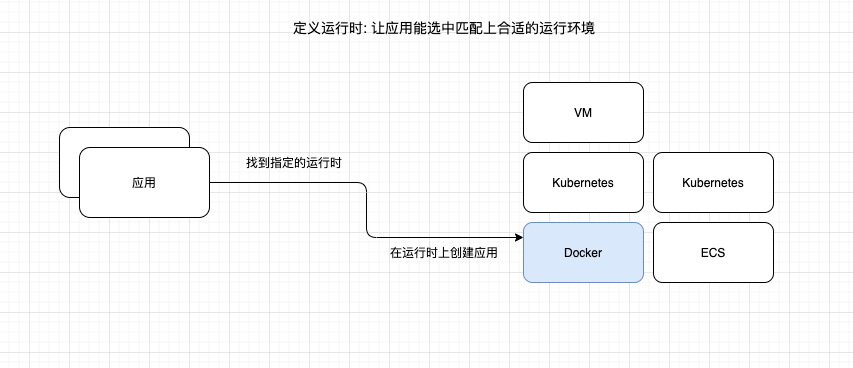
我们的服务器可能分散到不同的区域、所属不同的厂商、具有不同的类型,应用的运行时定义就是在这些运行时提供者与应用之间建立联系。当创建应用时,能够再找合适的运行时,在运行时上创建工作负载。
回忆一下,通常情况下,运维系统会怎样选择一个运行时。如下图:
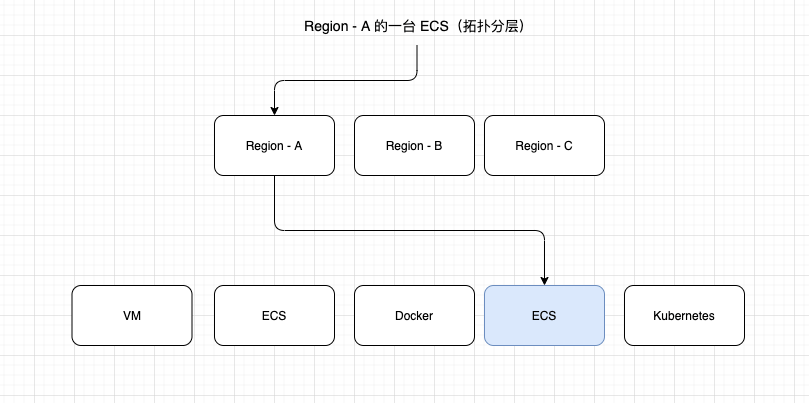
首先给用户呈现的是区域,东北、华中、华南、亚太、新加坡等,再选择使用虚拟机、容器、Kubernetes。过了一段时间,我们发现用户更关注的不是区域,而是运行时类型,因此对运维系统进行了调整。如下图:
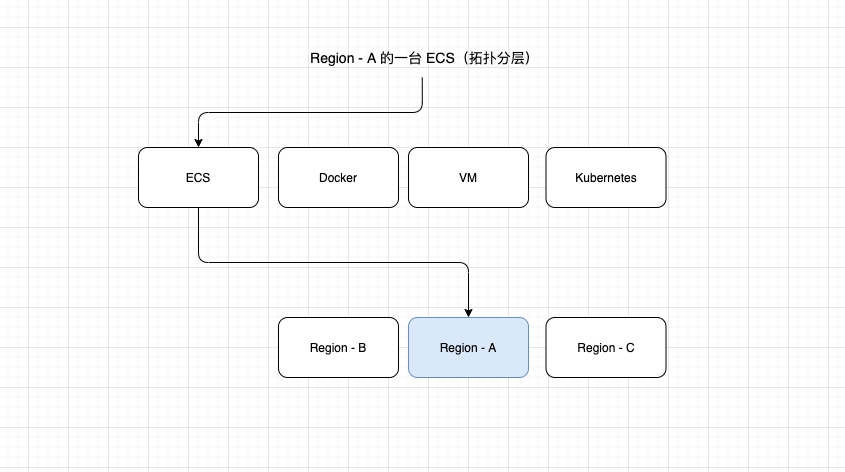
我们将一级菜单选设置为虚拟机、容器、Kubernetes,二级菜单设置为区域设置为东北、华中、华南、亚太、新加坡等。过了一段时间,我们发现,在区域下得加一个层级数据中心,运维系统又得进行适配。
浏览我的网站时,你会发现,它没有分类,只有标签。因为给一个文章选一个分类其实并不是一件容易的事,它具有唯一性,但一篇文章可以有很多个标签。
这就是分类和标签的主要区别。分类构建的是一个线性单一的网络,而标签构建的是一个网状互联的网络。 标签系统是内含分类系统的。
借助标签系统,我们可以很好的描述应用的运行时,同时兼容 CMDB 单一拓扑源。如下图:
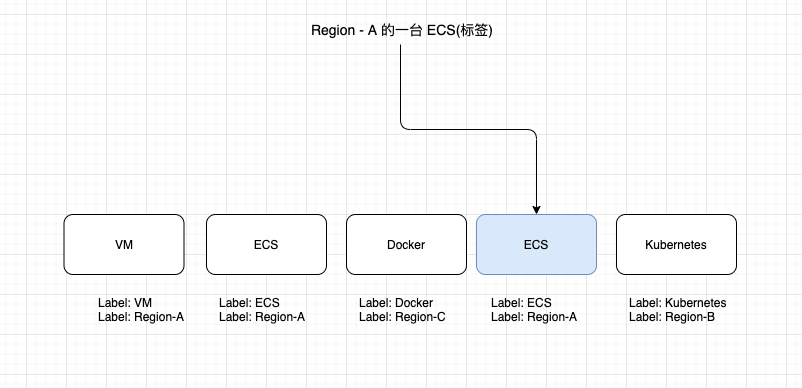
无论运维系统如何呈现应用的拓扑,标签系统都能够满足。使用一组标签定义应用运行时,主要的成本在于,开发高效地标签过滤系统,并维护好标签。这与 Kubernetes 中的 Label 类似,可以参考。
3. 系统与系统之间的对接
运维系统不是单一的,它们是相互协作,共同作用的。
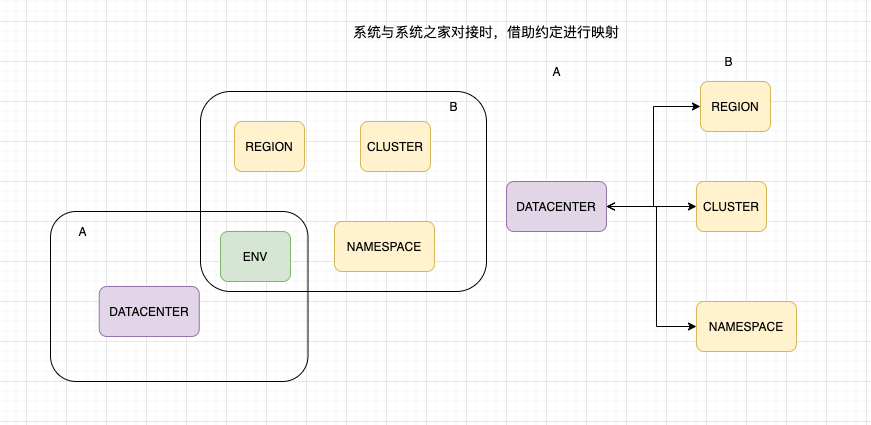
如上图,当两个运维系统对运行时的定义不同时,需要借助一定的约定规则进行映射。而各个系统只需要关注自己的运行时,不必为了兼容而留下没人维护的冗余字段。缺失比错误更优。
这里的 DATACENTER 与 REGION、CLUSTER、NAMESPACE 产生映射关系。但 A 系统并不关心 NAMESPACE 。 因此,我们可以将 DATACENTER 与 REGION、CLUSTER 的对应关系持久化存储,或者通过约定进行映射,比如,将 DATACENTER 命名为 REGION-CLUSTER 的形式。
另外一点就是,各个运维系统在管理这些运行时,应该尽可能将运行时的描述注入到环境变量,比如 ENV=DEV、REGION=HW-BJ 等,开发人员可以利用这些变量进行适配,有利于调试和定位问题。