惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

The GitHub Blog
The GitHub Blog
S
SegmentFault 最新的问题
MyScale Blog
MyScale Blog
有赞技术团队
有赞技术团队
V
Visual Studio Blog
T
The Blog of Author Tim Ferriss
爱范儿
爱范儿
Vercel News
Vercel News
让小产品的独立变现更简单 - ezindie.com
Y
Y Combinator Blog
Blog — PlanetScale
Blog — PlanetScale
D
DataBreaches.Net
美团技术团队
Microsoft Security Blog
大猫的无限游戏
大猫的无限游戏
Cyber Security Advisories - MS-ISAC
酷 壳 – CoolShell
酷 壳 – CoolShell
GbyAI
GbyAI
A
About on SuperTechFans
云风的 BLOG
云风的 BLOG
The Cloudflare Blog
宝玉的分享
宝玉的分享
V
V2EX
Microsoft Azure Blog

AI Slop

API 中转站能看到你全部 prompt 和回复,为什么没有一个「厂商端到端加密」的标准? - V2EX 别让 AI 背资料库,让它翻资料库 - V2EX 你的 AI 助手把活干到一半就忘了:一个开源项目,让任务跨会话接得上 - V2EX 那不是技术决策,那是价格决策 - V2EX 你的 AI 助手每天都在「失忆」:一个开源项目,把记忆蒸馏成永久资产 - V2EX 我把一个开源 PR 全权交给 AI 后,差点把维护者变成免费 Reviewer - V2EX Ainexa 创始人决策雷达 #48 - V2EX 小遥 Claw:「把 AI 助手装进自己的电脑」 - V2EX 从夯到拉锐评现存大模型 - V2EX V2EX › 登录 给 OpenClaw AI 助手一个「家」:一个从事故里长出来的开源项目 - V2EX 关于反酸嗳气、关于轻断食简单饮食、关于 vibecoding...... - V2EX 拿完永住,再聊聊在日本这大半年 - V2EX V2EX › 登录 DeepSeek Harness 的 feature list - V2EX 跟着 DSH 发布,今晚开源了三个小东西 - V2EX XiaoyaoClaw V2EX 内测邀请|把 AI 助手装进自己的电脑 - V2EX 炸了, macOS 26 钥匙串突然无法访问,几乎所有软件的登录、激活、认证状态瞬间归零 - V2EX 前端转 AI 全栈,到底应该按什么顺序学? - V2EX 面试背了八大排序,工作几年后发现大部分用不上 - V2EX 用了大半年 AI 工具,说说哪些真提效、哪些是智商税 - V2EX AI 写的 HTML 越来越多,版本该怎么管理?我的答案是 Gist - V2EX 周蕊 160 天 - V2EX Claude Code 的 Prompt Cache 到底怎么工作? 5 个让缓存失效的坑 - V2EX 一个退休护士的登记本 - V2EX 活人——一个社区护士的五十四天 - V2EX 关于更换操作系统后 TimeMachine 无法备份的解法 - V2EX 假到位 - V2EX V2EX › 登录 V2EX › 登录
深入 Cursor 架构:一个 AI 编辑器是如何被「流式」重塑的 - ...
xdlkc · 2026-07-29 · via AI Slop

导读:这不是「怎么用 Cursor 」的教程,而是一篇纯架构设计视角的复盘。

我们不聊功能、不聊快捷键,只回答一个问题——如果让你从零设计一个 AI 编辑器,你会遇到哪些绕不开的架构约束? Cursor 又是怎么回答它们的?

读完你会得到一套「 AI 应用到底难在哪」的结构化认知。全文脉络:

三个约束(流式 · 低延迟 · 上下文)→ 两个核心机制( Agent 状态机 · 多进程隔离)→ 一个飞轮 + 一处代价可迁移的架构启示

在看任何具体实现之前,先做一次第一性原理推导。一个「 AI 原生」的编辑器,天然被三个约束框死:
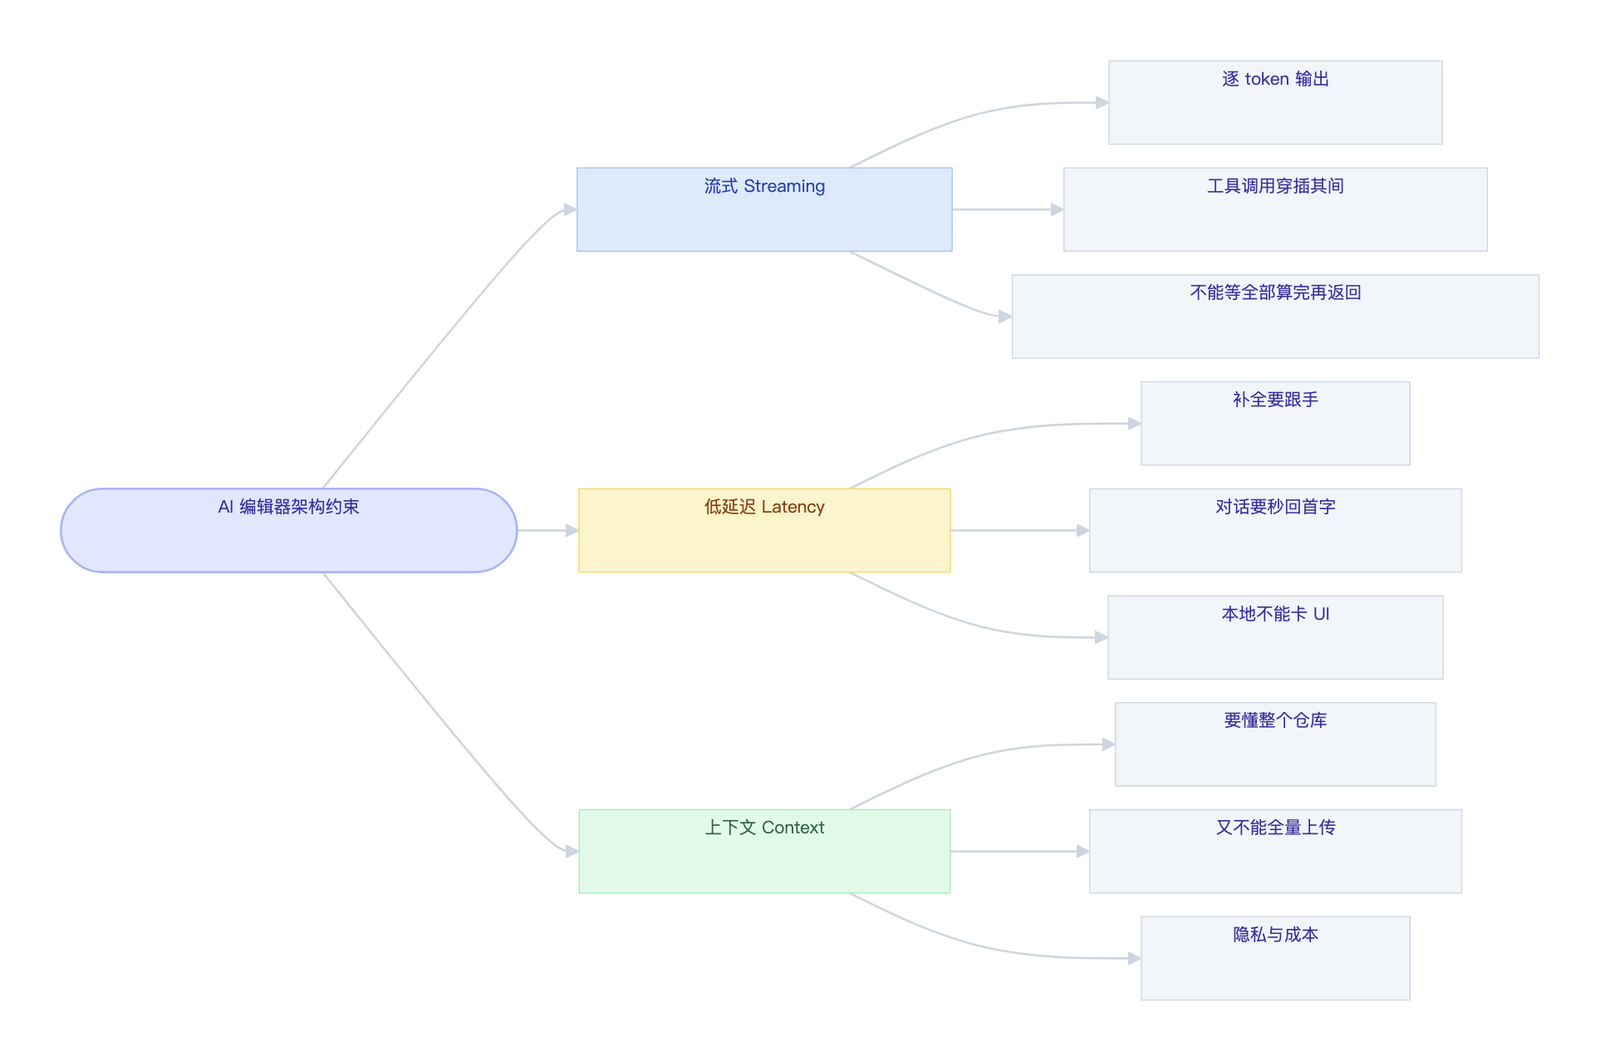
图 1 · AI 编辑器绕不开的三大架构约束

图 1 · AI 编辑器绕不开的三大架构约束

这三条,几乎决定了后面所有的架构选择。你会看到 Cursor 的每一个设计,都能回溯到其中某一条。下面逐条展开。

二、约束一:流式为什么是一等公民

传统 Web 应用的心智是请求-响应:发一个请求,等一个完整结果。但 AI 交互不是这样——

  • 模型是逐 token 生成的,用户希望边生成边看到;
  • Agent 模式下,一次「回答」中间可能穿插多次工具调用(读文件、跑命令、改代码);
  • 补全需要边打字边出建议

这意味着「流式」不能是事后打的补丁,而必须是架构的第一性假设。它带来的连锁反应是系统级的:
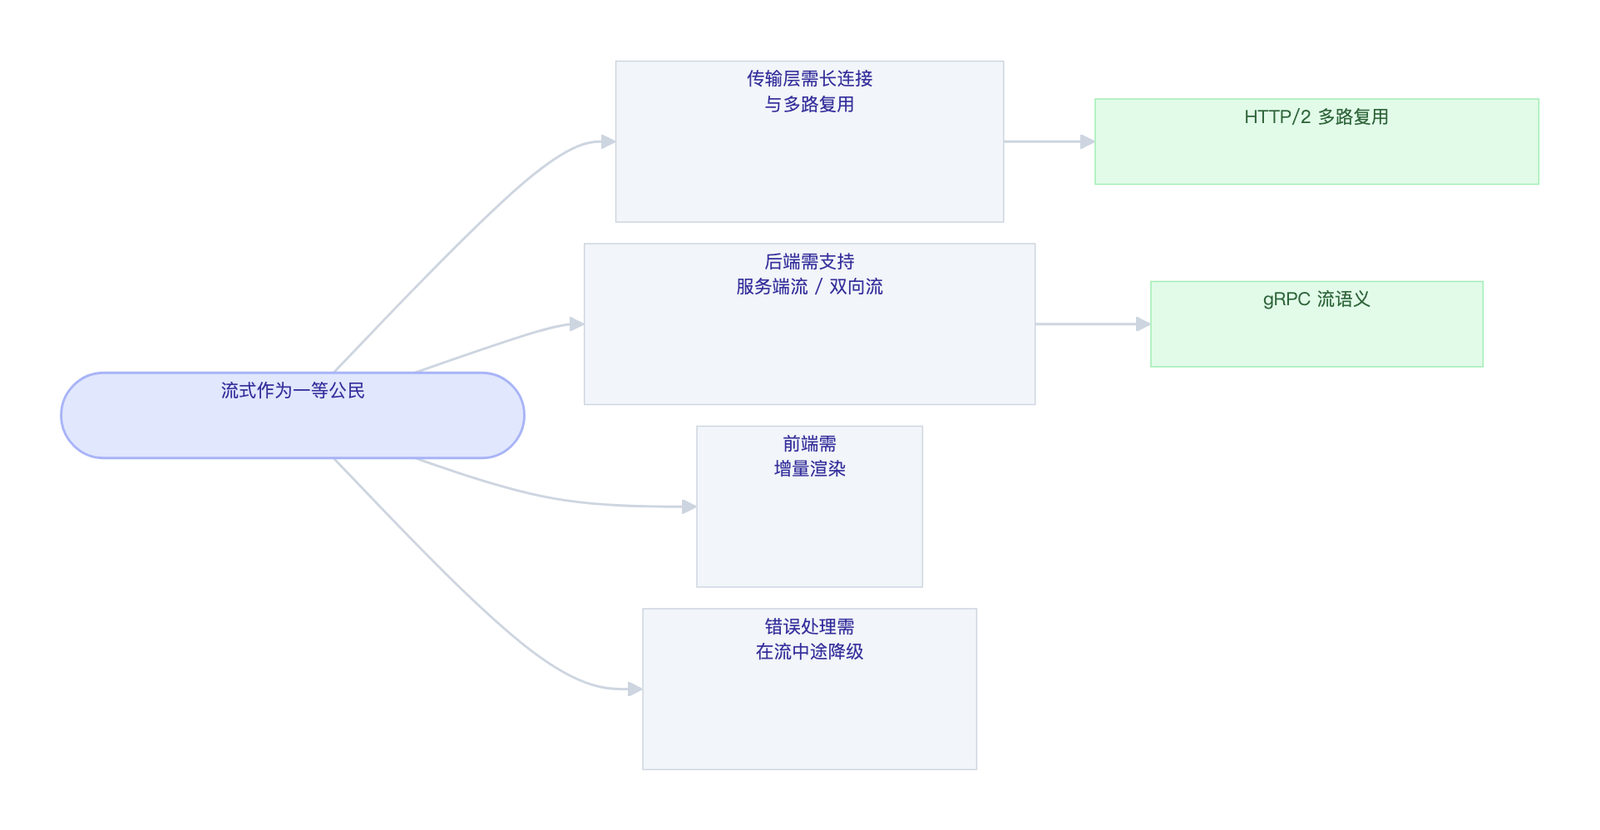
图 2 · 「流式优先」如何自上而下地约束整个技术栈

图 2 · 「流式优先」如何自上而下地约束整个技术栈

关键洞察:正因为流式是一等公民,Cursor 才在传输层选了支持多路复用与长连接的方案,而不是传统 REST 。协议只是结果,「流式优先」这个决策才是原因。

同样是做流式,思路对不对,结果天差地别:

  • ❌ 把流式当成「最后接个 SSE 」补上去 → 错误处理、重试、状态管理全线崩溃;
  • 从数据流向的第一步就假设「一切都是流」 → 整条链路自然统一。

三、约束二:低延迟 —— 分道设计与延迟预算

1. 不同交互,延迟预算天差地别

AI 编辑器里有几类交互,延迟预算完全不同

交互类型 延迟预算 调用频率 架构取向
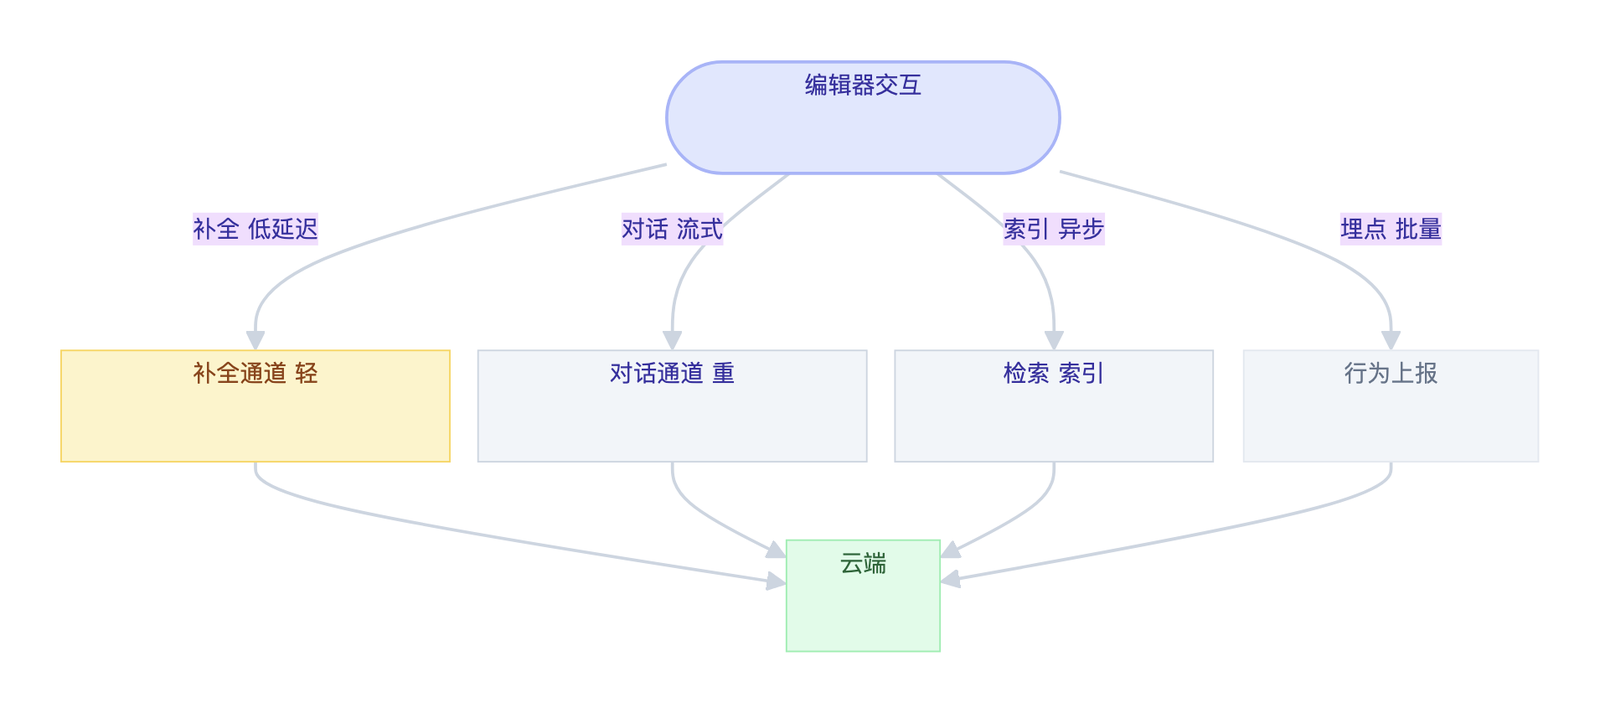
代码补全 几十 ms 首响 极高 · 每次按键 独立轻通道,极致低延迟
对话 / Agent 秒级首字可接受 重通道,可长可流
代码库索引 后台,可慢 异步,进程隔离
行为上报 无所谓 批量,旁路

2. 解法:按延迟预算分道

  • ❌ 不成熟:所有流量混在一个接口 → 高频低延迟的补全,被重量级对话拖垮
  • ✅ 成熟:分道——不同性质的流量走不同通道、各设各的延迟预算。

图 3 · 按延迟预算分道:补全与对话是两套独立通道

图 3 · 按延迟预算分道:补全与对话是两套独立通道

这就是为什么 Cursor 的补全( Copilot++)和对话在架构上是两套东西:它们对延迟的要求差了一到两个数量级,硬塞进一个通道必然互相拖累。

四、约束三:上下文 —— 一条被低估的流水线

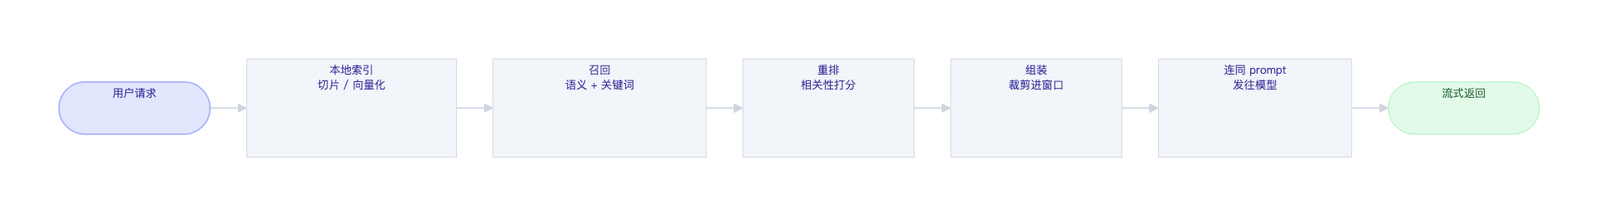
「 Cursor 懂你的整个仓库」听起来像模型能力,其实主要是工程能力。因为模型的上下文窗口有限、全量上传既慢又不安全,真正决定体验的,是一条上下文工程流水线

图 4 · 上下文工程流水线:召回 → 重排 → 组装 → 入窗

图 4 · 上下文工程流水线:召回 → 重排 → 组装 → 入窗

这条流水线里,每一步都是独立的工程难题

  • 索引:大仓库要在本地增量建索引,不能每次全量扫;
  • 召回:语义检索 + 符号/关键词检索的混合;
  • 重排:召回一堆候选,靠打分决定谁进有限的上下文窗口;
  • 组装:在 token 预算内,权衡「当前文件 / 相关文件 / 最近改动 / 报错信息」谁更重要。

一个反直觉的结论:AI 编辑器的护城河,很多时候不在模型,而在这条「把对的上下文、在对的预算内、以对的顺序喂给模型」的流水线上。模型大家都能调,上下文工程才是手艺

而 Cursor 选择在本地做索引、按需上传片段,恰恰是对「上下文」与「隐私 / 成本」两个约束的联合回答。

五、核心机制其一:Agent Loop —— 把对话建模成状态机

1. 一次回答,是一条开着的流

Agent 模式是 Cursor 体验的核心,它的架构本质是一个带工具调用的循环状态机,而不是一问一答:
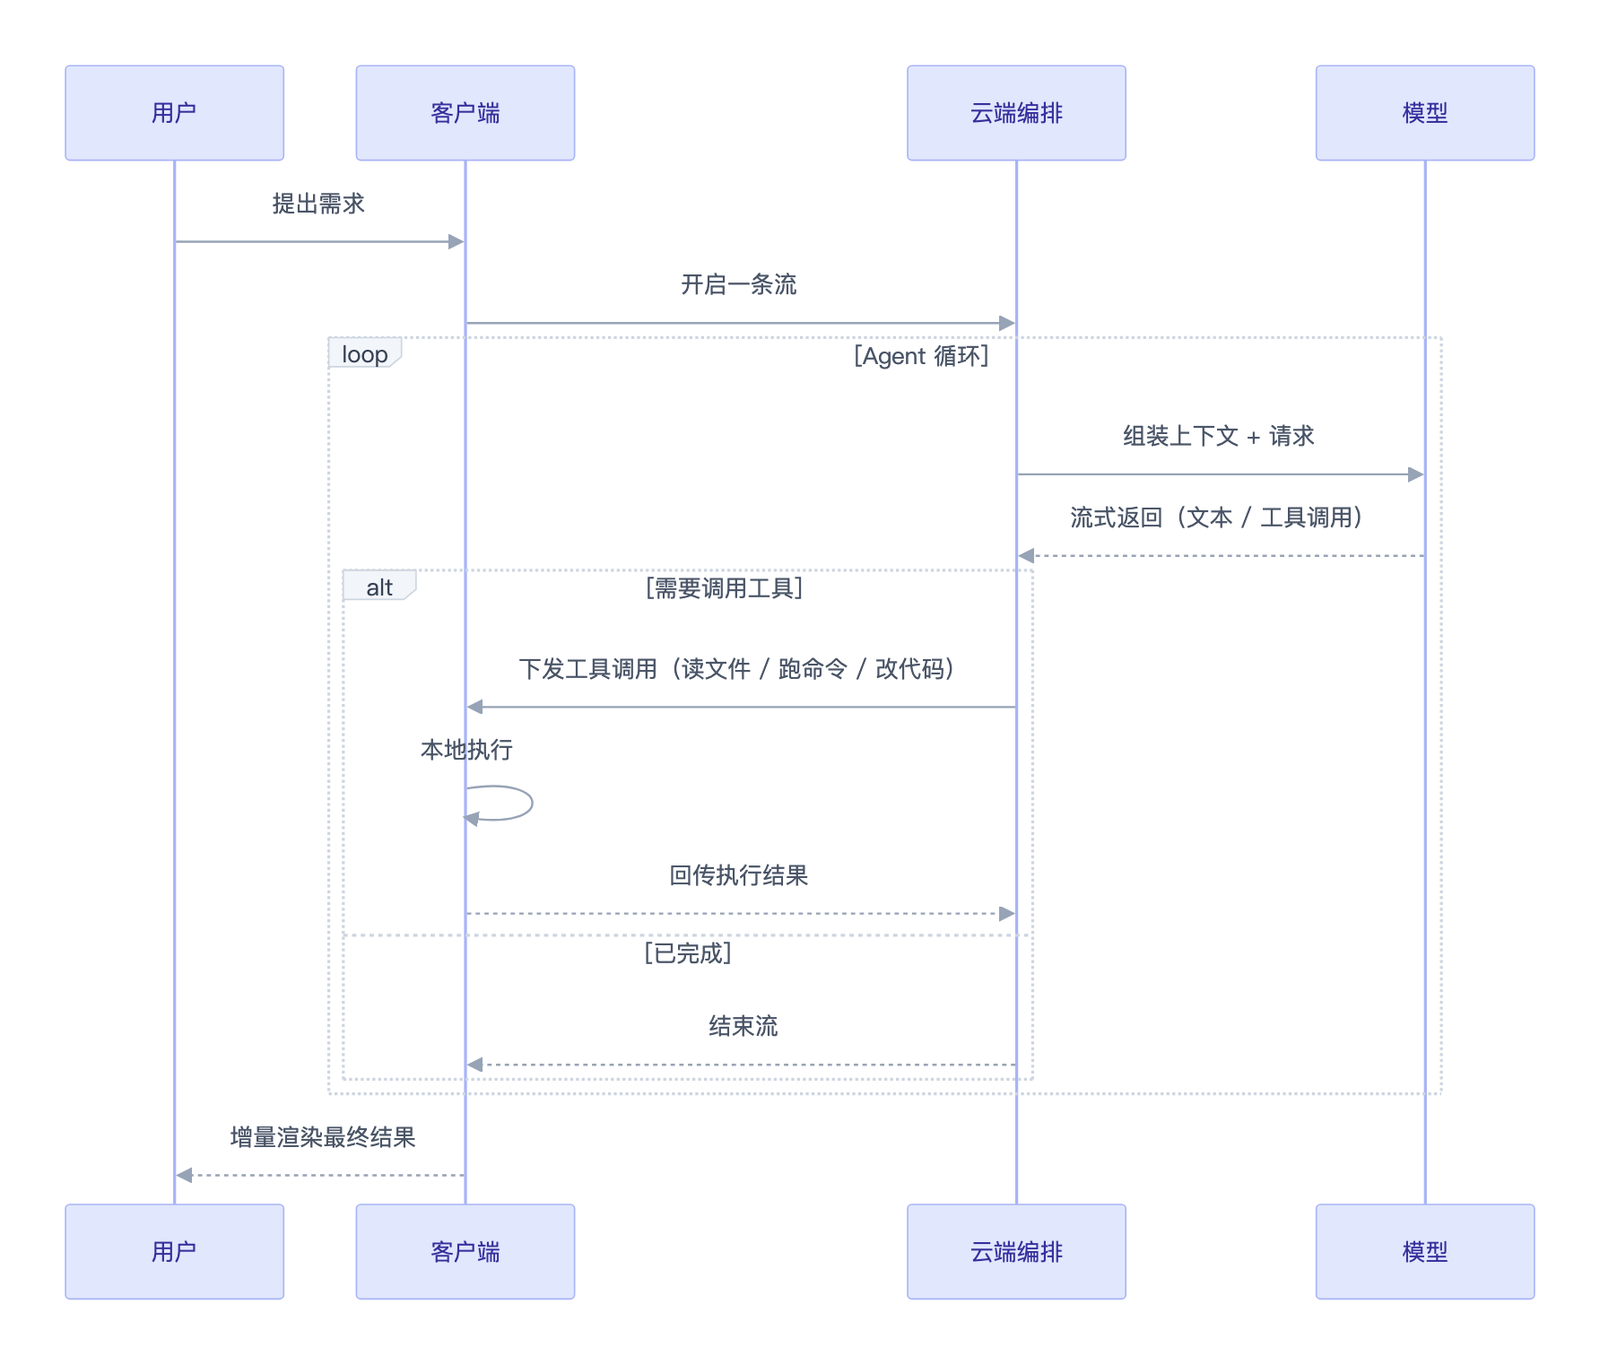
图 5 · Agent 循环:一条长期开着的双向流,工具调用穿插其中

图 5 · Agent 循环:一条长期开着的双向流,工具调用穿插其中

2. 三个架构含义

  1. 一次「回答」是一条长期开着的双向流,而非多个独立请求——这就是它需要双向流语义的原因;
  2. 编排逻辑放在云端:由服务端决定「下一步是继续生成还是调工具」,客户端只负责执行与渲染;
  3. 工具在客户端执行:读文件、跑命令这些必须在你本地发生,结果再回传。

「能力在云、执行在端」——这句话基本概括了 Cursor 的 Agent 架构。

六、核心机制其二:客户端不是一个进程

1. 进程怎么分

Cursor 基于 VS Code ,继承了它的多进程架构,并在上面叠了 AI 层:
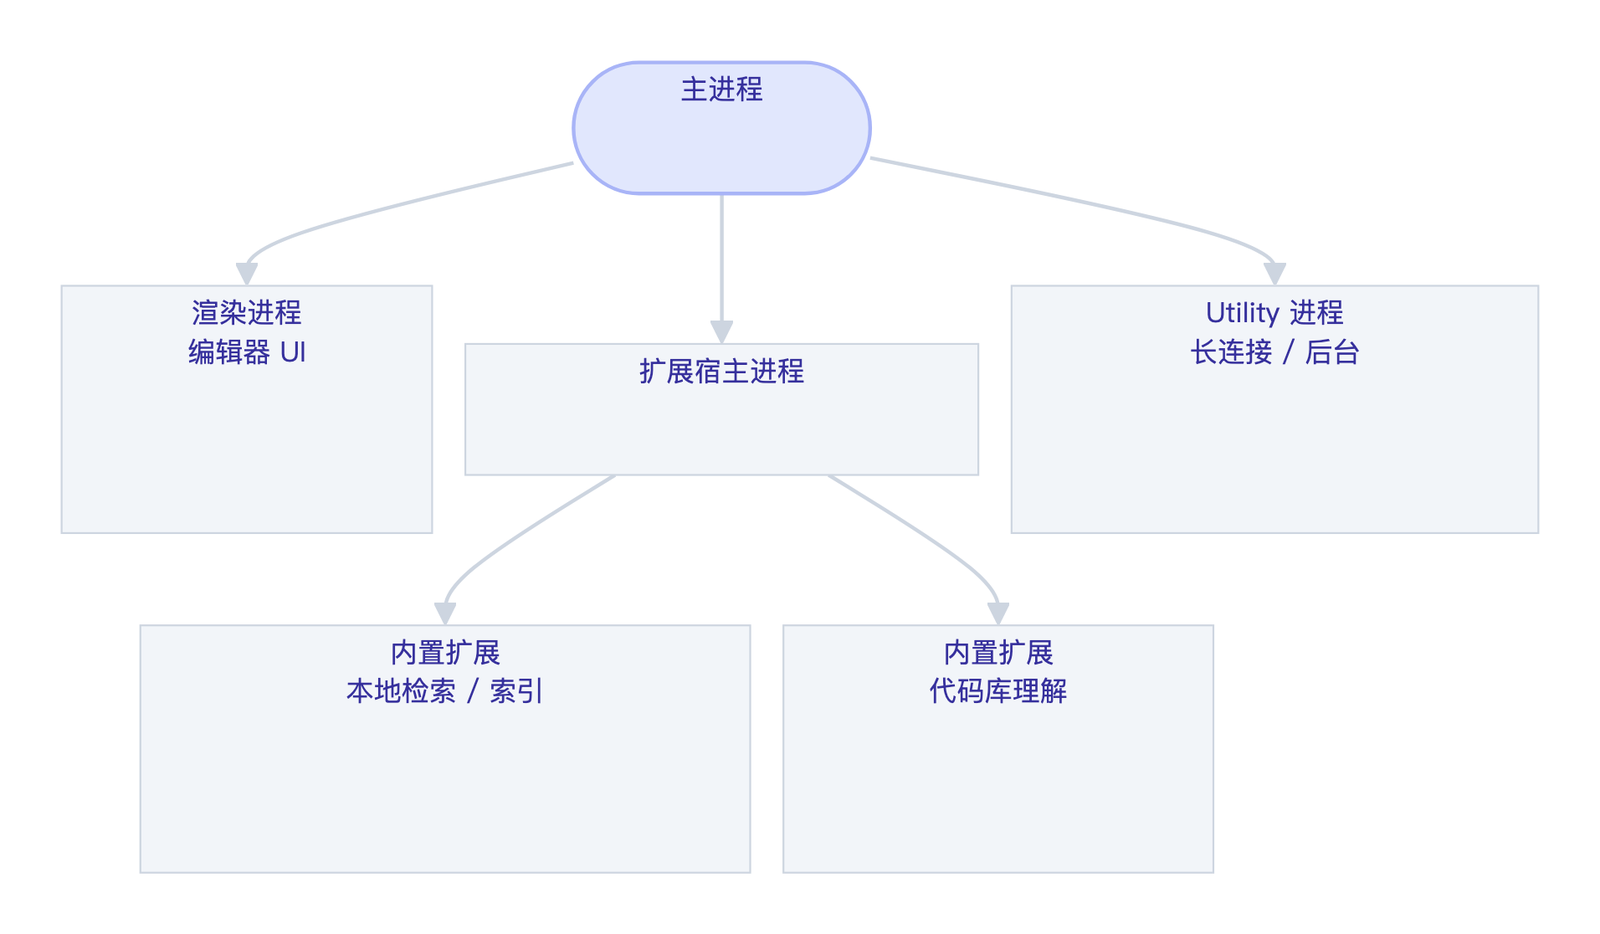
图 6 · 多进程结构:UI 、扩展宿主、后台各自隔离

图 6 · 多进程结构:UI 、扩展宿主、后台各自隔离

2. 为什么值得拆这么细

因为这几类活性质完全冲突

工作类型 资源特征 若不隔离的后果
UI 渲染 要跟手、延迟敏感 被后台任务卡住 → 掉帧
本地索引 CPU / IO 密集 抢占 UI 资源 → 卡顿
长连接通信 长期驻留 进程崩溃 → 波及编辑器

多进程是用「复杂度」换「隔离性」:性能隔离(重活不拖累 UI )+ 故障隔离(一个进程崩了不整个挂)。

代价也很实在:跨进程的状态同步、版本一致性会变得很复杂。这也是为什么这类产品每次大版本升级,通信与进程结构都可能改动——进程越多,「保持一致」就越难。

七、一个飞轮:把使用数据变成燃料

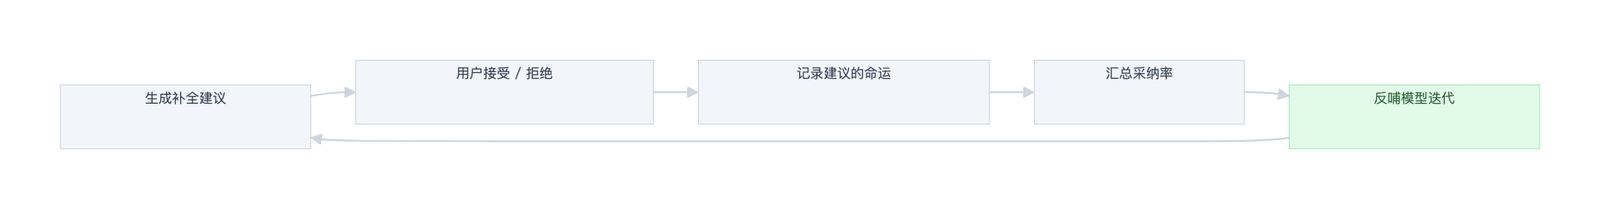
值得单独一提的架构设计:补全不是单向输出,而是带反馈回路的闭环。

图 7 · 数据飞轮:每一次 Tab ,都是给下一版模型的信号

图 7 · 数据飞轮:每一次 Tab ,都是给下一版模型的信号

从架构上看,这是一个数据飞轮:每一次你按下 Tab 接受、或忽略一个补全,都在为下一版模型提供信号。

产品用得越多 → 数据越多 → 模型越准 → 用得更多。

设计自己的 AI 产品时这点极具参考价值:在架构里预留「结果反馈」的埋点,比事后补要容易得多。

八、一处代价:强依赖网络

任何架构都有取舍。Cursor 「重云端」的选择,换来了飞快的迭代能力(编排逻辑在服务端,改一次全员生效),但代价同样明确:
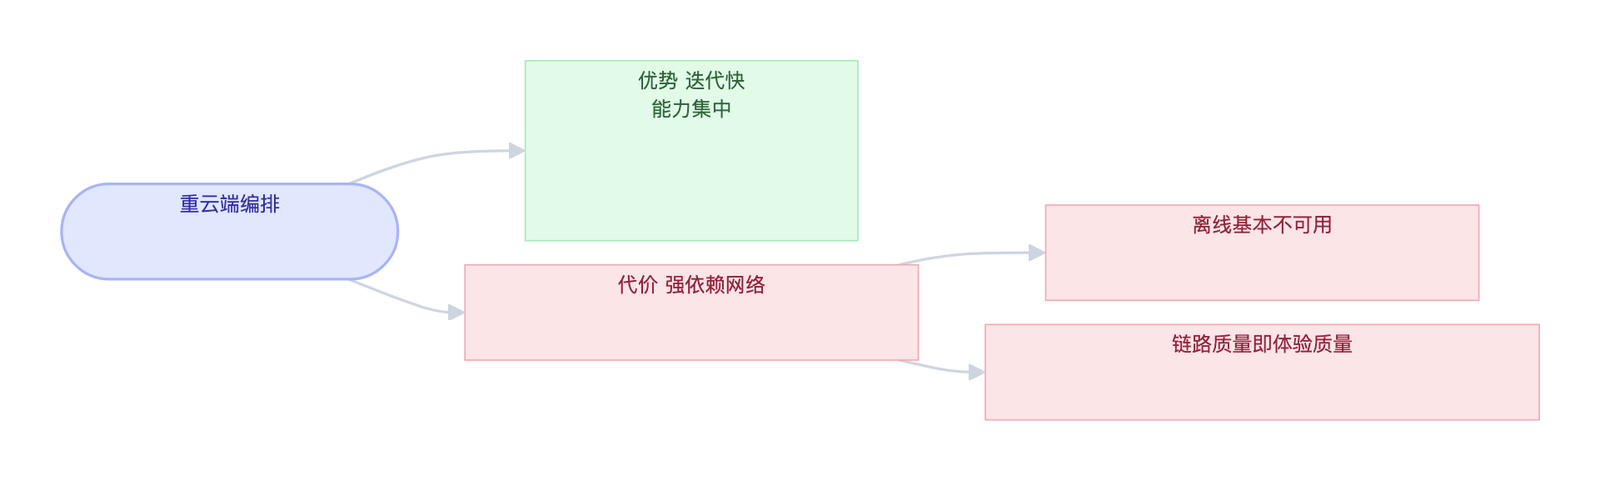
图 8 · 重云端的取舍:换来迭代速度,代价是强依赖网络

图 8 · 重云端的取舍:换来迭代速度,代价是强依赖网络

「链路质量直接等于体验质量」——这一条对网络环境不理想的用户尤其明显:同样的模型,链路差一点,流式就会卡顿、断流、超时。理解了这条,你就理解了为什么 AI 编辑器对网络如此敏感:它不是「偶尔联网」,而是几乎每个核心操作都在和云端进行长连接流式对话

九、可迁移的架构启示

抛开 Cursor 本身,这套架构给「想做 AI 应用」的人几条可复用的经验:

  1. 把流式当第一性假设,而不是最后接个 SSE ;
  2. 按延迟预算分道,别让高频低延迟操作和重任务共用通道;
  3. 上下文工程是护城河,在检索 / 重排 / 组装上下功夫,收益常大于换模型;
  4. Agent = 状态机,用「能力在云、执行在端」的思路划分职责;
  5. 预留反馈闭环,让产品越用越准;
  6. 想清楚云 / 端取舍,重云端换迭代速度,但要为网络退化设计降级。

小结

Cursor 表面是编辑器,骨子里是一套围绕「流式 AI 交互」设计的分布式系统。它的每个设计几乎都能回溯到三个约束——流式、低延迟、上下文

  • 为「流式」,通信层选了长连接与流语义;
  • 为「低延迟」,把补全和对话分道、各设延迟预算;
  • 为「上下文」,做了本地索引 + 上下文流水线
  • 多进程换隔离,用反馈闭环换持续变准;
  • 重云端换迭代速度,代价是强依赖网络。

看懂这套架构,不只是满足好奇,更能帮你判断:什么场景该信任它、什么场景它会掉链子——以及,如果轮到你设计 AI 应用,哪些坑可以提前绕开。


同样的模型,链路差一点,流式体验就会差一截。如果你也在做 AI 应用架构,或踩过类似问题,欢迎评论区交流。