惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

让小产品的独立变现更简单 - ezindie.com
V
V2EX
WordPress大学
WordPress大学
U
Unit 42
I
InfoQ
A
About on SuperTechFans
宝玉的分享
宝玉的分享
J
Java Code Geeks
博客园 - 司徒正美
爱范儿
爱范儿
Engineering at Meta
Engineering at Meta
G
Google Developers Blog
人人都是产品经理
人人都是产品经理
小众软件
小众软件
Microsoft Security Blog
L
LangChain Blog
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
Hugging Face - Blog
Hugging Face - Blog
H
Hackread – Cybersecurity News, Data Breaches, AI and More
aimingoo的专栏
aimingoo的专栏
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
Last Week in AI
Last Week in AI
腾讯CDC
Recent Announcements

博客园 - 小丑鱼1

Git常用命令总结 HTTP HTTPS OSI七层与TCP/IP五层网络架构详解 RDD机制实现模型Spark初识 Chrome 控制台不完全指南【转载】 sql语句 JQuery.Ajax之错误调试帮助信息 JIRA的常用选项 jdk与jre的区别 Tomcat 7.0的配置 java基础之Java变量命名规范 java环境变量详解---找不到或无法加载主类 PowerDesigner使用教程 —— 概念数据模型 (转) SQL Server高级内容之表表达式和复习 SQL Server高级内容之子查询和表链接 SQL Server高级内容之case语法函数 Web开发知识点总结 整理:sql语句优化之SQL Server SQL数据库开发知识总结:提高篇
高命中缓存设计流程整理篇
小丑鱼1 · 2014-11-22 · via 博客园 - 小丑鱼1
在之前的文章中简单描述了一下如何通过LRU结合多层缓存机制实现高命中的缓存,这一章节里的主要内容是深入地了解其原理的实现.

LRU算法

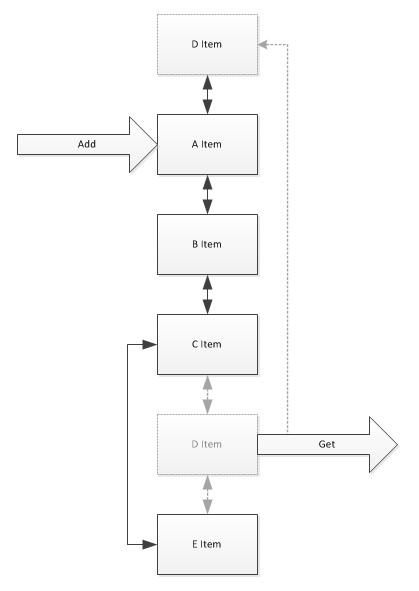
什么是LRU算法? LRU是Least Recently Used的缩写,即最少使用页面置换算法,是为虚拟页式存储管理服务的.通过这种算法可以把最近使用的数据迁移到数据存储的热区,而不常用的数据则迁到数 据存储的冷区;通过数据存储分区那在清除局部冷区数据相应要处理的复杂底就会降低.在.NET中可以通过一个双向链表来实现冷热交互的结构,大概结构如 下:

以上是一个基于双向链表存储的原理,新添加进来的数据会添加到头部,当数据被获取命中后同样也会移至到链表头,这样就能形成一个上面的热数据而下面 的冷数据的存储结构体.基于这种结构我们可以在添加的时候如果存储容间不足就可以把尾部的项移走,在移除超时项时也只需要从底部开始检测这样可以做以最少 复杂度的情况把已经超时的数据删除.

层次提升

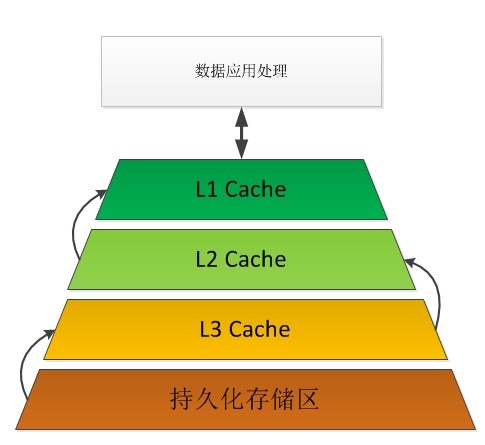
在之前的文章里已经提到,只有LRU是满足不了命中率的需求.LRU只以保证最新的数据存储在热区,访问低的数据存储在冷区.但在实际应用中热区的数据并不代表中率就很高;因此为了满足存储命中率的需要就要加入类似于CPU中多级缓存区的机制原理.

通过以上划分层次可以把不同命中率的数据存放到不同的缓存区,命中率最高的存放在最顶层,依次往下存储命中最低的存储到最低层.而应用处理则从最顶层开始检索,保证最快获取命中高的数据.

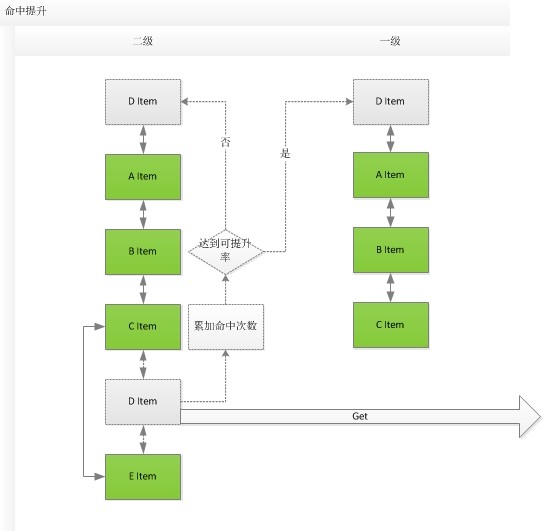
既然有了不同命中的存储区,那剩的工作就是如何把当前数据在这些区域中切换,其实现原理可以采用很简单的方法就是当一个缓存项在某个区中被获取的次数达到一定数据而又没有被当前区排除那就可以提升其命中率的级别.