





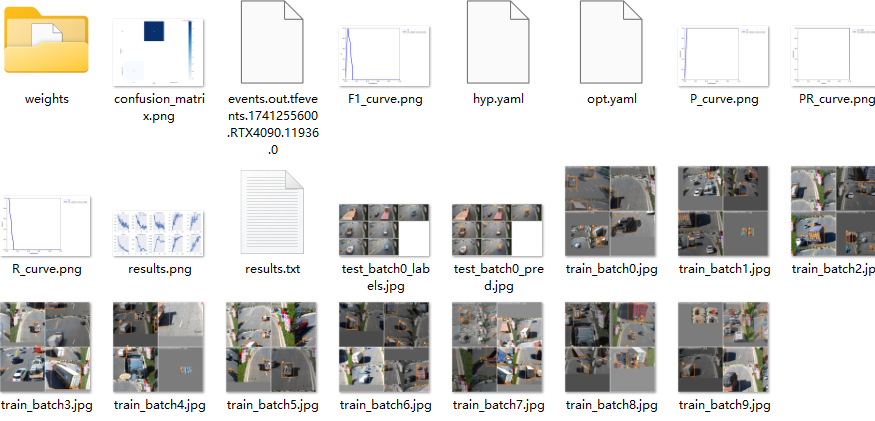
训练结束后会在run/train/exp中有如下结果:
用自己的模型进行测试, --device 0 表示GPU,运行后默认保存在runs/detect/exp目录
python detect.py --weights best.pt --source ./test_images/ITS20240824034226.1.jpg --device 0
F1分数,它被定义为查准率和召回率的调和平均数
一些多分类问题的机器学习竞赛,常常将F1-score作为最终测评的方法。它是精确率和召回率的调和平均数,最大为1,最小为0。
F1-Score的值是从0到1的,1是最好,0是最差。
PR曲线中的P代表的是precision(精准率),R代表的是recall(召回率),其代表的是精准率与召回率的关系,一般情况下,将recall设置为横坐标,precision设置为纵坐标。PR曲线下围成的面积即AP,所有类别AP平均值即Map.
如果PR图的其中的一个曲线A完全包住另一个学习器的曲线B,则可断言A的性能优于B,当A和B发生交叉时,可以根据曲线下方的面积大小来进行比较。一般训练结果主要观察精度和召回率波动情况(波动不是很大则训练效果较好)
Precision和Recall往往是一对矛盾的性能度量指标;及一个的值越高另一个就低一点;
提高Precision <>提高二分类器预测正例门槛<> 使得二分类器预测的正例尽可能是真实正例;
提高Recall <> 降低二分类器预测正例门槛 < >使得二分类器尽可能将真实的正例挑选
召回率recall和置信度confidence之间的关系
Box:Box推测为GIoU损失函数均值,越小方框越准;
Objectness:推测为目标检测loss均值,越小目标检测越准;
Classification:推测为分类loss均值,越小分类越准,如果分类只有一类值为0;
Precision:精度(找对的正类/所有找到的正类);
Recall:真实为positive的准确率,即正样本有多少被找出来了(召回了多少)。
Recall从真实结果角度出发,描述了测试集中的真实正例有多少被二分类器挑选了出来,即真实的正例有多少被该二分类器召回。
val BOX: 验证集bounding box损失
val Objectness:验证集目标检测loss均值
val classification:验证集分类loss均值,如果分类只有一类值为0;
mAP是用Precision和Recall作为两轴作图后围成的面积,m表示平均,@后面的数表示判定iou为正负样本的阈值,@0.5:0.95表示阈值取0.5:0.05:0.95后取均值。
mAP@.5:.95(mAP@[.5:.95])
表示在不同IoU阈值(从0.5到0.95,步长0.05)(0.5、0.55、0.6、0.65、0.7、0.75、0.8、0.85、0.9、0.95)上的平均mAP。
mAP@.5:表示阈值大于0.5的平均mAP
一般训练结果主要观察精度和召回率波动情况(波动不是很大则训练效果较好)
然后观察mAP@0.5 & mAP@0.5:0.95 评价训练结果。
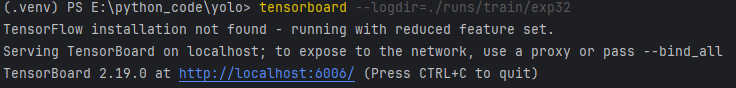
tensorboard是可实时观看自己训练数据集效果的可视化工具。
activate yolov7(自己所配的环境名称)
tensorboard --logdir=训练结果所在的文件夹
使用wandb
参考:wandb安装与使用 —— 用于跟踪、可视化和协作机器学习实验的工具-CSDN博客
pip install wandb
wandb login
(如果代码中有用到wandb,其实会自动要求登录,但是如果用nohup挂起脚本的话就无法实现,所以还是建议提前登录好)
API key的位置在:https://wandb.ai/authorize

登录会要求输入key,复制粘贴一下(在powershell中看不见输入的内容,直接回车)
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。