





单独把文档丢给 AI 让他产出用例和设计,通常只能得到一份“看起来完整”的结果,但里面容易出现三类问题:
当前主要知识库目录是:为什么是这样的结构,因为是 AI 帮我建的,然后我再修改下
TestKnowledge
├── prd              # 当前和历史需求文档
├── design           # 技术方案文档
├── flows            # 业务主流程、正逆向链路、履约和财务流转
├── domain           # 业务域说明、系统边界、代码线索
├── data-dictionary  # 字段字典、表结构、关键字段含义
├── risk-library     # 通用风险和业务域风险
├── test-rules       # 测试设计、用例编写、技术红线等规则
├── templates        # 测试分析模板和样例
├── test-cases       # 历史测试用例和场景沉淀
└── code             # 业务代码快照或代码定位辅助资料
建议:
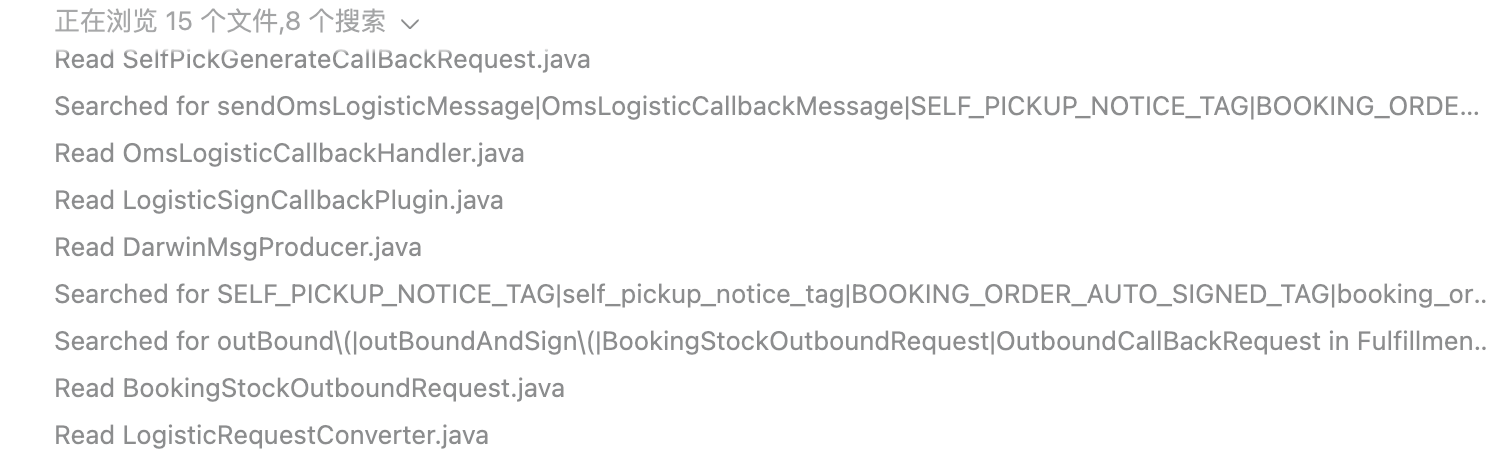
prd:需求上下文prd 不是只用来存当前需求,也要存历史需求和相似需求。
它主要用于回答:
实践:可以使用 AI + mcp 进行导出
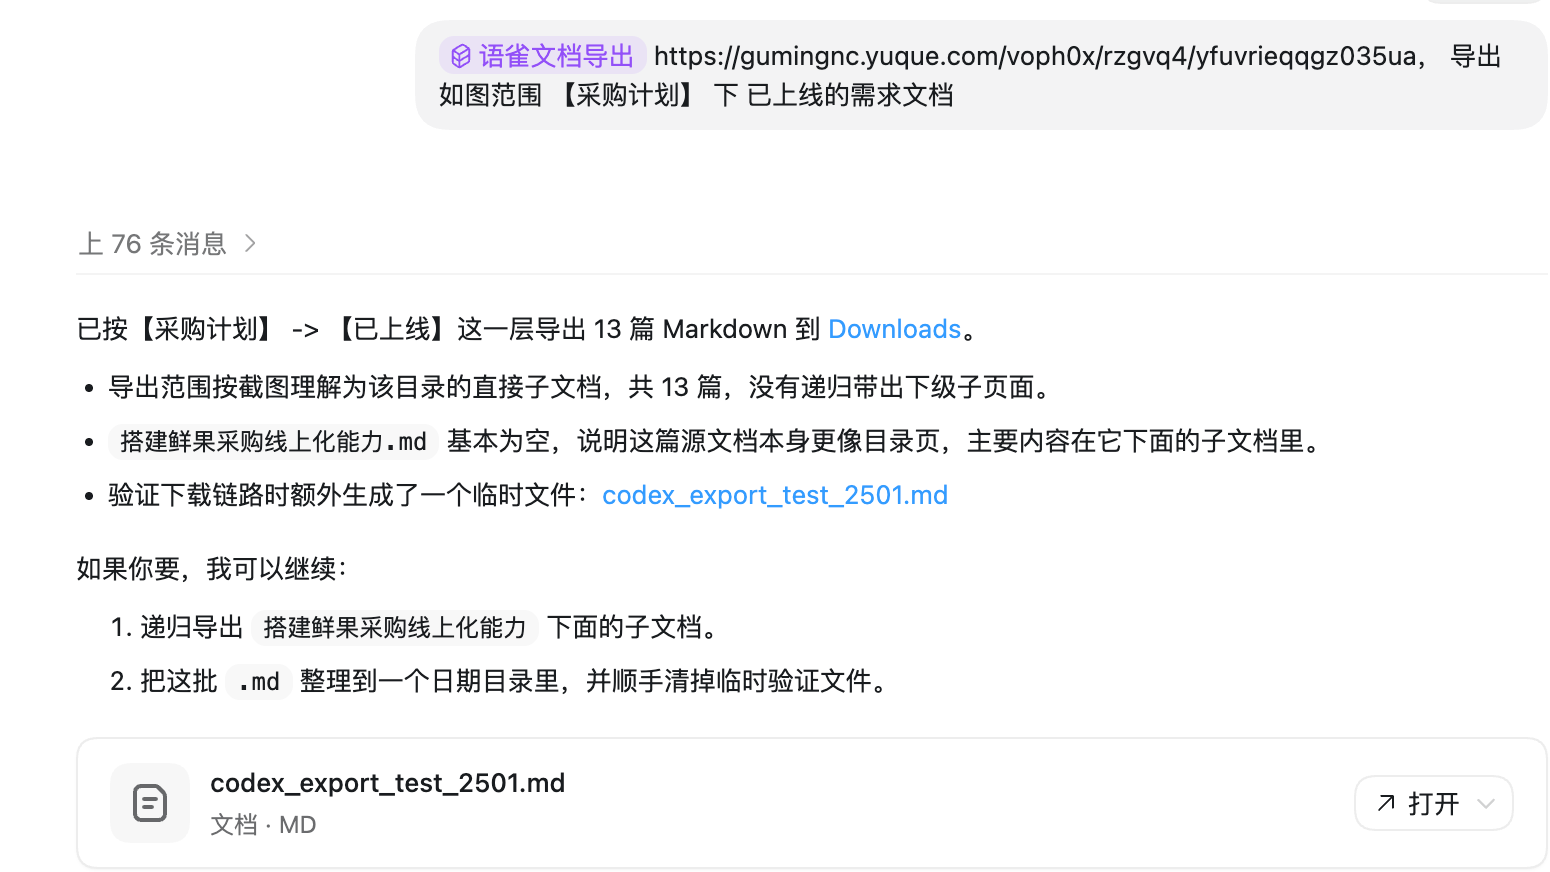
flows:业务流程flows 是这套知识库里非常关键的一层,尤其适用于报货这种强链路业务。
之前的报货正逆向梳理文档就在这一层
凡是涉及下面这些场景,flows 都应该作为主证据之一:
例如“门店自提码”技术方案评审中,PRD 说要出库差异、签收差异生成 RE 并推财务退款;如果只看技术方案,容易只关注正向展示和 OMS 查询。但结合 flows/报货资金业务评估-逆向.md 后,就能发现方案还需要补齐 RE 建单和财务退款链路。
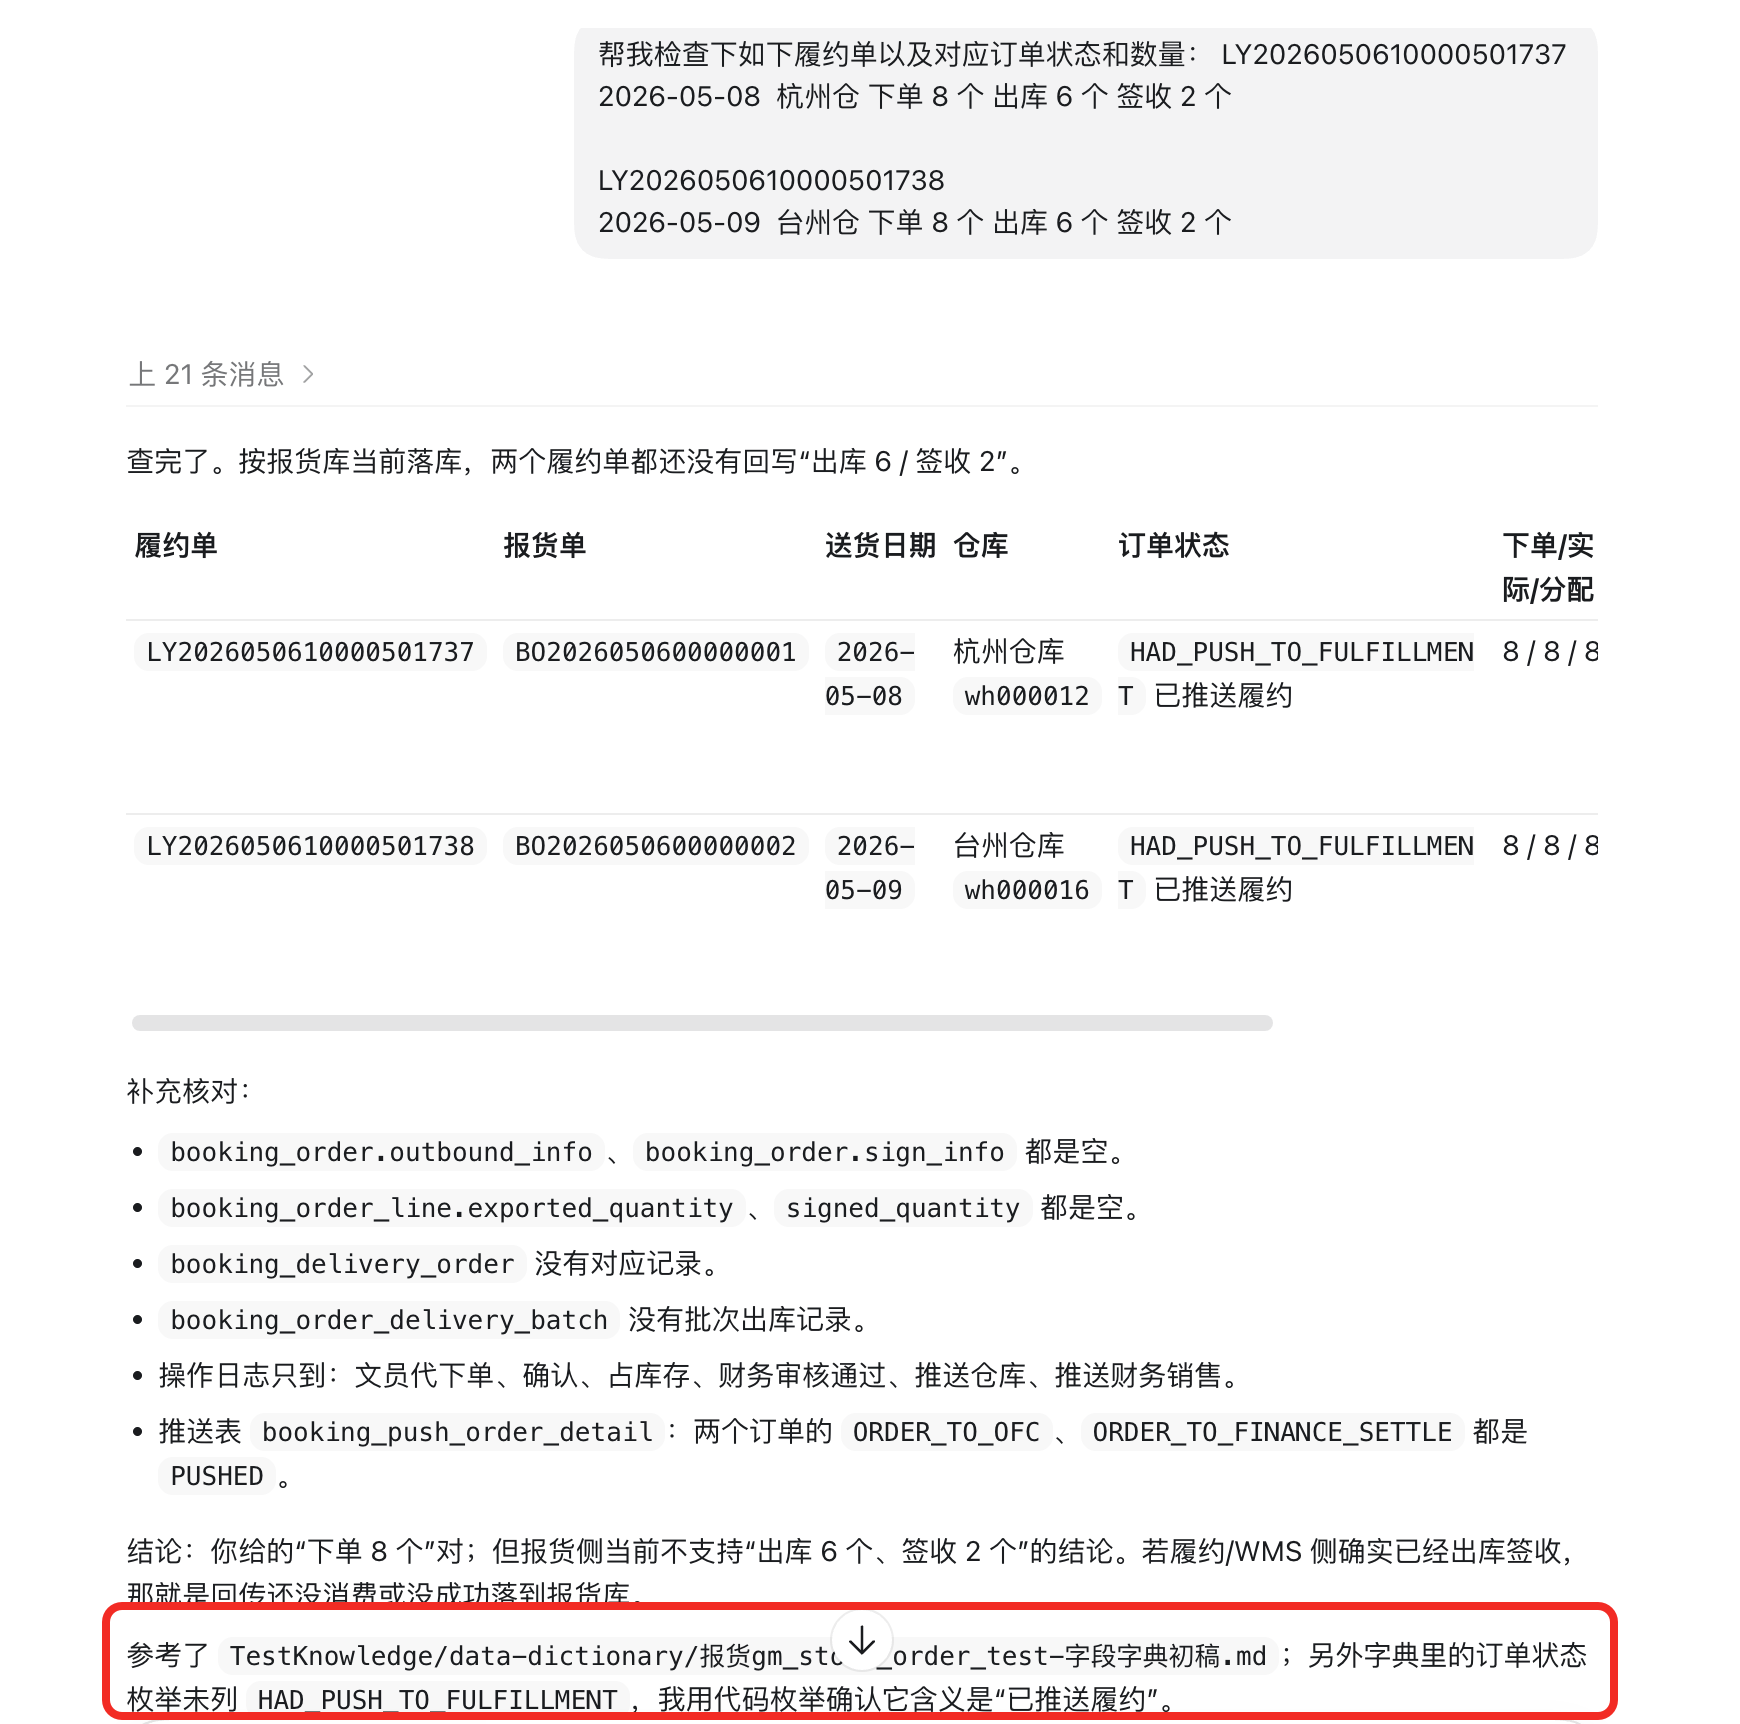
data-dictionary:字段和模型依据当评审或测试设计涉及字段、状态、表结构时,不能只凭印象写。
典型使用场景:
如果评审里出现字段级结论,但没有引用字段字典,就属于证据链不完整。
初始化两步生成:
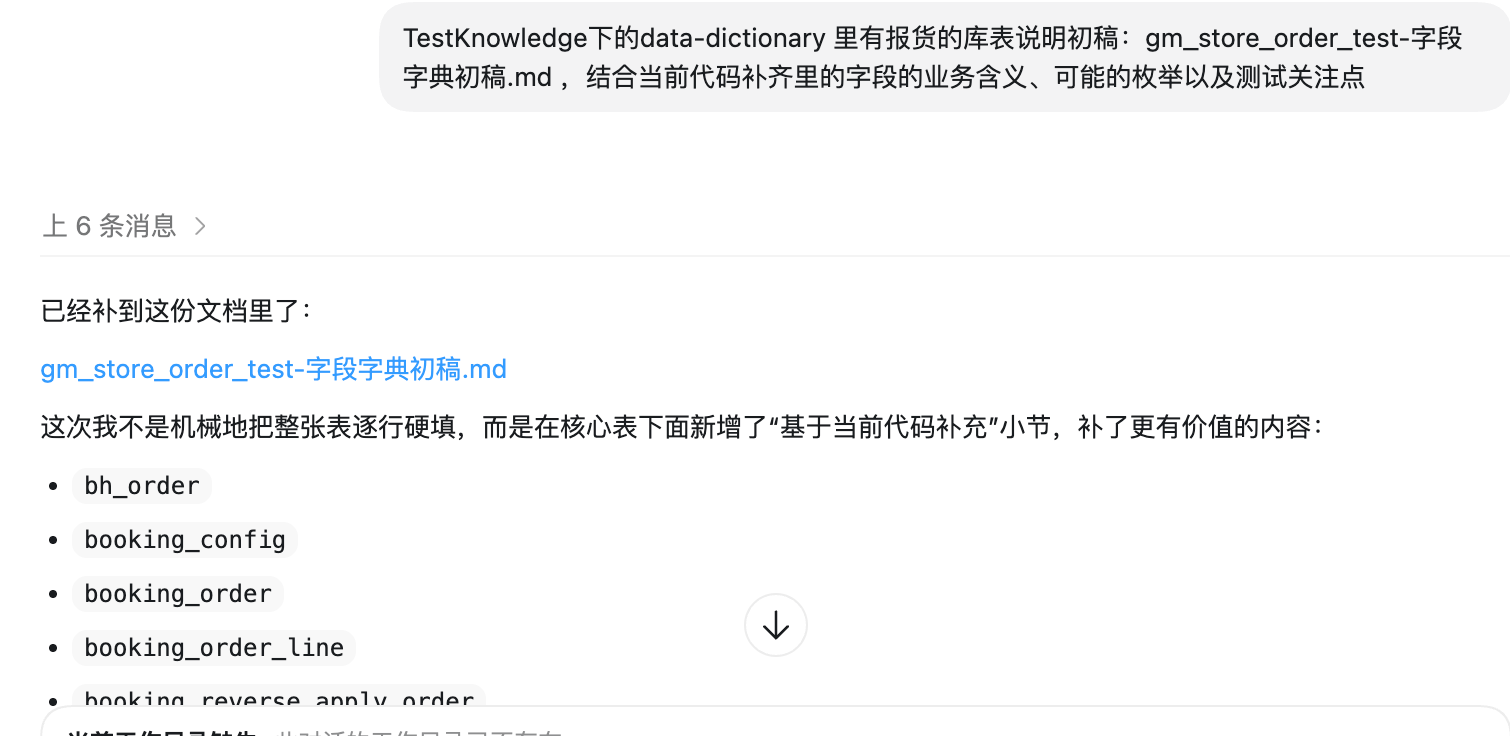
例:如后续可以依次做一些辅助操作和数据校验
code: 代码库典型的代码层次:接口-》逻辑-》DB
我们一般更关注的是逻辑,但逻辑是很准确找到的
一般的做法是使用文档+代码 进行增强,如:
后续使用:
模型的改动:走 DB-》对象-》逻辑-》接口
功能的改动:功能-》接口—》逻辑-》DB
例1:日常使用中,可以通过日志的代码行结合数据进行问题定位
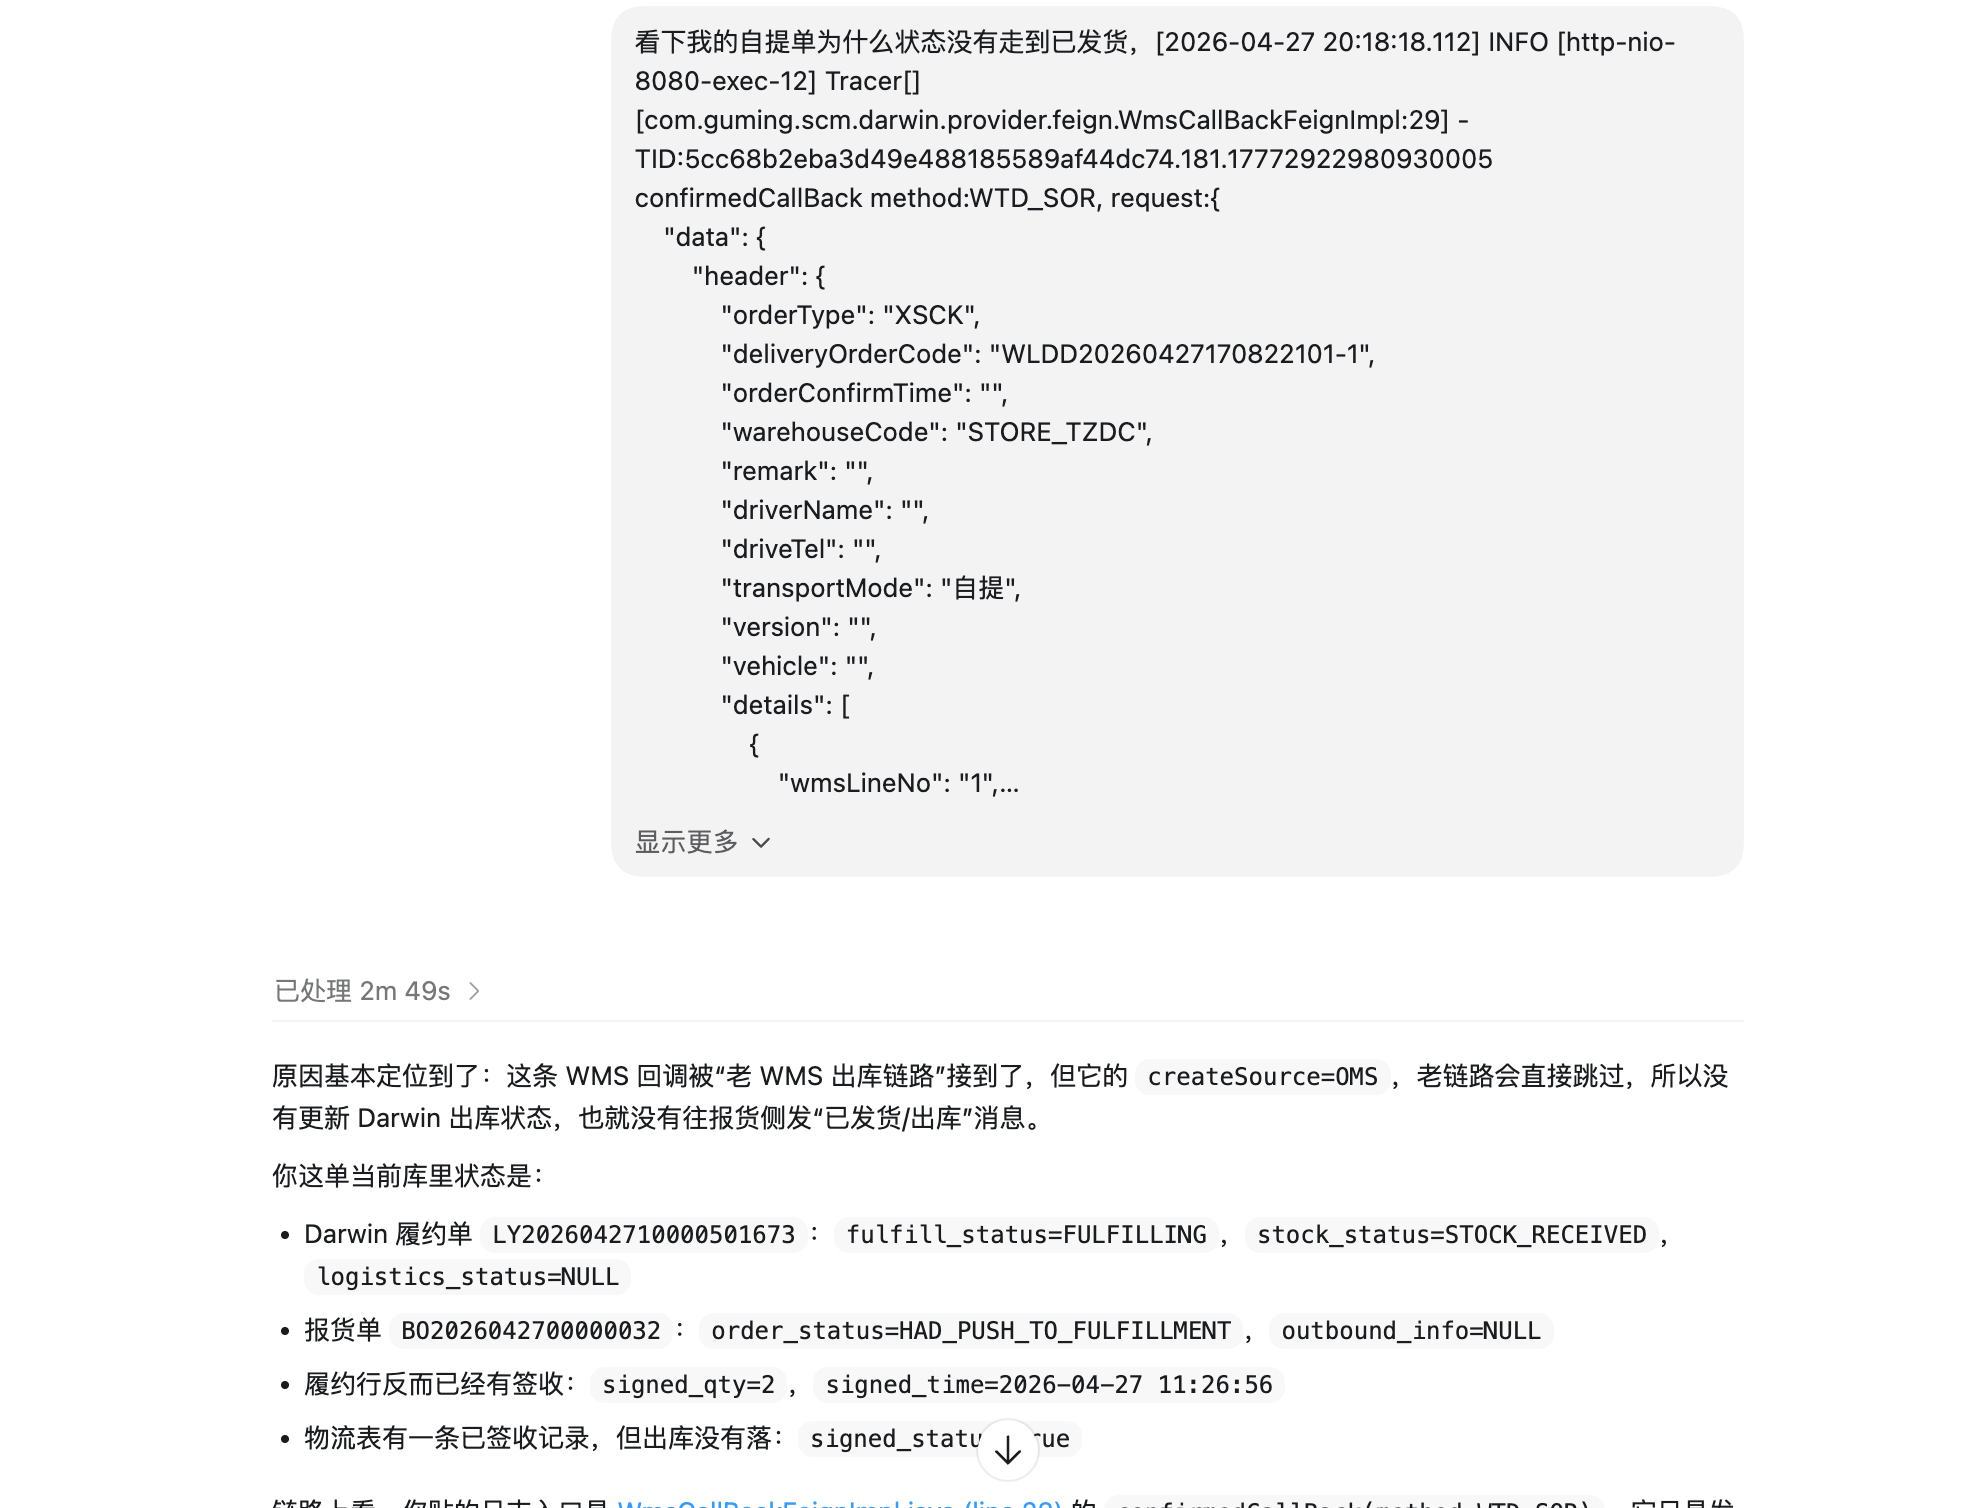
risk-library:高风险检查项可以基于数据库字段、代码、之前的历史问题和梳理文档生成,后续进行维护
分为通用高风险项、业务高风险项
很多是 DB、代码梳理过程中的副产品
test-rules 和 templates:输出风格约束这部分解决的是“AI 生成结果不符合团队约定和规范”的问题。
沉淀内容包括:
这样生成结果不只是覆盖测试点,还能更接近团队可直接交付的格式。
例:可以用于规范性检查 以及 生成测试设计和用例时约束他的输出
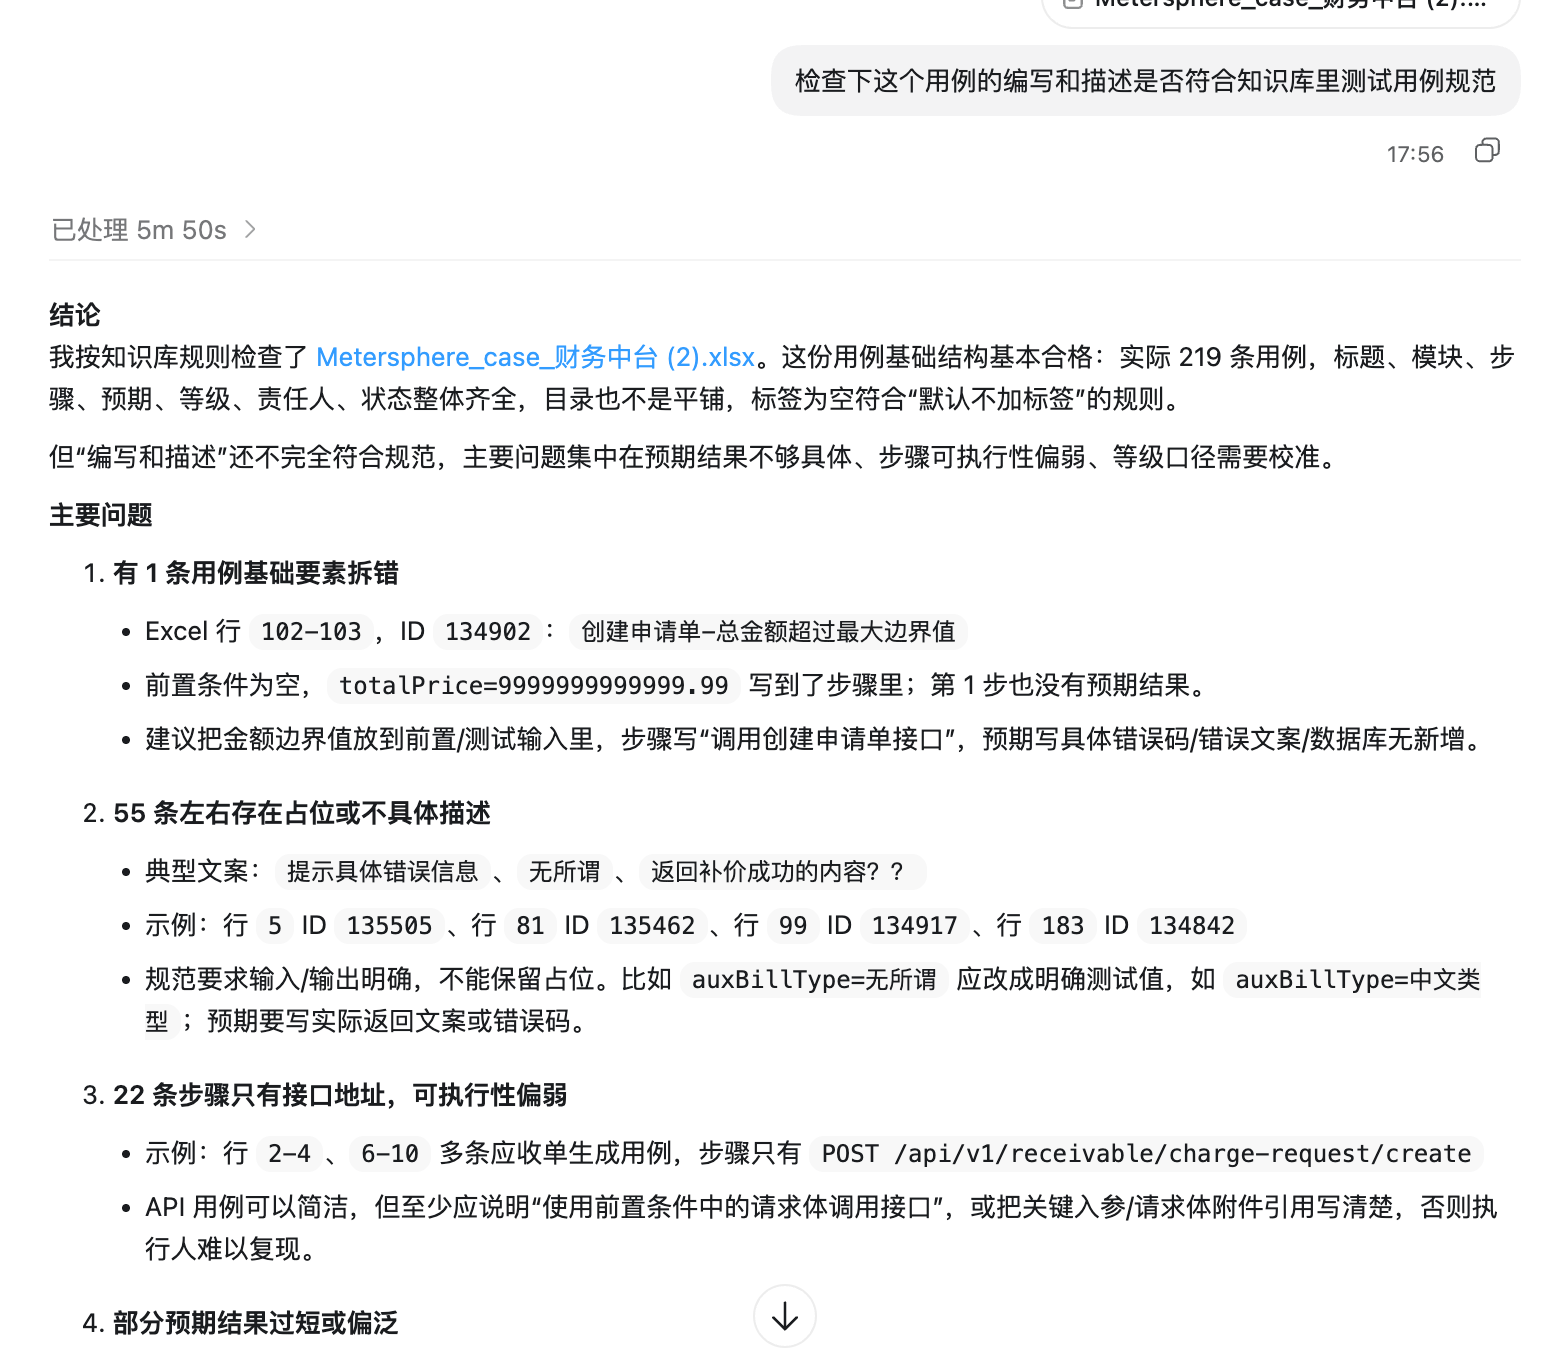
test-cases:历史测试习惯当需求背景不清楚,或者 AI 生成用例风格不符合预期时,历史测试用例很有价值。主要是提取功能点用过,后续抽取回归用例也可以用
知识库解决“资料在哪里”,skill 解决“AI 应该怎么使用资料”。目前主要用 codex 来实践使用,使用 trae 、claude 、openclaw或其他工具也是同理
skill 不是简单提示词,而是一套可复用工作流。
它会明确:
这也是最近优化后效果提升比较明显的地方:不是每次重新写一大段提示词,而是把反复出现的问题直接固化到 skill。
使用 skill:
$requirement-review-checklist-grounded
重点发现两块问题:
使用 skill:
$tech-design-review-grounded
TestKnowledge 中的技术红线、业务流程、风险库、字段字典先检查功能点、接口契约、状态、页面条件、差异场景是否逐项覆盖。
再检查方案是否改变了现有流程,尤其是订单、履约、签收、售后、财务链路。
最后再看 MQ 幂等、日志、监控、事务、接口规范等技术红线。
有把 PRD、技术方案和 历史实现 放在一起交叉验证,才容易发现实现遗漏和设计不正确。
$test-design-casegen
测试设计通常需要同时输入:
如
包括功能变更、字段或配置变更、系统交互变更、通知和导出等行为变更、兼容性和历史数据要求。
对于复杂需求,优先输出正式测试分析文档,包括项目背景、变更清单、用户用例图、系统流程、系统交互、测试准备、可测性分析、测试策略和待确认项。
用例生成要回看测试分析中的测试点,确保每个关键测试关注点都能映射到至少一条可执行用例。
实际上的用例都不是很完美,都需要人工介入处理:
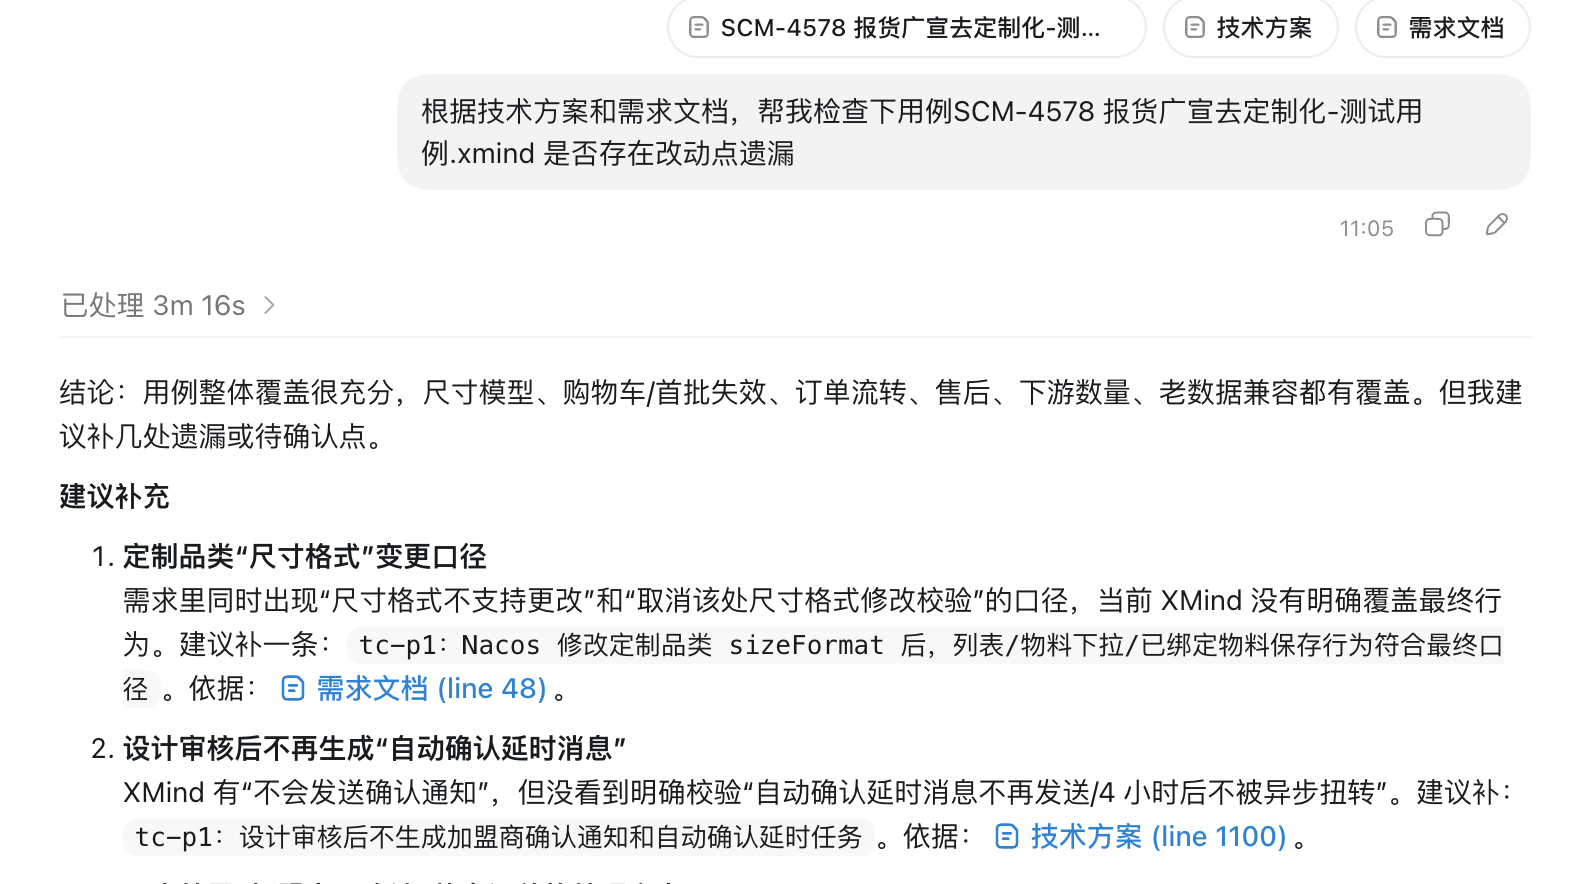
很多时候 AI 生成的用例覆盖了测试点但是难以阅读或者不符合个人习惯,你可以让AI 思考如何能像你那么优秀
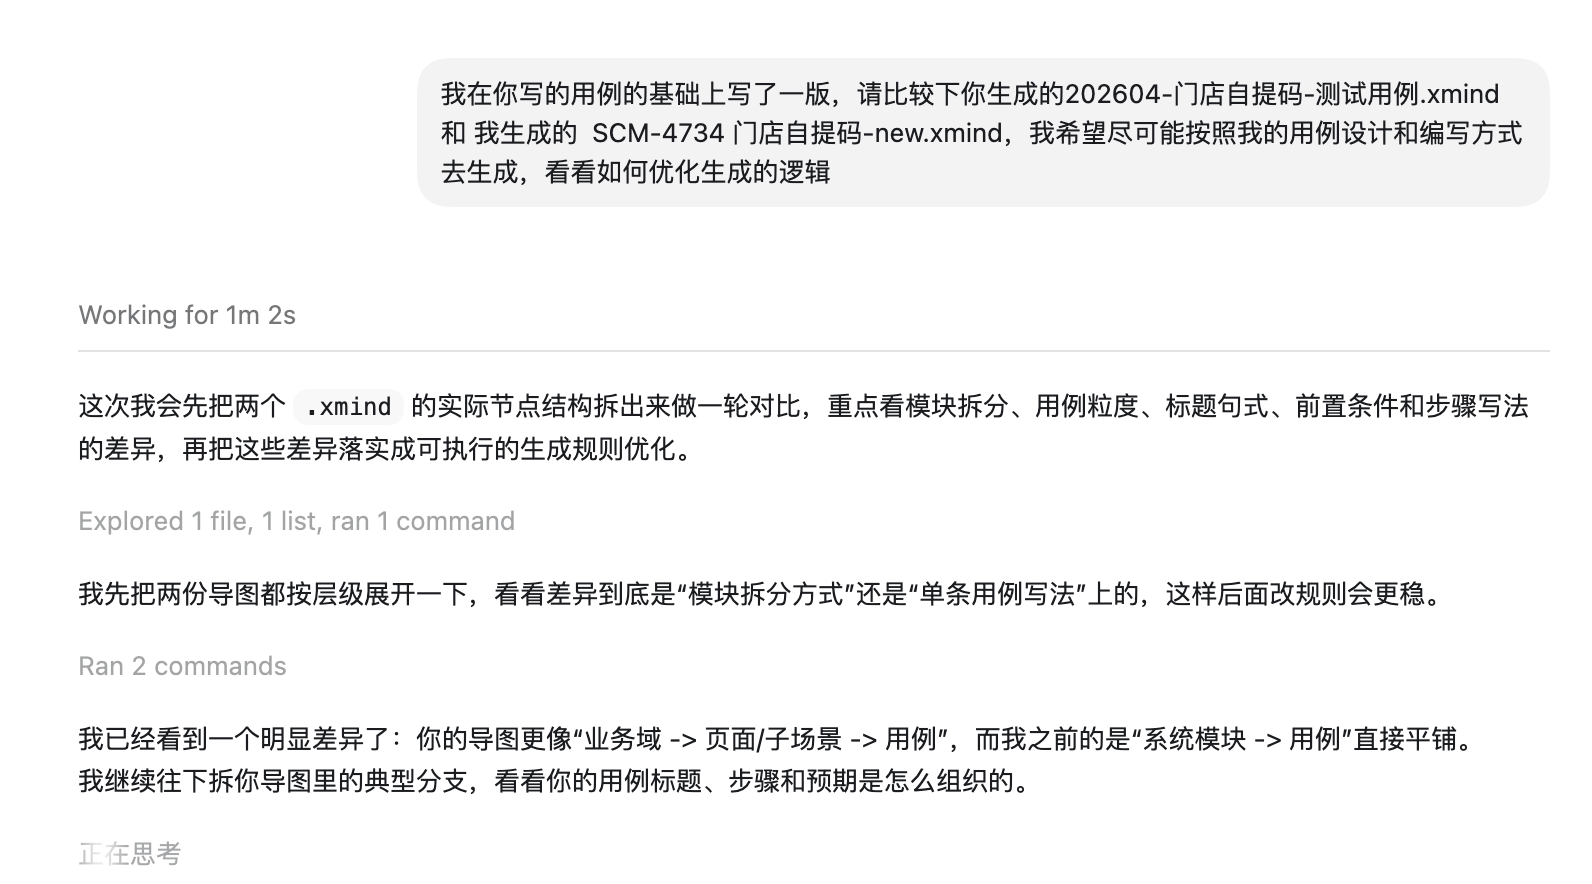
对比后不要只停留在一次性建议,要把稳定偏好更新进 skill。
例如已经沉淀到 测试设计和用例生成 的规则包括:
使用 skill:
$smoke-case-reorganizer
当已有 MeterSphere 导出的 Excel 用例,但需要按照一份“冒烟功能清单”的模块、子模块、功能点重新整理时使用。
输入通常包括:
冒烟用例整理不是重新设计用例,而是把已有用例按目标功能树重归类,并补基础质量标记。
主要能力:
未归类待完善重点看:
未归类待完善 的备注是否写清原因识别用例所属功能,解决:
目前整体识别正确率一般,还需要优化
每次使用后都要能反向优化知识库和 skill。
推荐闭环如下:
输入需求 / 技术方案 / 历史资料
        ↓
使用对应 skill 生成初稿
        ↓
人工评审和纠偏
        ↓
定位问题类型
        ↓
补知识库或改 skill
        ↓
下一次生成质量提升
常见纠偏类型:
prd、flows、data-dictionary、test-casesflows 作为订单链路主证据如何维护知识库
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。