





集群启动:
所有节点确保安装
pip install pydantic aiohttp_cors opencensus opencensus-ext-prometheus aiohttp grpcio protobuf
否则 dashboard 进程无法正常监听
通过pip list | grep -E "pydantic|aiohttp|opencensus|grpcio|protobuf|cors"检查
ray start --head --port=6666 --num-cpus=2 --num-gpus=1 --dashboard-host=0.0.0.0 --dashboard-port=8888
--num-gpus:物理 GPU 显卡数量
--num-cpus:可以使用的逻辑 CPU 核心数量, 它不等于进程数, 因为进程被阻塞,cpu核心会空闲, ray 会启动新的进程
通过dashboard即可查看集群状态
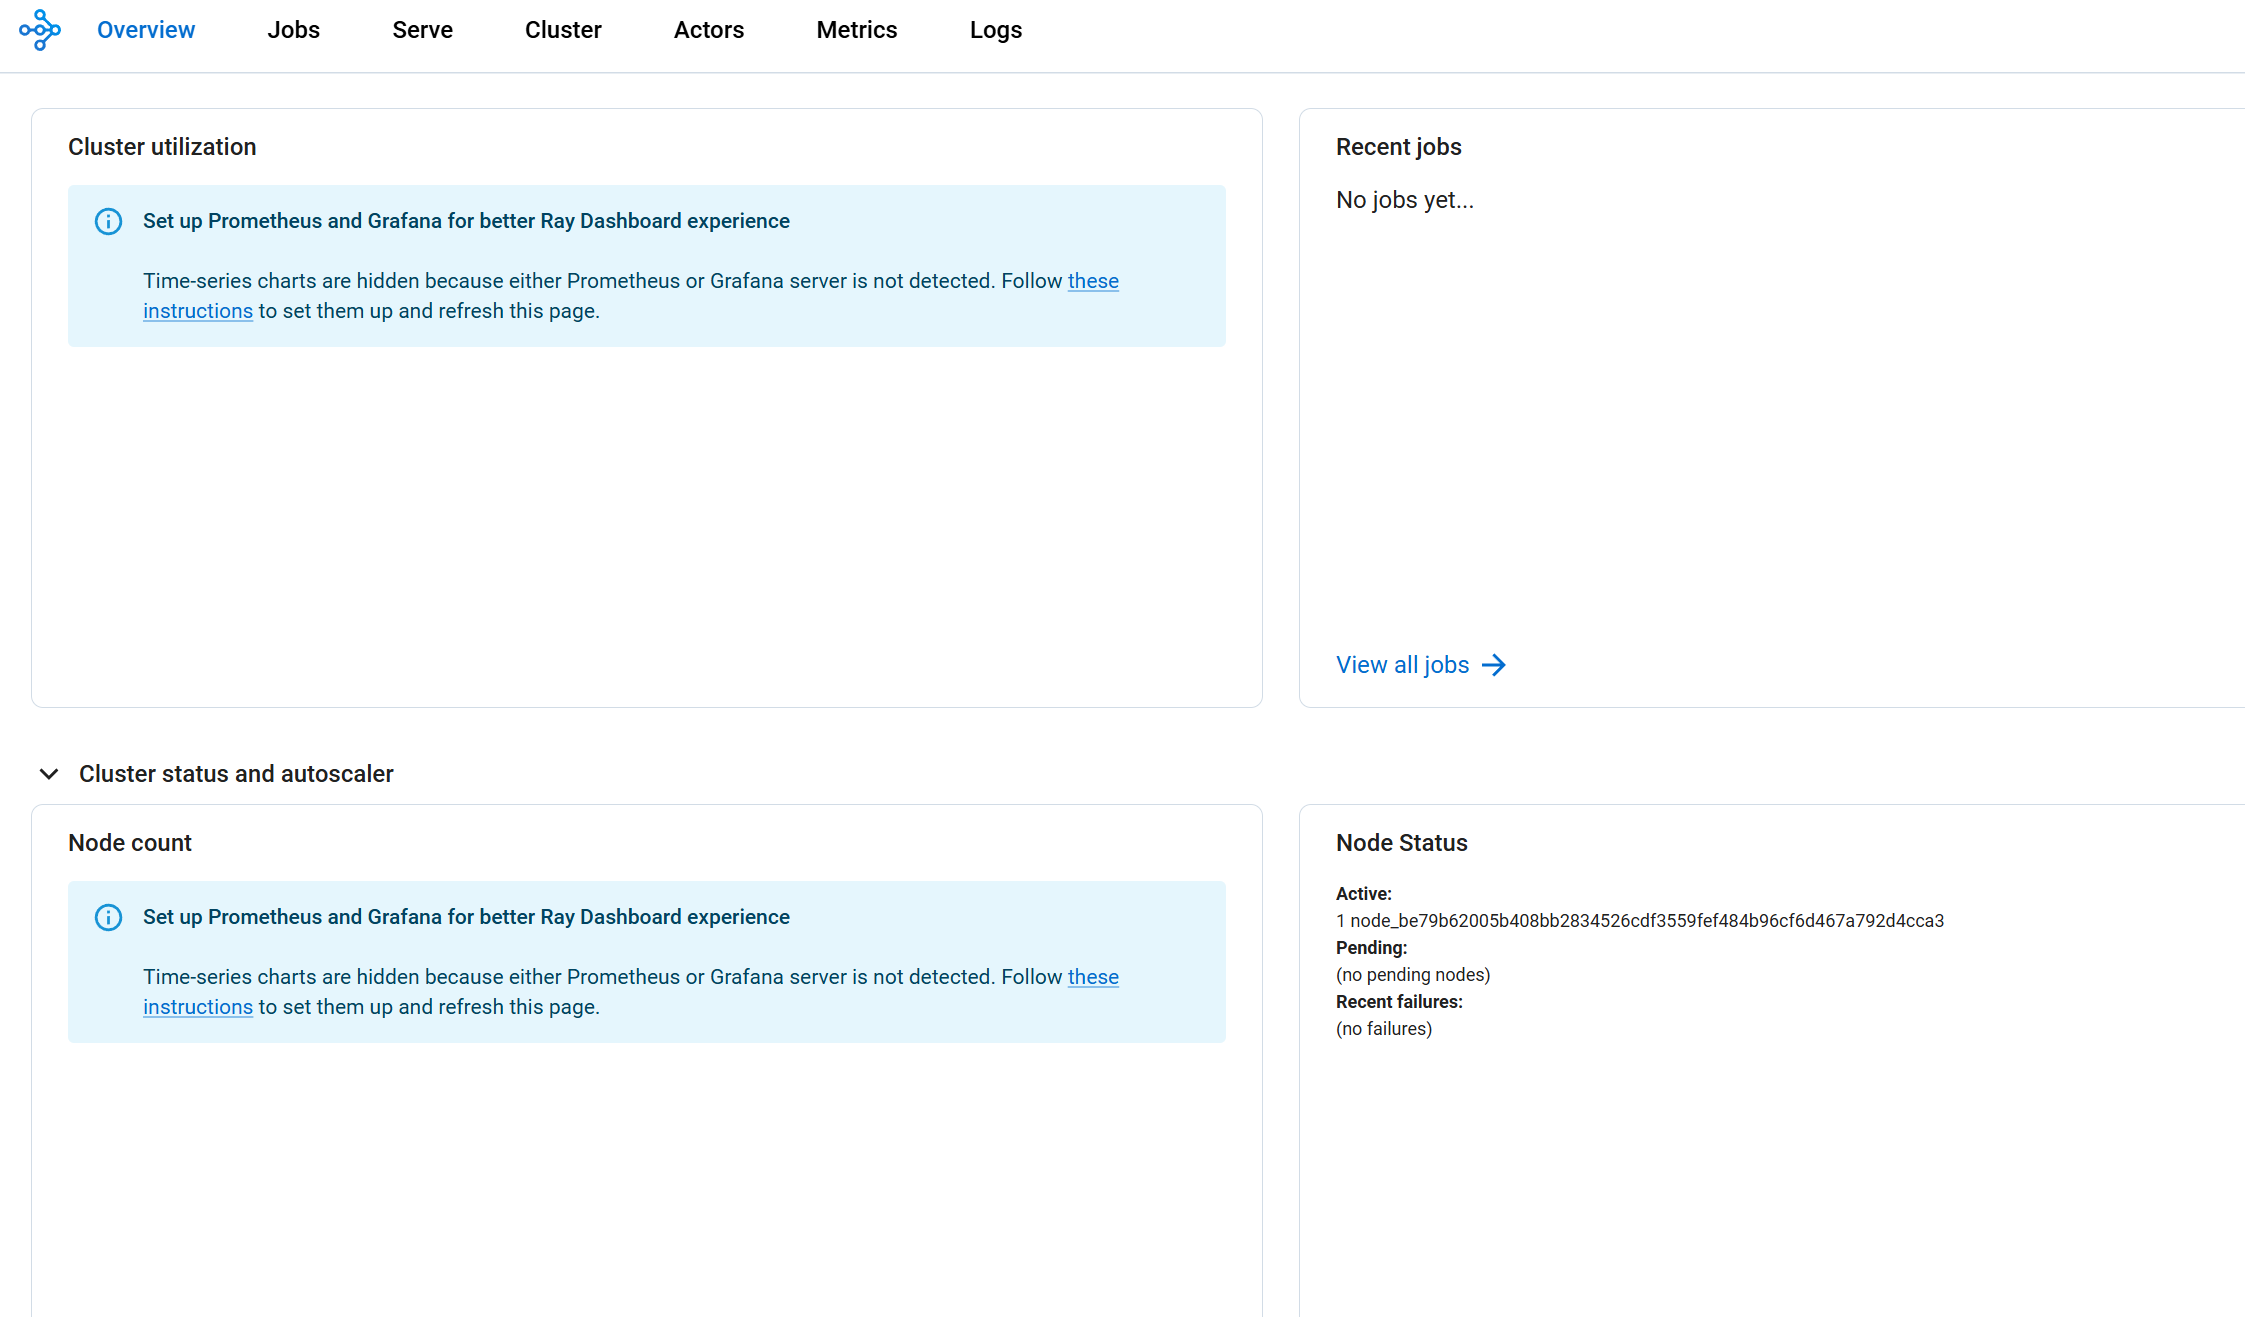
加入集群:
ray start --address=10.230.40.150:6666 --num-gpus=1 --num-cpus=3
查看集群状态:
ray status

======== Autoscaler status: 2025-05-23 17:55:28.823514 ========
Node status
---------------------------------------------------------------
Active:
 1 node_e666f94db87e9eb640e41f8596c354a631289a02efbee3568ace9a06
 1 node_53af303def24ec9b741a2946276293680929b6d6d3d10b954f025025
Pending:
 (no pending nodes)
Recent failures:
 (no failures)

Resources
---------------------------------------------------------------
Total Usage:
 0.0/2.0 CPU
 0.0/2.0 GPU
 0B/48.30GiB memory
 0B/20.70GiB object_store_memory

Total Constraints:
 (no request_resources() constraints)
Total Demands:
 (no resource demands)
停止集群:
ray stop // 如果在工作节点上执行, 则只停止工作节点, 如果在head节点执行,则停止整个集群
在ray集群中任何一个节点执行都可以
import os
os.environ["RAY_DEDUP_LOGS"] = "0"
import time
import ray

@ray.remote
class DataTracker:
    def __init__(self):
        self._counts = 0

    def increment(self):
        print(f"increment当前进程ID(PID): {os.getpid()}", flush=True)
        time.sleep(10 * 60)
        self._counts += 1

    def counts(self):
        print(f"counts当前进程ID(PID): {os.getpid()}", flush=True)
        return self._counts

# 初始化Ray
ray.init(address="auto")

# 创建共享数据
database = ["Learning", "ray", "a", "b", "c", "d", "e", "f"]
db_object_ref = ray.put(database)  # 注意修正拼写错误: db_obeject_ref -> db_object_ref

# 创建tracker执行器
tracker = DataTracker.remote()

@ray.remote
def retrieve_tracker_task(item, tracker_ref, db_ref):
    print(f"Task {item} 当前进程ID(PID): {os.getpid()}", flush=True)
    time.sleep(10 * 60)

    # 调用tracker的方法
    ray.get(tracker_ref.increment.remote())  # 等待increment完成

    # 获取数据库引用
    db = ray.get(db_ref)
    return item, db[item]

# 提交任务
retrieve_refs = [retrieve_tracker_task.remote(item, tracker, db_object_ref) for item in range(8)]


data = ray.get(retrieve_refs, timeout=20 * 60)  # 设置超时
print(data)
print(ray.get(tracker.counts.remote()))

# 清理
ray.shutdown()
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。