







公司某项业务使用三个分库存放该业务的分表。为了保持单表的查询性能,基于业务场景按照公司维度分表,目前每个库都有数量达到10W级的分表。过多的表已经影响了日常的运维,元数据相关的操作如搜索表名等在线操作速度极慢。随着业务的发展,分表数量还会增加。
Springboot+阿里云RDS-MySQL8
分库分表中间件:MybatisPlus+ShardingSphereDataSource
分库方式,创建公司时使用公司id%3计算schemaId,创建完成后不变,各分表均有这一列
分表方式,有三种,对应三种分表后缀:
公司维度,table_companyId
公司+年份维度,table_company_year
业务id维度,table_bizId,bizId在前置业务处理时生成,一般一个公司一年只有一个bizId
每个公司大概有15~50张分表,它们的结构不完全相同,但是对于前缀相同的表结构是相同的,比如table1_company_2024和table1_company_2025,或者table2_655和table2_656。
不同的分表可能会做join查询
申请更多的分库,将现有的表迁移至新的分库中,降低原有库的表数量。
如果业务简单、数据量不多,只需要做一部分表的迁移,使用jdbc逐表复制创建对应的新表、复制数据,是完全够用的。但是在当前的业务场景下:
至少有20种不同结构的分表,针对每种结构写对应的迁移代码,工作量不小
难以维护:当分表结构发生调整、增加新的结构的分表时,迁移代码也需要修改,也就是说,其他项目引入的变更,还要来修改迁移的代码
开发者要自己控制迁移过程,比如大数据量的分片迁移、迁移过程中的失败重试等
既然这部分业务跑在阿里云RDS上,使用现成的DTS中间件是更好的选择。虽然有一定的学习成本,但是它有两个明显优势:
阿里云RDS内部通过DTS做数据迁移是不收费的:计费概述
数据迁移,只要指定好源库、目标库、待迁移的表,DTS会自动创建新表结构和数据同步,并确保迁移高可用与数据准确性
在做了简单的调研(包括写一个简单的DTS数据迁移demo)、确认DTS可以满足迁库表的需求后,我选择了DTS的,通过接入DTS API完成库表迁移。
(以上三篇文档实际上是同一篇文档不同小结)
如果你也要通过demo的形式做前期验证,也需要先做准备工作。由于我使用的不是阿里云主账号而是RAM账号,这部分准备工作只知道个大概,你可以参考官方文档进行配置。
购买DTS产品,由于是后付费的,并且我的迁移场景不会产生实际的付费项,费用实际为0。
创建DTS专用的独立RAM账号创建RAM用户,此处使用【使用永久AccessKey访问】,并赋予其读写权限通过系统策略授权子账号管理DTS
将DTS服务器添加到数据库IP白名单(对于RDS Mysql不需要)
我使用的是同步版JavaSDK,同步版和异步版在文档上不区分,应该是通用的。文档:数据传输_SDK中心-阿里云OpenAPI开发者门户
整个迁移过程可以简化为:
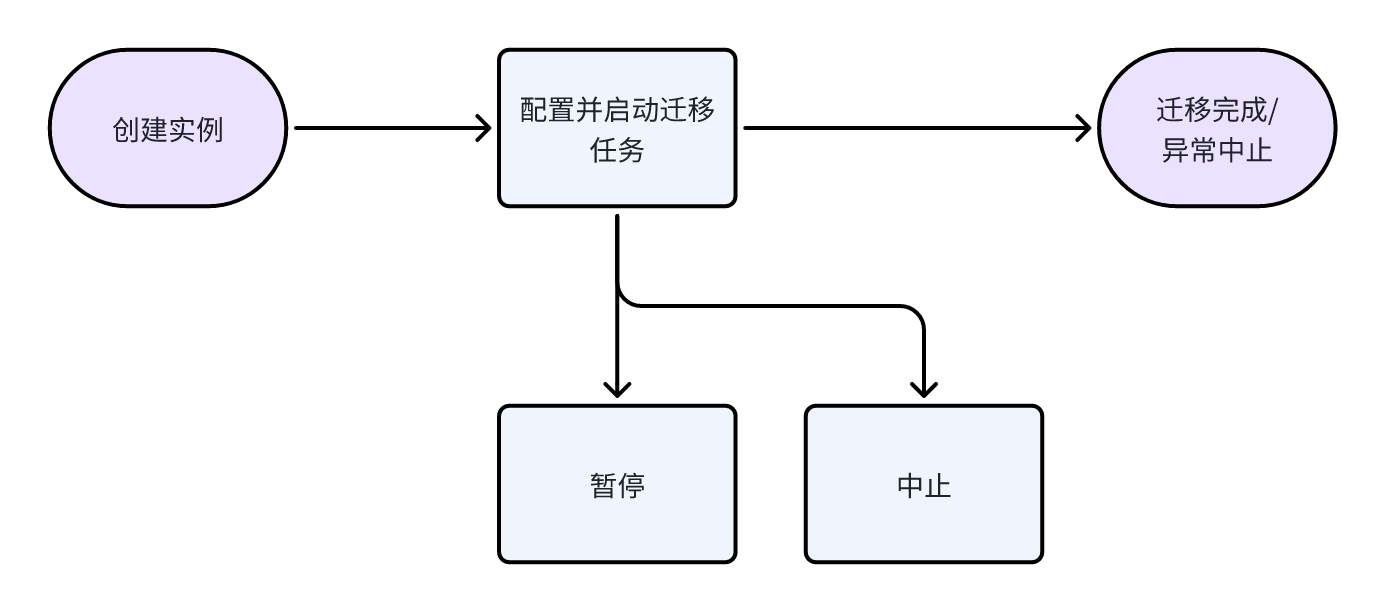
此处不贴详细的代码,可以参考官方文档。
DTS SDK新版API同步任务创建示例_数据传输_示例中心-阿里云OpenAPI开发者门户
本例实例type是"SYNC",代表数据同步,我使用的是"MIGRATION",代表数据迁移。除了这个参数,其他参数设置基本一样。
CreateDtsInstance_数据传输_API文档-阿里云OpenAPI开发者门户
ConfigureDtsJob_数据传输_API文档-阿里云OpenAPI开发者门户
一个实例只能配置一个任务。
想要只迁移指定的库表,需要配置TableConfig参数,文档见迁移、同步或订阅对象说明。本次典型的单个DTS数据迁移任务的场景:
单个库到单个库
一次性多张表(建议不超过1000)
配置字符串长度不超过1MB
{
    "待迁移的源库1的名称": {
        "name": "迁移、同步或订阅的库1在目标实例中的名称",
        "all": false(表示迁移、同步或订阅对象为非整库),
        "Table": {
            "待迁移的表A的名称": {
                "name": "迁移、同步或订阅的表A在目标实例中的名称",
                "all": true(表示迁移、同步或订阅对象为整表)
             }
        }
    }
}
DTS可以通过ETL设置迁移后的表中某些列的值,即将旧的schemaId改成新库对应的值,在任务配置的Reserve参数中增加对应配置如下:
{
        "targetTableMode": "0",
        "etlOperatorCtl": "Y",
        "etlOperatorSetting": "e_set(schemaId, '%d', schema_id,'%d')"
}
ETL用法:在DTS迁移或同步任务中配置ETL
Reserve参数用法:Reserve参数说明
先购买后配置时autoStartModulesAfterConfig默认auto, 配置完任务会立即启动。
SuspendDtsJob_数据传输_API文档-阿里云OpenAPI开发者门户
StopDtsJob_数据传输_API文档-阿里云OpenAPI开发者门户
DescribeDtsJobDetail_数据传输_API文档-阿里云OpenAPI开发者门户
除了通过DTS迁移表本身外,还有一些工作需要关注:
归档是阿里云RDS的一大功能。如果源表是归档的,迁移后的目标表也应该是归档的。如何判定表是否归档及变更归档状态参考数据归档功能
DTS的日志需要关注,如果有失败,任务本身不会停止。你也可以校验迁移前后表个数、各表数据量是否一致来判断迁移是否完全成功。
重试迁移前,前次迁移创建的表需要手动删除
校验源表、新表的字段、表名的大小写是否发生了改变。测试阶段确认一次即可。
在下一篇文章中,我会详细介绍迁移功能模块的设计和实现:阿里云DTS按业务场景批量迁移RDS MySQL表实战(下):迁移管理平台设计与实现
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。