



前两天,deepseek 正式发布了 v4-flash 模型,各项参数都优于之前的 v4-pro-preview。恰好基元律动也同步上架了这个模型,我便借着修改公共 CDN 代码的机会,实际体验了一番。
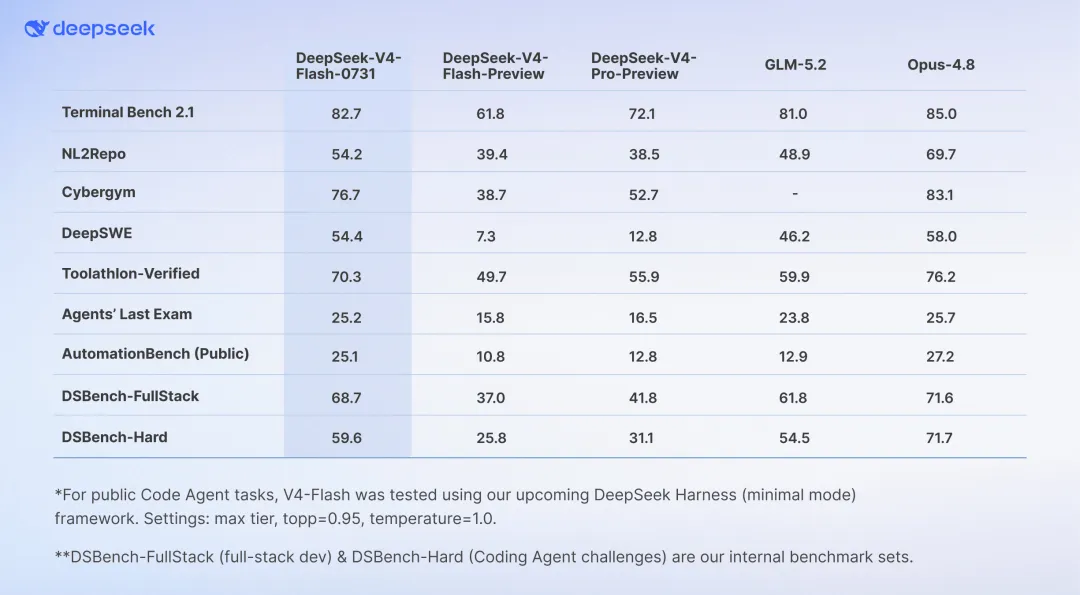
最直观的感受是响应速度的大幅提升。 相比 v4-pro-preview,v4-flash 的回复明显更快,在对话中几乎感受不到等待。我将 API 接入了常用的 trae IDE 后,还发现一个有意思的变化:它比上一代模型更爱调用工具了。例如让它仿照某个网站修改样式,以前它会先访问目标网址;现在则会直接通过工具把源代码抓下来,读取并复刻。这种”先取证、再动手”的方式,在改版类任务上效率高了不少。
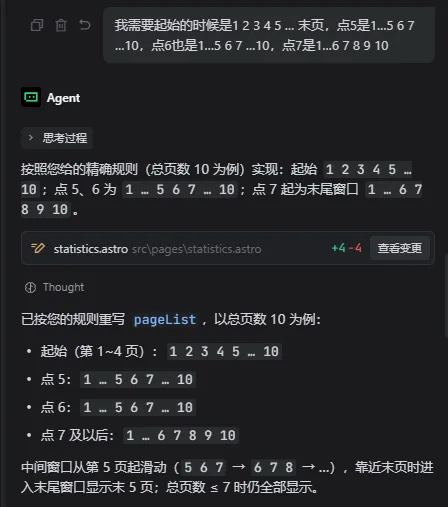
不过也有让人挠头的地方。 在某些需要精确理解的需求上,它似乎比上一代”笨”一点。比如我让它修改表格的页码切换逻辑:一共十页,初始显示 1 2 3 4 5 … 10,我希望点击第 5 页后能继续展开显示 6 7,而不是只能靠”下一页”按钮逐页切换。第一次表述可能不够清晰,它只把问题从”最多点到第 5 页”变成了”最多点到第 6 页”,并没有真正解决。
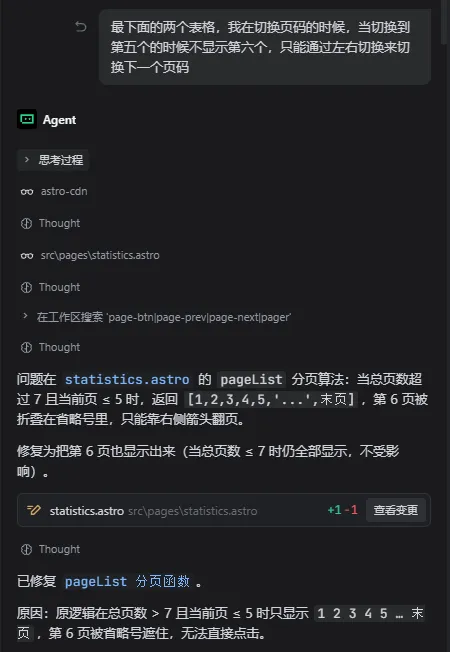
同样的需求,之前交给 v4-pro-preview 时它能轻松完成。直到我重新组织语言、精准描述后,v4-flash 才给出了满意的结果。这也提醒我:模型理解能力再强,表述是否准确依然是关键。
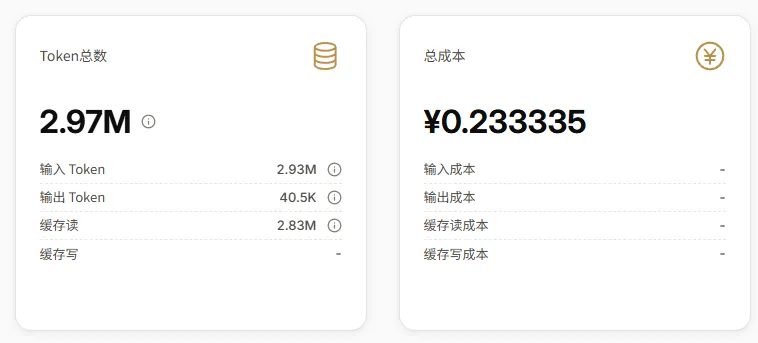
费用方面可以说相当惊喜。这次一共消耗约 3M token,其中缓存命中近 2.9M,总花费仅 0.25 元左右,日常使用几乎没有成本压力。
整体而言,v4-flash 在速度、工具调用和性价比上的表现都可圈可点,明显优于 glm-5.2;但与 grok-4.5、gpt-5.5 等顶尖模型相比仍有一定差距,尤其是在复杂指令的理解上。当然,以上只是我个人的主观感受,仅供参考。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。