


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Apple Machine Learning Research
Y
Y Combinator Blog
博客园 - 【当耐特】
V
Visual Studio Blog
GbyAI
GbyAI
V
V2EX
P
Proofpoint News Feed
Microsoft Azure Blog
Microsoft Security Blog
D
DataBreaches.Net
Hugging Face - Blog
Hugging Face - Blog
A
About on SuperTechFans
The Cloudflare Blog
阮一峰的网络日志
阮一峰的网络日志
Cyber Security Advisories - MS-ISAC
N
Netflix TechBlog - Medium
aimingoo的专栏
aimingoo的专栏
B
Blog RSS Feed
量子位
MongoDB | Blog
MongoDB | Blog
有赞技术团队
有赞技术团队
人人都是产品经理
人人都是产品经理
Stack Overflow Blog
Stack Overflow Blog
小众软件
小众软件

子夜歌

中国道教 · 道教文化百科全书 悟空传 大梅沙吃河豚 网站“防爬虫、版权声明、复制可见乱码”代码 附录 · 网络文学“洪荒流”设定集 华夏神祇七卷纲目 (七) 华夏神祇七卷纲目 (六) 华夏神祗七卷纲目 (五) 华​​夏​神​祇​​七​卷​纲​​目 (四) 华夏神祇七卷纲目 (三) 华夏神祇七卷纲目 (二) 华夏神祇七卷纲目 (一) 梁羽生武侠小说阅读顺序与真实朝代背景设定 爱普生清零软件(Resetter)菜单选项详解与操作指南 纳兰词全编笺注 技嘉 B650 冰雕(AORUS ELITE AX ICE)BIOS 设置指南 续西游记 · 明代白话神怪小说 西游记补 · 意识流小说先驱 七种武器之七拳头 七种武器之六离别钩 七种武器之五霸王枪 七种武器之四多情环 七种武器之三碧玉刀 七种武器之二孔雀翎 七种武器之一 长生剑 茶经-陆羽 资治通鉴-全译本 狄公案——黄金案 佛教入门 佛法的基本与要径
📚 从散落硬盘的电子书到统一 HTML 阅读器:我的 DeepSeek 辅...
ziyege · 2026-07-29 · via 子夜歌

deepseek_mermaid_20260729_002415

一、收藏的电子书,读不成了

十几年来,我的硬盘里攒了大量电子书——EXE、CHM、PDF、TXT、EPUB……光是 E 书格式的就存了几百本。可当我把它们从旧电脑拷到新电脑上时,问题接二连三地冒了出来:

  • EXE 文件打不开了:旧格式只支持xp系统,一个个改兼容太麻烦。
  • CHM 格式字体太小:排版固定,没法调整,在平板上根本看不下去。
  • TXT 又太简陋:没有目录导航,读到哪儿了全靠自己记。
  • 各设备体验割裂:手机上没法看,平板上排版乱,电脑上勉强能读却很不舒服。

归根结底一句话:那些曾经能读的书,现在读不了了。

我需要一种任何设备、任何系统、任何浏览器都能打开的格式。翻了一圈,只有 HTML 满足条件。

  • 跨平台:手机、平板、电脑,只要有浏览器就能读。
  • 无需软件:不依赖任何阅读器或 APP。
  • 可定制:字体、背景、排版都由自己控制。
  • 可部署:放到服务器上,随时随地访问。

这个方向很明确,但另一个问题随之而来——当时市面上没有现成的、能撑起一本大书的 HTML 模板。

三、求助 DeepSeek:帮我写一个

我决定用 DeepSeek 来开发一套属于自己的阅读器模板。需求很简单:

"帮我写一个阅读器的 HTML,能加载 JSON 格式的电子书数据,有目录、翻页、字体调整,还能自动记住阅读进度。"

DeepSeek 很快生成了初版代码。我复制、保存、打开测试——能跑,但一加载《临高启明》的 JSON 数据(2500 多章、近 30MB)浏览器就卡死了。

于是我又向 DeepSeek 描述问题,它给出了优化方案:

"用 IndexedDB 做持久化缓存 + 流式加载 + 分页渲染目录。"

改完代码再试,流畅了。就这样,我与 DeepSeek 合作,边测边改,边改边测,前前后后迭代了十几次,逐步打磨出了一套能扛住千万字级别的阅读器模板。

四、几个关键问题的解决

以下是 DeepSeek 帮我解决的主要难题:

1. 大文件加载卡死

  • 方案fetch + ReadableStream 流式读取 + 实时进度条,边下载边解析。
  • 效果:用户能看到"下载中 67%(已解压 18.6 MB/传输 5.2 MB)",不再干等。

2. 目录太多导致侧栏卡顿

  • 方案:分页渲染,每次只加载 50 条,滚动到底部再加载下一批。
  • 效果:即使 2500 章,目录滑动依旧顺滑。

3. 滚动位置记不住

  • 方案:用 localStorage 保存每篇的滚动位置,超出 200 条自动清理旧记录。
  • 效果:翻页后回到同一篇,能直接续上之前的阅读位置。

4. 多书共用模板导致数据混乱

  • 方案:IndexedDB 缓存键名基于书名动态生成,不同书的数据隔离。
  • 效果:同一浏览器可同时打开多本书,互不干扰。

5. 其他网站直接引用我的页面

  • 方案:前端防盗链,禁止 iframe 嵌套 + Referer 白名单验证。
  • 效果:其他网站无法把页面嵌入到自己的框架中,保护内容不被盗用。

6. 目录中卷名反复出现

  • 方案:分页加载时继承上一批最后一条的卷名,只在卷名真正变化时才插入分组标题。
  • 效果:每卷只显示一次分组标题,目录干净整齐。

五、建站与分享:好东西不该锁在硬盘里

因为自己本身有一个小小的网站,就想把书籍都搬到网上,一方面方便自己随时随地阅读,另一方面也想把整理好的电子书分享给更多人。

目前已上线的书籍:

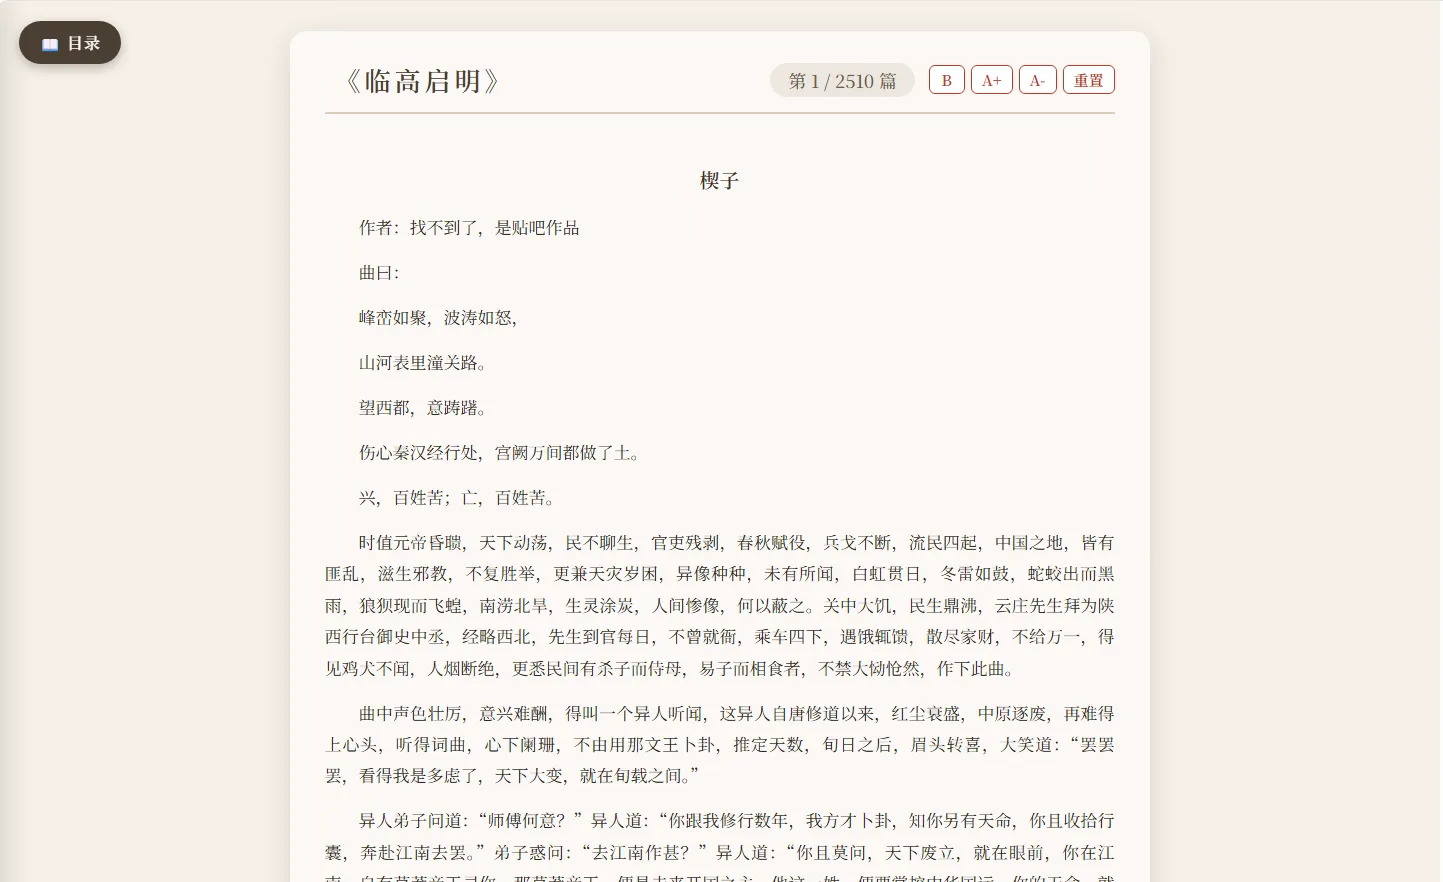
  • 《临高启明》 :2510 章,30MB JSON 数据
  • 《明史》 :332 卷,全本
  • 《王阳明全集》 :14 篇,全本
  • 更多古籍、文学作品持续整理中

分享的理由很简单:这些书大多是公版古籍或公开的网络文学,版权上没有问题。好东西应该被阅读、被传播,而不是锁在硬盘里。

六、最终的模板长什么样

主要功能

功能说明
加载机制IndexedDB 缓存 + 流式加载 + 实时进度条
目录系统按卷分组 + 分页渲染(50 条/批)
阅读交互键盘翻页 + 触屏滑动 + 字体调节
进度保存页码 + 滚动位置 + 阅读进度百分比
安全防护前端防盗链 + XSS 净化

性能数据

  • 支持数据量:50MB+ JSON
  • 测试书籍:《临高启明》2510 章
  • 首次加载:≈ 5-8 秒
  • 二次打开:< 500ms(秒开)

模板完全基于原生 HTML + CSS + JS,不依赖任何框架,一个 HTML 文件就是完整的阅读器。

七、一点心得

回顾整个过程,有几个真实感受:

AI 是强大的助手,但不是全自动工具。 它帮我写代码、优化性能、修 Bug,但需要我不断测试、反馈、验证。它替我完成了"从需求到代码"的转换,而我要做的是清晰描述问题、判断方案是否合适、确认最终效果。这是一种协作式开发,而不是一键生成。

原生技术依然有它的价值。 这套模板没有任何 npm 依赖,纯粹的 HTML + CSS + JS。脱离框架后,这个文件具备了极好的"长寿性"——十年后,只要浏览器还支持 ES6,它依然能跑。

工具的意义在于解决问题。 这套模板对我来说,是为了让那些躺在硬盘里的电子书"活过来"。对别人而言,它让几百本书重新变得可读、可分享、可传承。

八、模板获取与反馈

  • 书苑入口https://ziyege.com/book/

欢迎使用,也欢迎提出改进建议。


📧 联系:如有问题或想法,欢迎交流。

最后更新:2026 年 7 月

THE END

©版权申明

- 版权属于 @郭大路,作品采用 CC BY NC SA CC BY-NC-SA 4.0 进行许可