


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

雷峰网
雷峰网
Y
Y Combinator Blog
酷 壳 – CoolShell
酷 壳 – CoolShell
The Cloudflare Blog
博客园_首页
J
Java Code Geeks
A
About on SuperTechFans
人人都是产品经理
人人都是产品经理
量子位
C
Check Point Blog
让小产品的独立变现更简单 - ezindie.com
博客园 - 三生石上(FineUI控件)
L
LangChain Blog
N
Netflix TechBlog - Medium
Hugging Face - Blog
Hugging Face - Blog
B
Blog
美团技术团队
Microsoft Security Blog
P
Proofpoint News Feed
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
宝玉的分享
宝玉的分享
罗磊的独立博客
MongoDB | Blog
MongoDB | Blog
Last Week in AI
Last Week in AI

浮华生

Elasticsearch 检索性能优化 - 浮华生 舆情监控系统综述 - 浮华生 2024 半年度总结 - 浮华生 2023 年终总结 - 浮华生 异地机器组网方案 - 浮华生 Kubernetes 部署 Elasticsearch 和 Kibana - 浮华生 2022 年终总结 - 浮华生 RabbitMQ connection channel 的关系 - 浮华生 Kafka Java 客户端 Producer 原理分析 - 浮华生 RabbitMQ 和 Kafka 应用原理简单对比 - 浮华生 Golang Array 和 Slice 区别 - 浮华生 Mac OS 下打造 golang nvim 编程环境之基础配置 - 浮华生 电商搜索技术总结 - 浮华生 电商搜索业务总结 - 浮华生 2021 年终总结 - 浮华生 Cypress 实践总结 - 浮华生 年终总结 - 浮华生 关于我 - 浮华生 使用 cucumber 进行行为驱动开发(BDD) - 浮华生 微服务应用集成 SpringCloud 步骤 - 浮华生 电商搜索数据同步方案 - 浮华生 通过一道数值转换题重温计算机补码 - 浮华生 macOS 系统推荐的一些软件 - 浮华生 DevOps 实施规划(持续更新) - 浮华生 rabbitmq 如何提高可靠性并保证消费端幂等 - 浮华生 AMQ Model总结 - 浮华生 结对编程 - 浮华生 RSocket 介绍 - 浮华生 面向对象的理解 - 浮华生 企业平台技术框架 - 浮华生
阿里云 OpenSearch 介绍 - 浮华生
浮华生 · 2022-05-27 · via 浮华生

阿里云 OpenSearch 是一款基于 Ha3 引擎研发的商用搜索产品。在使用上给我的个人感受可以说 OpenSearch 是一套企业级搜索的完整解决方案的落地。下面我们来看一下 OpenSearch 有哪些功能。
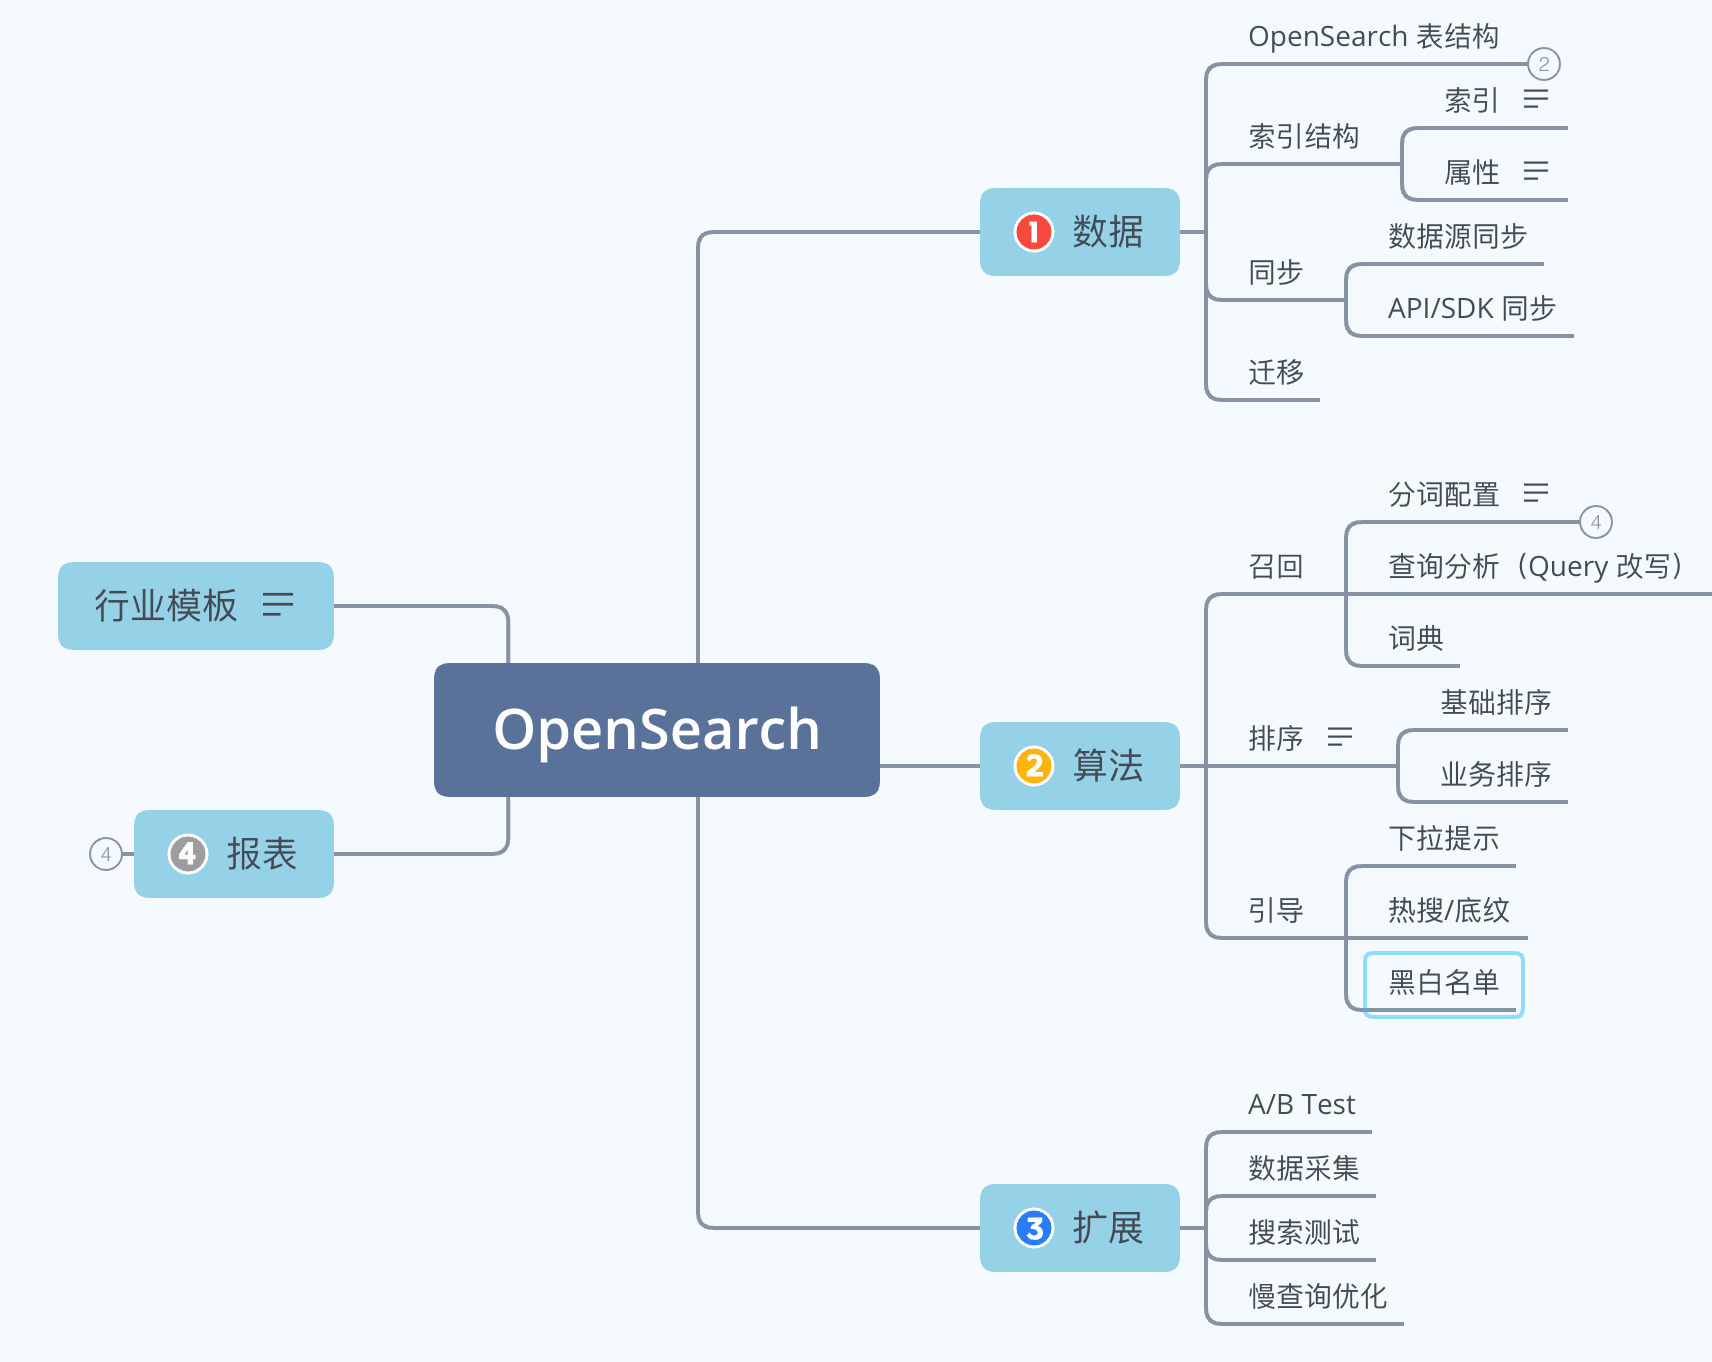
image-20220527163814607

现行搜索逻辑

下拉提示

使用 OpenSearch 官方算法模型,针对标题(title)、分类(category lines)、品牌(brand) 属性抽取值并结合高频搜索词进行自动训练

搜索召回逻辑

  • 索引名称:default
  • 分词方式:中文-电商分析
  • 字段:标题(title)、款号(sku)、品牌(brand)、全品类(category_lines)
  • 词典:同义词、停顿词

  • 索引名称:f_title
  • 分词方式:模糊分析
  • 字段:f_title

  • 索引名称:fuzzy_brand
  • 分词方式:模糊分析
  • 字段:fuzzy_brand

  • 索引名称:fuzzy_category_lines
  • 分词方式:模糊分析
  • 字段:fuzzy_category_lines

  • 索引名称:sku
  • 分词方式:模糊分析
  • 字段:sku

搜索排序逻辑

  • 基础排序:static_bm25 ,静态文本相关性,用于衡量query与文档的匹配度

  • 业务排序:text_relevance,按照排序因子进行设置,如果简单表达式不能满足要求则需要升级实例并使用 cava 进行自定义排序。

    举例来说,我想让搜索结果命中展示顺序为 title>brand>category_lines,那么我们配置的业务表达式为

    text_relevance(f_title)*3 +  text_relevance(fuzzy_brand)*2 + text_relevance(fuzzy_category_lines)
    

    此时搜索语句对应为

    query=f_title:"运动鞋" OR fuzzy_brand:"运动鞋" OR fuzzy_cates:"运动鞋"
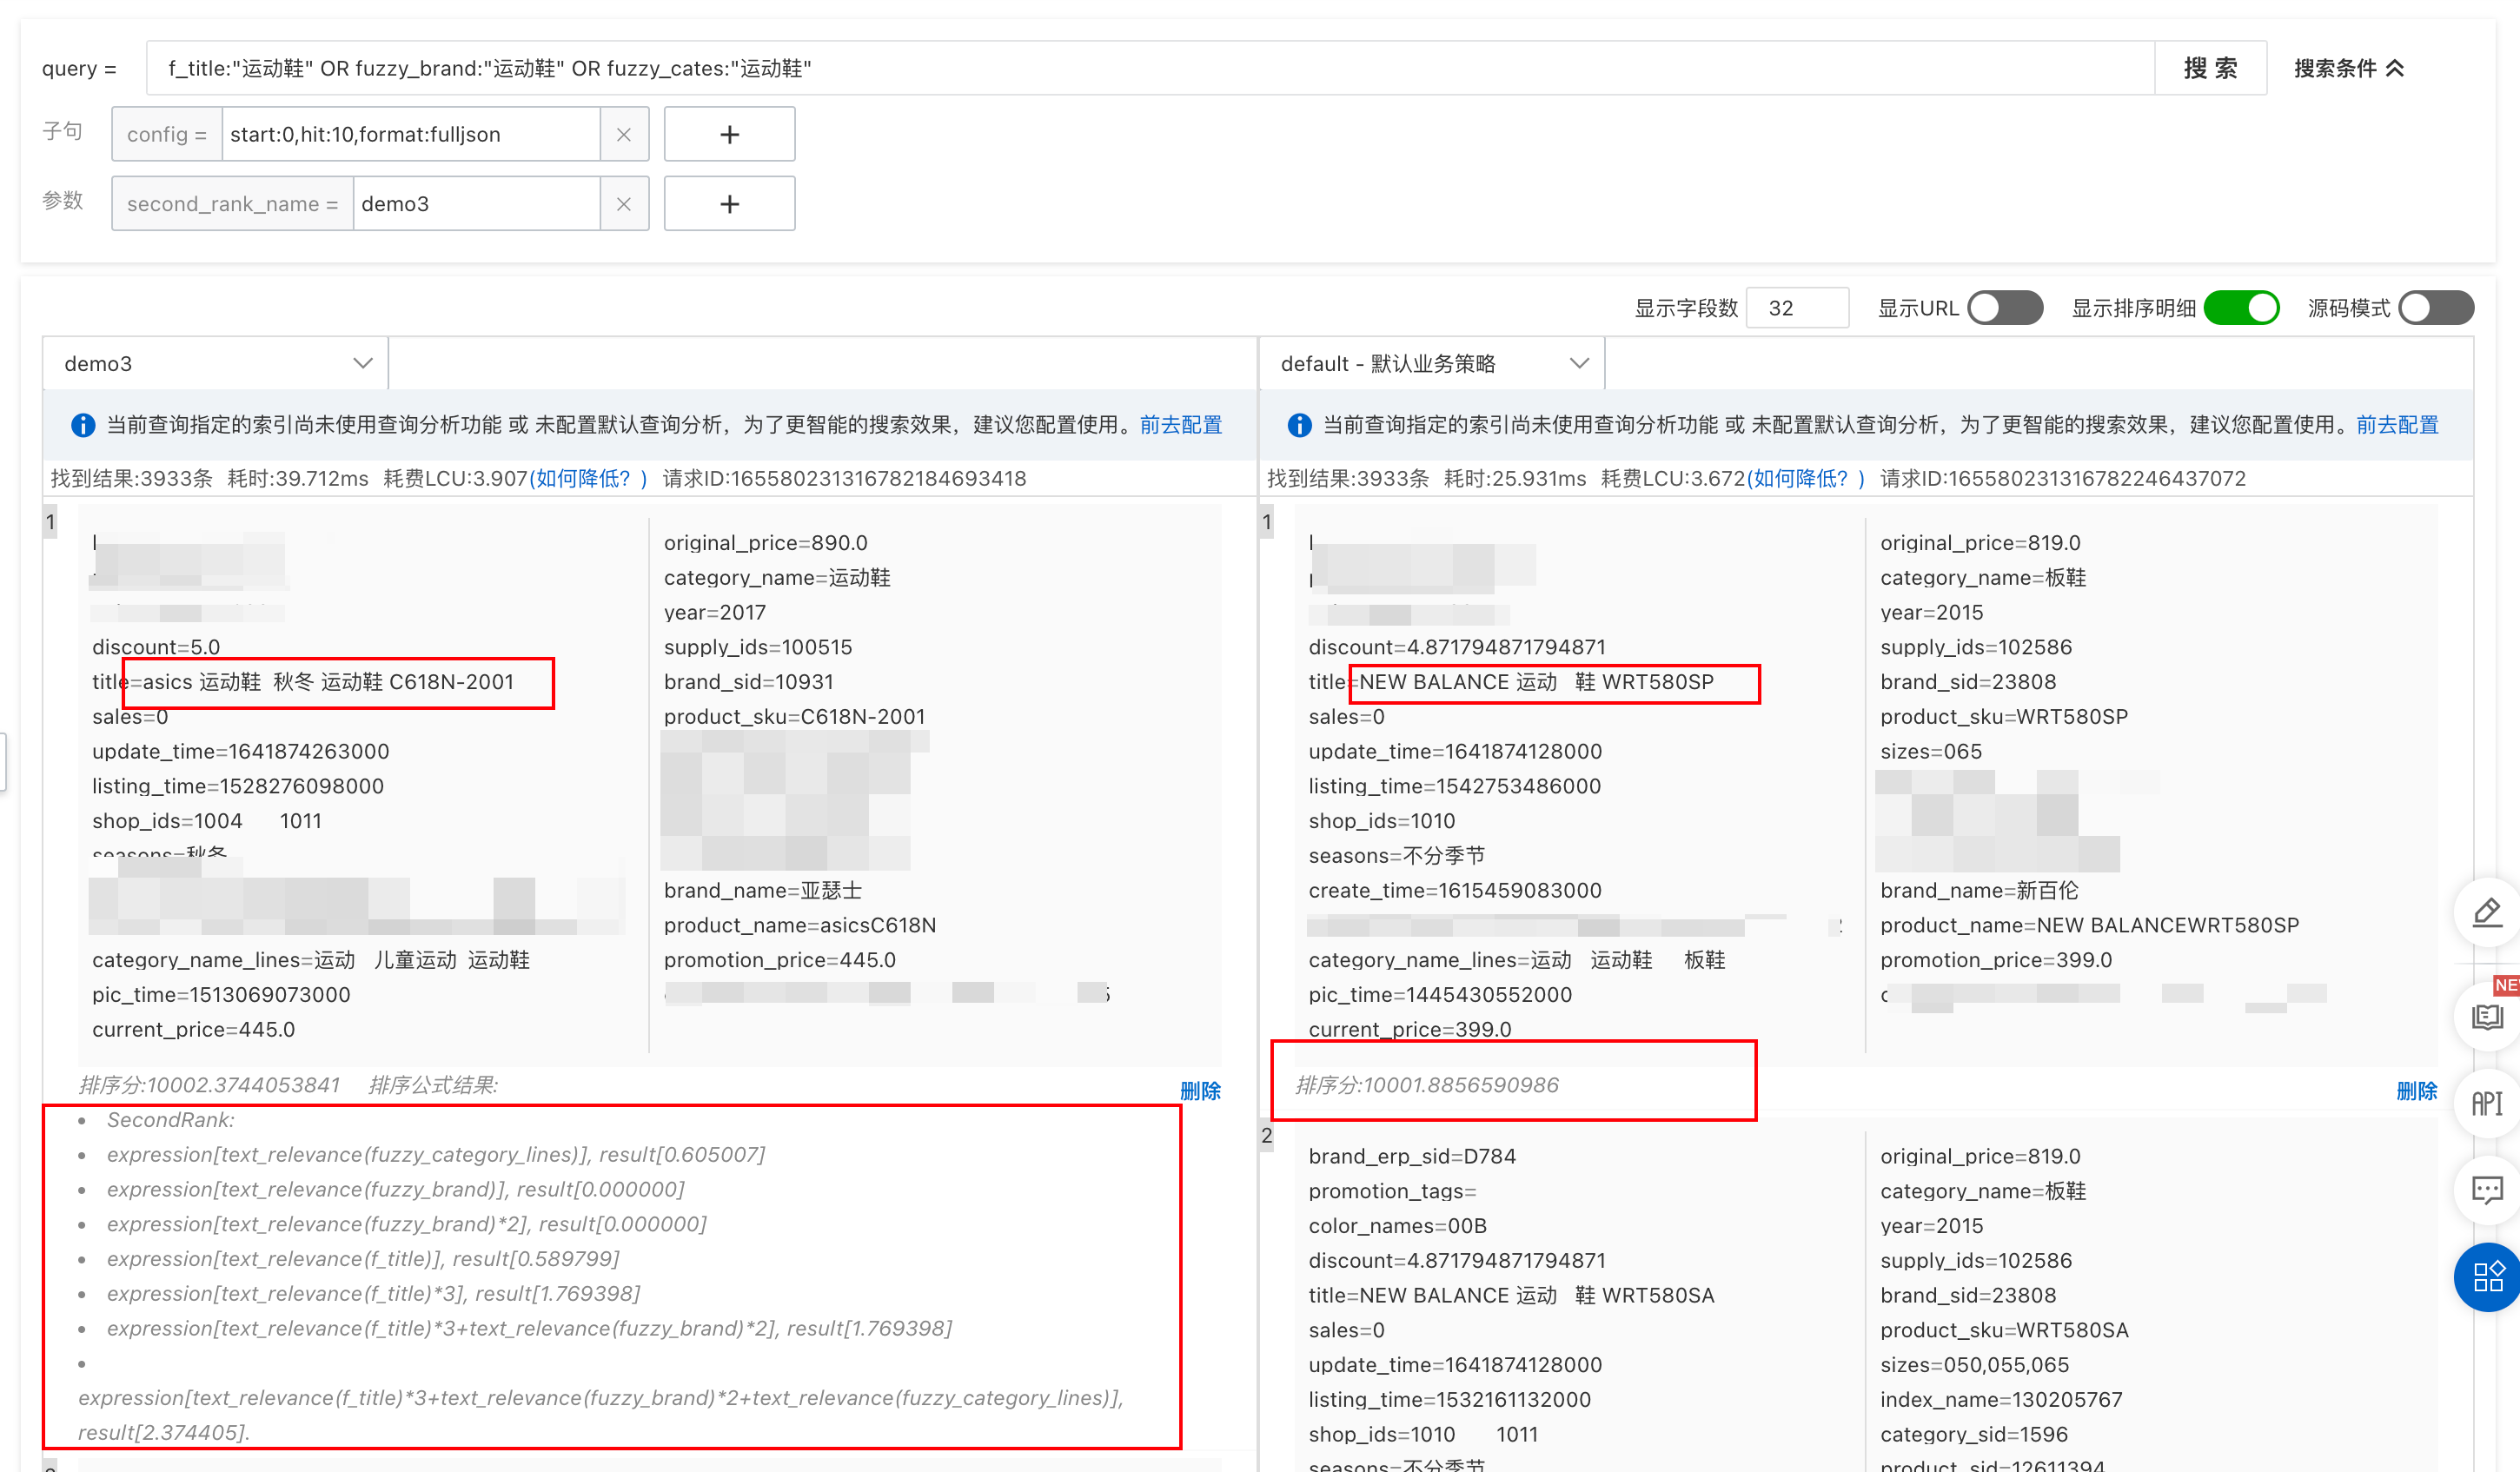
    

    image-20220621171644689

    可以看出使用了 text_relevance 后会对三个索引进行加权算分。

数据采集

针对各端调用搜索时使用

  • biz:来源,wechatshop、miniprogram、pc、ios、android
  • userId:用户
  • fromReqId:下拉提示点击进入搜索的 request id

当用户点击时记录

  • 搜索的 requestId
  • 商品 id
  • 用户 id

主数据同步

我们采用的建立一个搜索宽表,存在 MySQL 中。

全量更新:每天凌晨 1 点钟进行同步,可手动触发,正向反向同步搜索宽表。

增量更新:针对主数据变更近实时更新,会通过监听主数据的 binlog 同步到搜索宽表中,OpenSearch 会自动将宽表中变化的数据同步到索引。

踩坑处理

  1. 模糊分析不够用怎么办?

    对 SHORT_TEXT 的模糊分词不支持配置查询分析,如果出现 badcase 无法处理,那么可以增加一个 TEXT 的索引进行分析器配置,具体文章

  2. 搜索关键词中有\特殊符号怎么办?

    使用反斜杠进行转义,如搜索H'S需要处理成H\'S进行搜索

  3. 如何识别用户搜索的是款号?

    因为款号这类属于精准搜素,最好是单独配置索引,默认程序并不知道用户输入的是款号还是关键词,那么需要定义什么是款号,这需要在商品系统中把在售商品款号查出来进行归类,比如我们定义的款号规则为纯数字或者数字+款号,那么当关键词匹配到了这个规则说明用户此时搜索即为款号。

总结

搜索核心离不开分词、相关性算分,OpenSearch 内置了大量的 分析器 以及相关性搜索实践

欢迎交流搜索相关问题 ahianzhang@gamil.com