如何确定一个值是左值还是右值?
但是事实好像并非如此,特别是写了一些相关代码的时候,比如下面的这段
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
int f (int &a) return 1 ;int f (int &&a) return 2 ;
void solve () int a = 1 ;int &b = a;int &&c = 1 ;
cout << f (1 ) << endl; // 2 f (a) << endl; // 1 f (b) << endl; // 1 f (c) << endl; // 1
对应的输出结果也写在每一行的后面了,这似乎有一些意料之外的情况
第一行,一个单独的数字 1,很明显的确实是一个右值,符合预期 第二行,变量 a 明显也是一个合情合理的左值,那么也是符合预期的 接下来第三行,变量 b 作为 a 的一个引用,那毫无意义也是一个左值(b 只是引用了 a 的值,实际上仍然是 a 本身),符合预期 但是第四行,却让人摸不着头脑,明明 c 是一个明确的右值引用,为什么也是一个 1 这似乎表明了,c 是一个合法的左值,而非右值
尝试做一些看起来非法的操作
1
2
3
int &&c = 1 ;10 ;// 11
看起来非常的合法合理,就像是一个活灵活现的左值,而并非它类型那样描述的右值。即然是左值,那么必然有地址,输出看看
1
2
3
cout << &a << endl; // 0x7fff1ba1f724 // 0x7fff1ba1f724 // 0x7fff1ba1f72c
从上面的数字可以看出来,c 确实是在栈上,即拥有一个合理合法的地址,这是发生了什么?
如果把上述的代码改成汇编语言后,再看看结果
1
2
3
4
5
6
int main () int a = 1 ;int &b = a;int &&c = 1 ;10 ;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
.cfi_startproc .cfi_def_cfa_offset 16 .cfi_offset 6 , -16 movq %rsp, %rbp.cfi_def_cfa_register 6 $32 , %rsp ; 以上均为函数定义需要的一些基本操作,例如记录栈位置等,忽略 movq %fs:40 , %rax ; 设置 canary 值,用于检测 stack overflow 现象 movq %rax, -8 (%rbp) ; 将 canary 值保存到栈的前 8 个字节中 ; 任何值 xor 自己必定为 0,此处相当于清理 eax 寄存器 $1 , -32 (%rbp) ; 将 1 存储到 28-32 这几个字节中(int 占用 4 个字节)【变量 a】 32 (%rbp), %rax ; 将【a】的地址拷贝到 rax movq %rax, -24 (%rbp) ; 将【a】的地址保存到 16-24 这几个字节中(64bit 上占用 8 个字节)【变量 b】 $1 , %eax ; 将值 1 写入 eax 28 (%rbp) ; 将 eax 的值写入 24-28 这几个字节中【未知变量】 28 (%rbp), %rax ; 将【未知变量】的地址拷贝到 rax movq %rax, -16 (%rbp) ; 将【未知变量】的地址写入到 8-16 这几个字节中【变量 c】 movq -16 (%rbp), %rax ; 再读取【变量 c】的到 rax ; 将【变量 c】认为是一个地址,取出此地址中的值并写入到 eax 中 10 (%rax), %edx ; edx = rax + 10 movq -16 (%rbp), %rax ; 将【变量 c】的值拷贝到 rax 中 ; 将 edx 的结果保存到 rax 对应的值的地址中(即写入【变量 c】作为地址所在的位置) $0 , %eax ; 清空 eax movq -8 (%rbp), %rax ; 取出 canary 值 40 , %raxje .L3call __stack_chk_fail@PLT
可以注意到,对于引用而言,汇编仍然使用的是指针来解决,所以可以看到变量 b 记录下的是 a 的指针,而非真正的给 a 做了一个别名。而 c 也是一个指针,指向了一个未知的变量。这似乎就是我们寻找的答案
从内存本身而言,任何值都可以认为是左值,因为一个值存在,则必定存在具体的地址,即使它是作为常量的方式写在代码中,那起码它也应该存在于代码段,“存在即有地址”
但是对于这种在代码段“有地址”的值,又违背了代码段不可修改的原则,而具体操作的时候又未免会使用到这些值,这个时候,编译器会将代码段的这个值拷贝到栈空间,然后将其再赋给具体的对象,这个拷贝过来的值,像是一个右值,同时又具有着左值的特点,更确切的说,它属于“将亡值(xvalue)”。
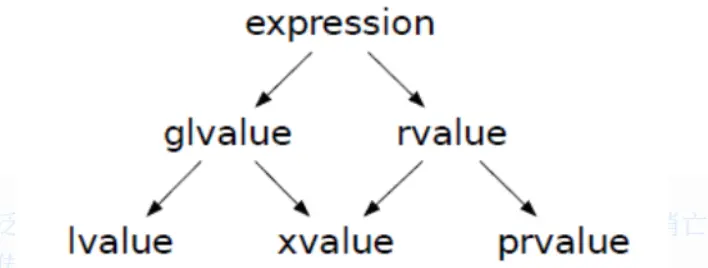
其中,lvalue 和 rvalue 就是我们一般认为上的左值和右值,而 glvalue 则是包含了将亡值的泛左值,而 prvalue 则是指那些纯右值,也就是那些在代码段里的值
将亡值则表示一种中间变量,例如使用了纯右值的时候,或者隐式类型转化,或者函数的返回值,这些都是将亡值充当的角色。实际上他们都有确切的栈上地址。
但是将亡值本身的含义是一个临时存在的变量,终是不可久留,这也就意味着编译器通常会限制对将亡值进行左值引用的方式。例如
此时编译器的报错是:Non-const lvalue reference to type 'double' cannot bind to a temporary of type 'double',即无法通过一个非常量的左值引用指向一个将亡值。而当你改成 const double &x = (double)1; 后,程序又可以通过编译了。这也说明了编译器实际上只是在做一些安全性的检查,并没有真正限制修改将亡值,甚至可以将将亡值变成长期存在的栈上的值(例如一开始的程序)