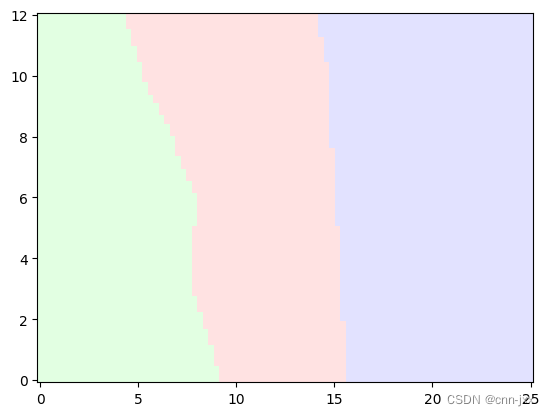
import numpy as np import matplotlib.pyplot as plt from sklearn.neighbors import KNeighborsClassifier from sklearn import metrics from sklearn.model_selection import train_test_split from sklearn.model_selection import cross_val_score
1 2 3 4 5 6 7 8 9 10
X1,y1=[],[]
fr = open('./knn.txt')
for line in fr.readlines():
    lineArr = line.strip().split()
    X1.append([int(lineArr[0]),int(lineArr[1])])
    y1.append(int(lineArr[2]))
X=np.array(X1)
y=np.array(y1)
X_train,X_test,Y_train,Y_test=train_test_split(X,y,test_size=0.16)
1
2
3
4
5
6
7
8
k_range = range(1, 9)
k_error = []
for k in k_range:
    knn = KNeighborsClassifier(n_neighbors=k)
    scores = cross_val_score(knn, X, y, cv=3, scoring='accuracy')

    k_error.append(1 - scores.mean())
1
2
3
4
5
6
k_error.pop(0) k_min = min(k_error) k = k_error.index(k_min)