aufgrund der schon beschriebenen Performance-Probleme, möchte ich bei mehreren 2025-Servern die Treiber downgraden. Wie funktioniert das bei schon installierten 1.285-Treibern?
Einfach das ISO einbinden und den Wizard nochmal durchlaufen lassen? Überschreibt der dann die neueren Treiber?
Normalerweise müsstest Du über den Gerätemanager gehen, das entsprechende Gerät auswählen, es entfernen und den Treiber dabei löschen.
Den PC / VM neu starten und den älteren Treiber dann über den Gerätemanager installieren.
Evtl. Reicht es auch, den Gerätemanager nach neuer Hardware suchen zu lassen.
Es gibt auch Treiber (prewhql), die mit Experimental im Upstream Ordner bei Fedora gekennzeichnet sind. https://fedorapeople.org/groups/virt/virtio-win/direct-downloads/upstream-virtio/
Die ZIP 0.1.296 enthält Treiber mit Dateidatum vom 02.02.2026 - die würde ich aber vielleicht eher mal auf einem Testsystem probieren, als auf einem Produktivsystem.
Vielleicht lohnt es sich auch zu warten, bis neuere Treiber offiziell veröffentlicht werden.
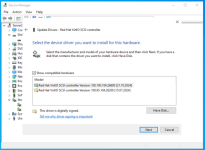
du solltest normalerweise auch im gerätemanager manuell den älteren treiber zuweisen können:
hier sieht man die unterschiedlichen installierten teriberversionen.
ich meine er würde dann auch bei der version bleiben und nicht wieder automatisch updaten.
Randnotiz: falls winget verwendet wird (afaik in Server 2025 enthalten) einen Pin auf virtio* bzw Qemu* setzen. Sonst werden bei einem winget upgrade —all fröhlich die Guest Tools aktualisiert.
Ja, im Grunde reicht es den vioscsi-Treiber gezielt runterzusetzen, das ist der, der die Performance-Probleme macht. Der einfachste Weg ist über den Gerätemanager wie @beisser gezeigt hat: Red Hat VirtIO SCSI controller → Eigenschaften → Treiber → "Treiber aktualisieren" → "Auf dem Computer nach Treibern suchen" → "Aus einer Liste verfügbarer Treiber auswählen", dann die ältere Version nehmen. Da brauchst du nix zu deinstallieren und keinen großen Neustart.
Wenn die ältere Version dort nicht auftaucht (weil nur die 1.285er drauf ist), vorher das 1.271er ISO mounten und per "Datenträger" den Pfad zum vioscsi-Ordner angeben. Wichtig: den passenden Unterordner wählen, also vioscsi\2k25\amd64 (oder wie auch immer euer OS-Mapping ist).
@cwt hat nen guten Punkt mit dem winget-Pin, das würd ich direkt mitmachen, sonst holt euch der nächste winget upgrade --all die 1.285er wieder zurück.
Was die Downtime angeht @sgw: der Treiberwechsel über den Gerätemanager braucht einen Reboot, aber das wars. Würd ich trotzdem erstmal an einer VM testen bevor ihr das auf allen Produktiv-Kisten macht.
Danke @Bu66as ... ich bin schon durch seit ~30 Minuten ;-) / aber Dein detailliertes Howto ist hilfreich auch für zukünftige Suchende.
Es ging um 2 problematische VMs, die hab ich beide entsprechend "runter-gestuft", inkl. Reboots und Kontrolle der Version danach. winget spielt bei dem Kunden keine Rolle, denke ich. Behalte ich im Hinterkopf.
Sofern sich die 2 VMs nun OK verhalten, sehe ich mir in einem ruhigeren Zeitfenster evtl noch die anderen Treiber an. Netzwerk und SCSI sind nun auf .271, das hab ich jedenfalls geprüft in der Eile.
Die 2 VMs waren relativ random in Hochlast gegangen und mussten danach neu gestartet werden, teils nur per Reset möglich. Lästig.
Leider war's das nicht: beide VMs heute wieder mit Problemen, höre ich gerade vom Kunden.
Sein Admin, der die VMs gebaut hat, ist noch in Urlaub, ich kann ihm zwar vielleicht VMs neu installieren, aber nicht seine Software darin deployen.
Ich kann ihm weiters nur anbieten, die PVEs zu aktualisieren, da sind wir 1-2 Wochen mit Patches im Rückstand (eben aus dem Gedanken heraus, in Abwesenheit des Mitarbeiters nix zu tun, wenn es nicht sein muss).