惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Last Week in AI
Last Week in AI
U
Unit 42
博客园 - 【当耐特】
Y
Y Combinator Blog
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Microsoft Security Blog
Recent Announcements
P
Proofpoint News Feed
Martin Fowler
Martin Fowler
量子位
让小产品的独立变现更简单 - ezindie.com
有赞技术团队
有赞技术团队
aimingoo的专栏
aimingoo的专栏
博客园 - 司徒正美
美团技术团队
雷峰网
雷峰网
小众软件
小众软件
G
Google Developers Blog
GbyAI
GbyAI
Jina AI
Jina AI
爱范儿
爱范儿
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
F
Fortinet All Blogs
Vercel News
Vercel News

Nicksxs's Blog

Pi Agent 源码解析(一):从调试环境到双层主循环 6GB显存能跑35B MoE吗:FreeToken极限配置、性能压榨与实操教程 聊聊 Java 的类加载机制一 从ASM到ByteKit再到Arthas:一条Java字节码增强链路 8GB显存如何跑35B:深入理解FreeToken的专家缓存与CPU-GPU协同 让chatgpt来给我讲解下deepseek harness的插件体系 来学习下pi agent的原理 如何在命令行中输出进度条 联想 G400 安装 Windows 7 折腾记录 记一个gitea推送失败的问题 学一下chrome的扩展开发 看下chrome的内置模型 从 app.test 到小锁:valet 本地 HTTPS 的完整链路 浅析一下jpeg图片格式及其来源 关于github拉取下载加速的另一个方式 关于适合什么模型,推荐下llmfit 看看目前本地能跑什么模型,使用llama.cpp 最近使用vibe coding的一些感悟 使用php的inotify扩展来监听文件变更 一些设计模式的记忆点 使用xiaomi mimo大模型api运行Hermes Agent 结合Obsidian的cli的一体化体验 开始尝试使用obsidian作为笔记软件 学习下大神的知识库 体验下微软开源的Markdown转换工具Markitdown 学习下git的worktree 一些架构师知识点的记录 解答一下关于traefik的一点疑惑 记录一下迁移服务器需要使用的一些命令 较早代iPhone更换新iPhone的一些小指南
来看下我装备了5060TI显卡的gpt-oss模型表现
2025-11-30 · via Nicksxs's Blog

之前在我的3060笔记本上试了有显卡的情况下gpt-oss的表现,只能说勉强可以用,比mbp上是可用了很多,毕竟那玩意除非完全把内存都让给gpt-oss,不然都跑不起来,只是生成速度还是有点感人,差不多就4.66token/s,一直觉得能在本地跑个稍微能用点的模型还是种比较不错的体验,所以在最近买了个5060TI,因为这个是最便宜的16G显存的家用显卡了,当然排除各种魔改卡,比如镭7这种,当然喜欢折腾的也可以买来玩玩,硬件上要玩起来还是需要比较多时间的
今天用同样的prompt来再对比测试下
3060 6g笔记本显卡
prompt是
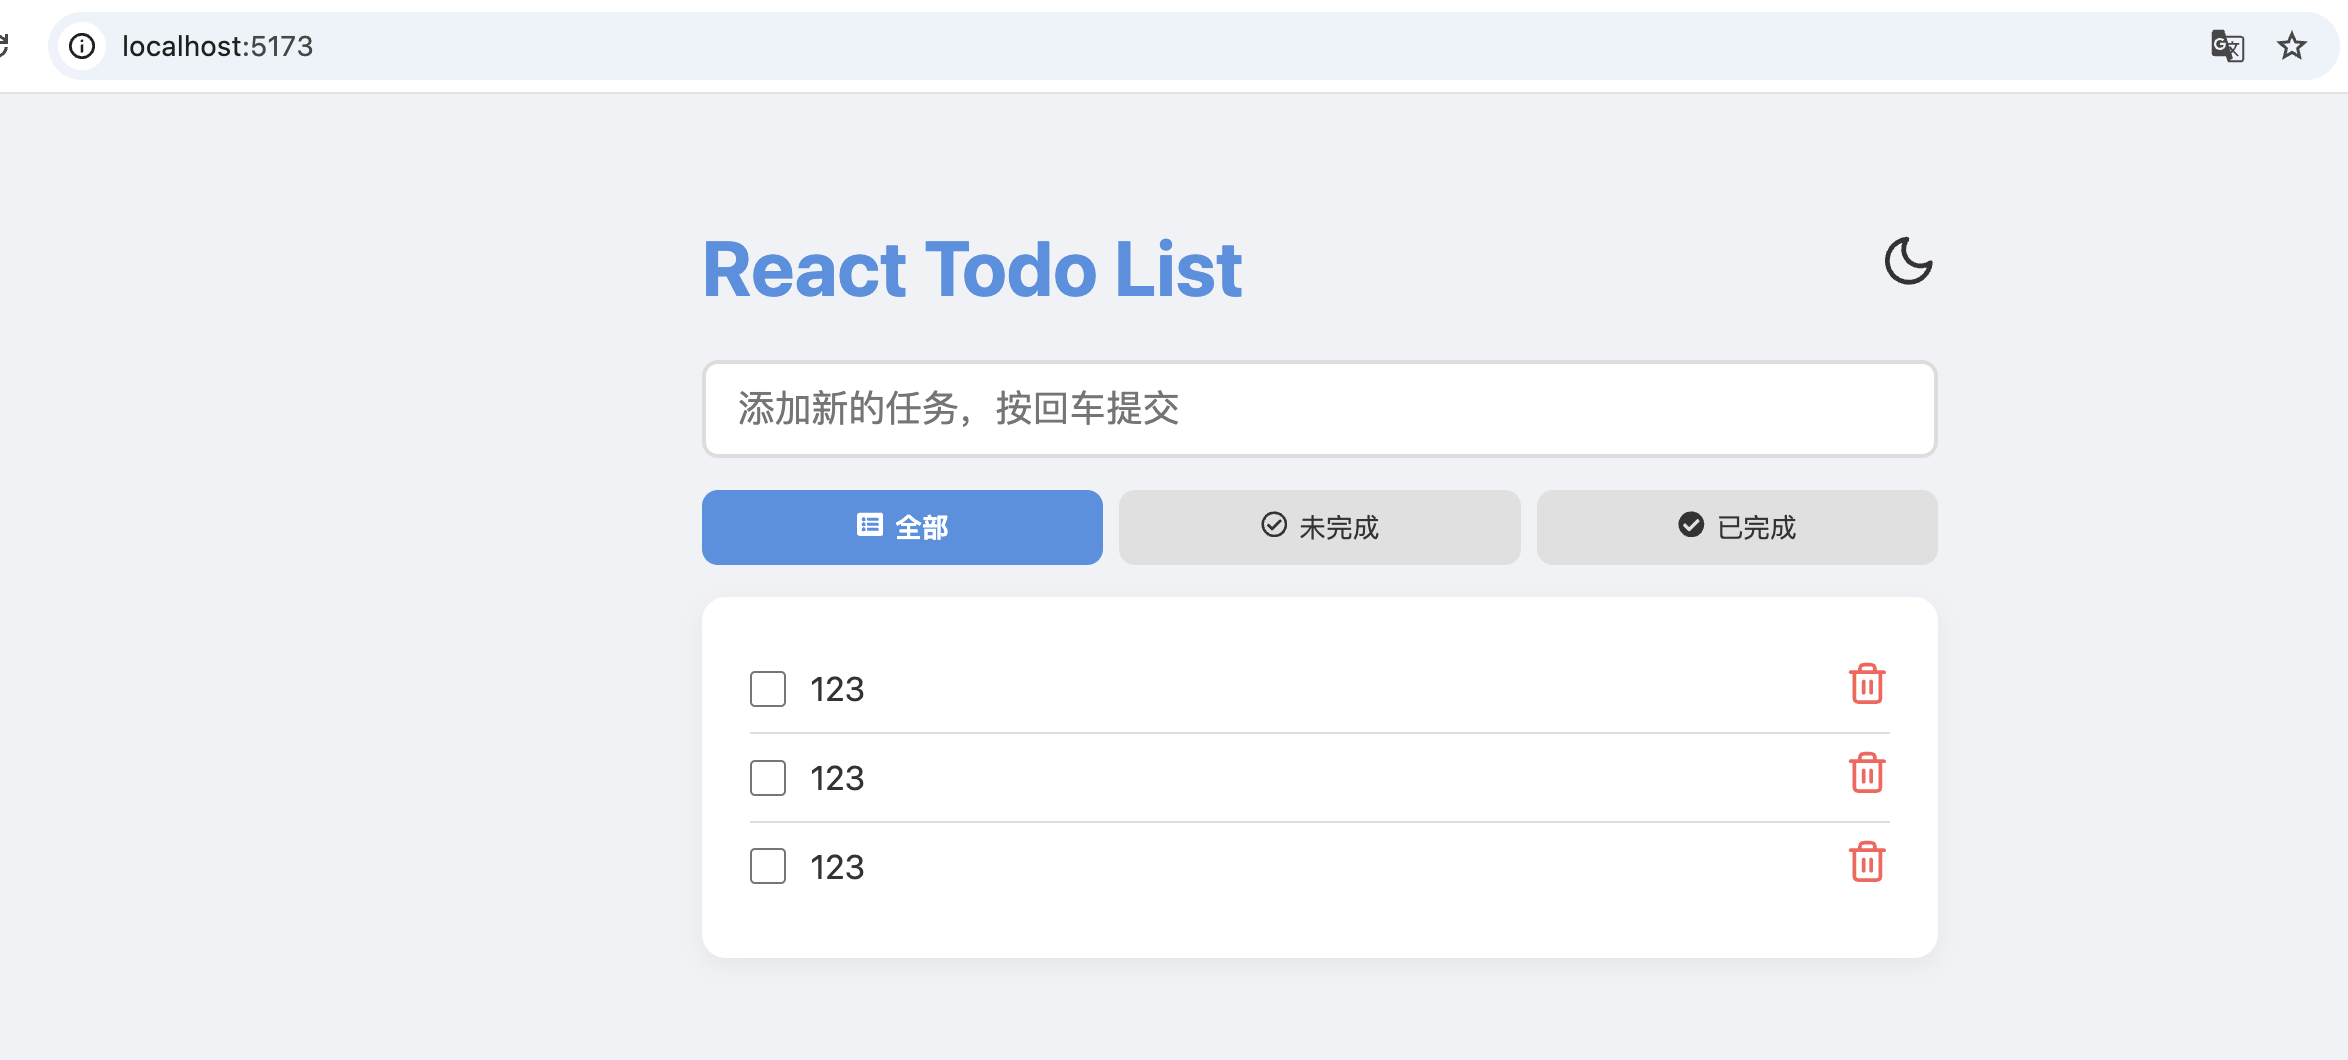
帮我用react写一个todo应用,样式要美观精致
我们先对比下效果

生成的还是比较简介,重要的是正确的

1
2
3
4
5
6
7
8
9
10
11
12
13
1.77 token/s


2926 token


首个token用时 2.21 s


停止原因: 检测到 EOS token

对比的是
5060ti 16g显卡
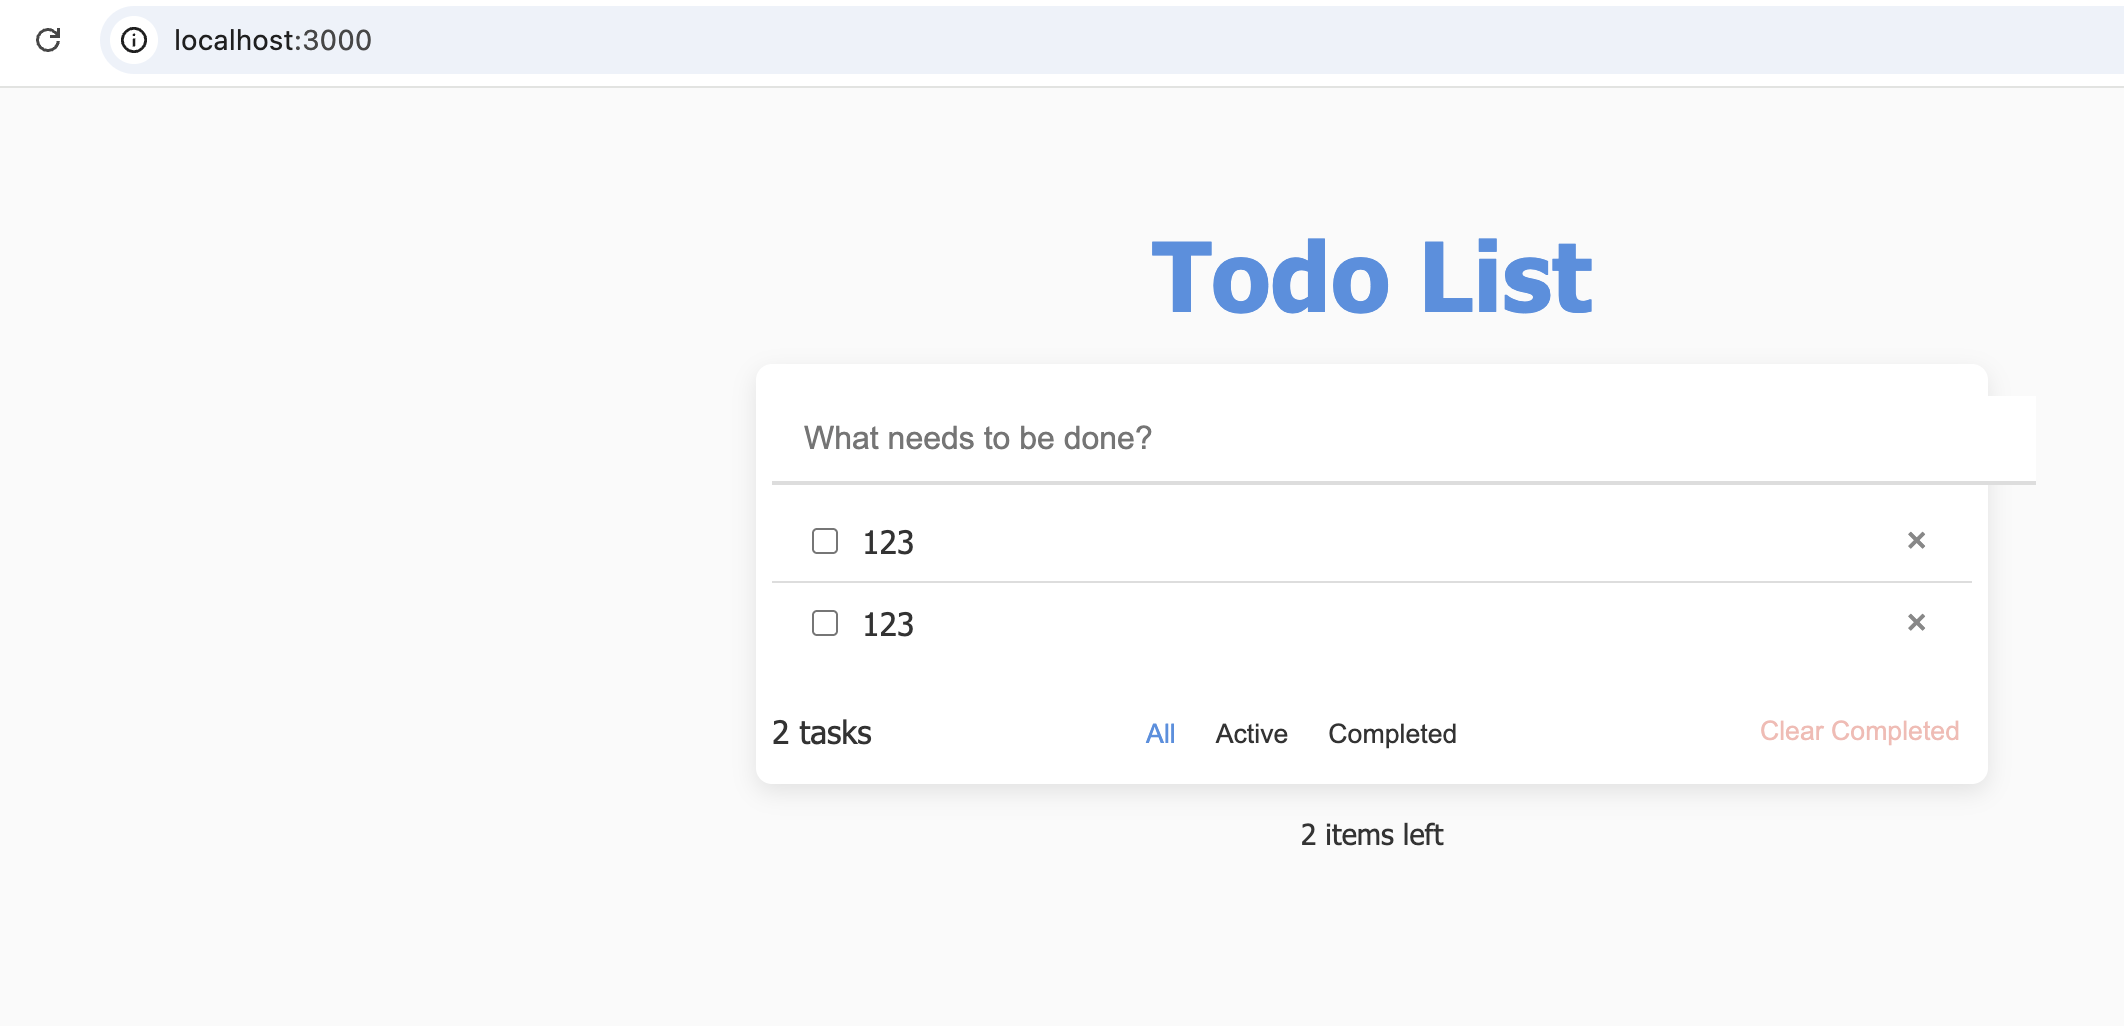
我们也来看下效果

样式稍稍有点问题,但是能一次运行成功

1
2
3
4
5
6
7
8
9
10
11
12
13
27.91 tok/sec


2236 tokens


0.41s to first token


Stop reason: EOS Token Found

对比两次运行,其实3060在一开始think的时候也耗时比较久,后续生成的速度差异也是比较大的
这简单对比比较能看出来能把整个模型权重加载进显存还是有比较大优势的,不过既然本身可以不全加载进显存,我是不是也可以试试32B的模型,毕竟有16+32的显存组合,16显存+32是内存共享的,下次可以体验试试看,比如32B的qwen模型