

惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

L
LangChain Blog
酷 壳 – CoolShell
酷 壳 – CoolShell
雷峰网
雷峰网
量子位
V
V2EX
S
SegmentFault 最新的问题
月光博客
月光博客
博客园 - 【当耐特】
Hugging Face - Blog
Hugging Face - Blog
V
Visual Studio Blog
大猫的无限游戏
大猫的无限游戏
T
Tailwind CSS Blog
博客园_首页
博客园 - Franky
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
美团技术团队
Y
Y Combinator Blog
The Cloudflare Blog
C
Check Point Blog
Cyber Security Advisories - MS-ISAC
腾讯CDC
B
Blog
Stack Overflow Blog
Stack Overflow Blog
P
Proofpoint News Feed

LINUX DO - 最新话题

谷歌云盘下载700g数据集,求方法 OpenAI推出了100美元的Pro订阅后,plus的Codex 5小时限额大幅缩水 之前买的super grok居然还没掉 关于CPA认证文件周限 佬们,默认CDK的要求是什么等级啊? 最新版本的微信群聊机器人方案 有没有人知道如何free号没有封,那么是否可以循环使用,因为我看主要是周限 L站改版了?吓我一跳,我以为我浏览器崩了 淘宝这种宽带可信吗,500兆移动宽带月费8元到2099年 docker内部应用访问宿主机mysql和redis时被拒绝connection refuse Erp全栈想转行做Ai有什么推荐的吗 boost有bug 佬们,有没有靠谱点的 Plus 购买渠道 大妈,狗妈用的 lg 服务有源头开源项目吗? 有人有能过验证码打码的嘛 上次帖里好像发过通过大模型来打码的 gpt plus 封号似乎也太快了点,一天就给封号了 按流量/token收费的国产官方AI推荐 我算是知道了为什么Oracle总是ABC了 佬友们帮我分析一下 ChatGPT Team账号只有一个人使用和4个席位邀请满了使用的总额度是一样的吗? gpt-free 10个带rt CPA反代claude是默认1m吗? 我终于敢说我做出来windows上tmux的替代了,目标windows/全平台最强的终端Ai编程工具 claude pro升级max,除了原来的$20,好像还能再领一次$100 关于AI agent的知识框架 独乐乐不如众乐乐,分享一下我的的AI对话程序 佬们自建网站支付问题是怎么解决的 怎么能让gpt模仿claude风格输出 codex free已经死了,下一个会是plus或者team吗 请问chatgpt pro里的fast模式,速度快了,降智吗
arXiv:2605.27922: Agent能力取决于模型还是harness?Harnes...
yongru_cheng (chengyongru) · 2026-06-03 · via LINUX DO - 最新话题

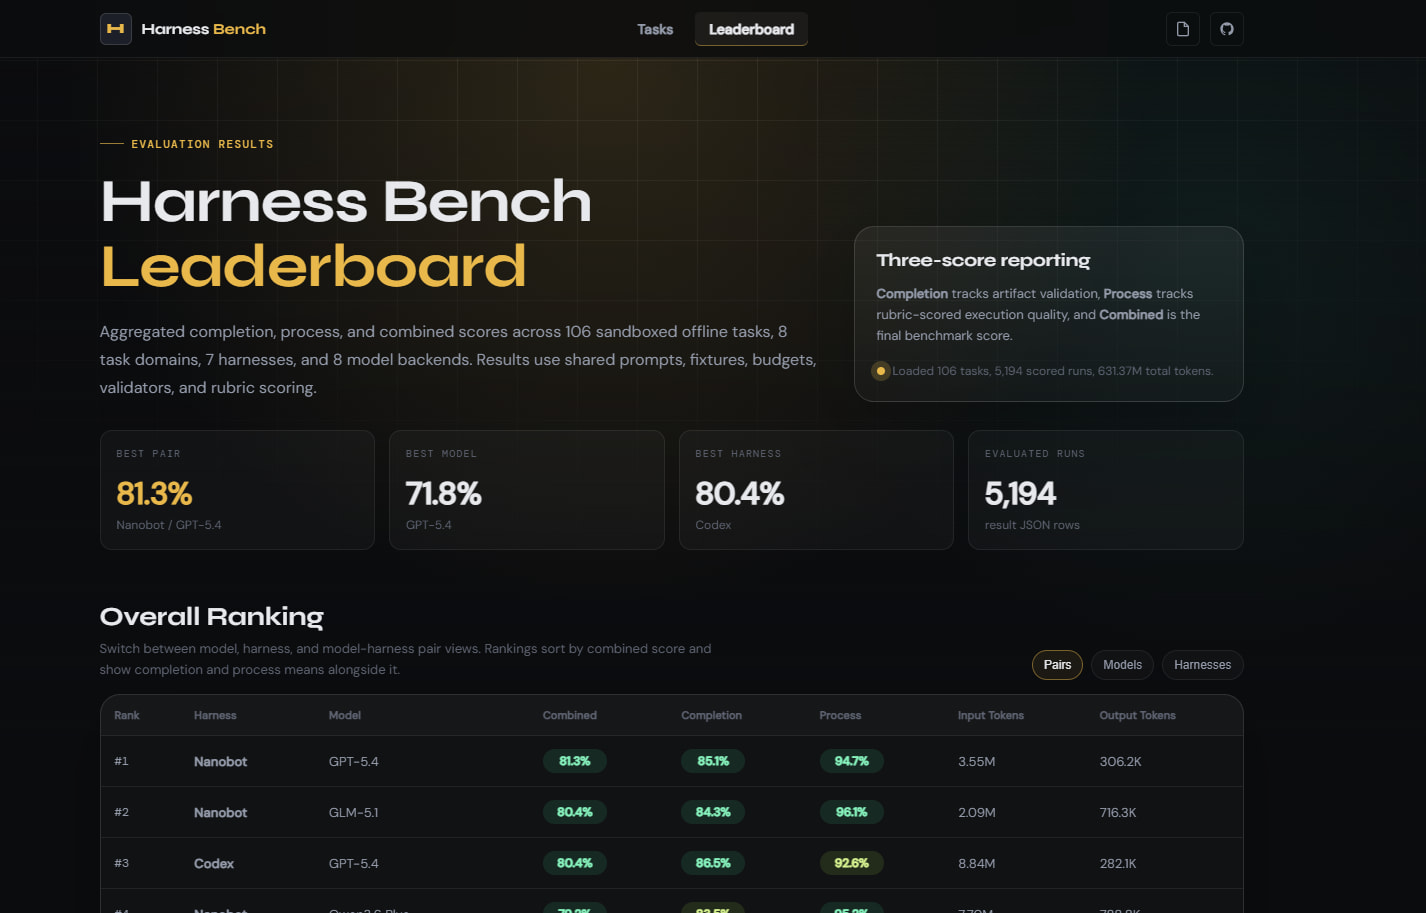
论文:[2605.27922] Harness-Bench: Measuring Harness Effects across Models in Realistic Agent Workflows 注: 北大*360
代码:GitHub - Qihoo360/harness-bench · GitHub
image

harness bench 简单来说就是固定任务和模型,只换harness,看agent表现差多少。

方法

106个沙箱化离线任务,8个类别(SWE、数据分析、DevOps、长程状态维护等),每个任务有独立的oracle grader。

评估维度有completion score 、LLM judge score 和security score。

测了6个现在比较火的agent(OpenClaw、nanobot、Hermes、ZeroClaw、NullClaw、Moltis) 8个模型后端(gpt-5.4、claude-opus-4.6、claude-sonnet-4.6、gemini-3.1-pro-preview、qwen3.6-plus、glm-5.1、kimi-k2.5、deepseek-v4-flash),总共5194条execution trajectories。

几个关键结论

同模型换框架,综合分最大差距23.8分(nanobot 76.2 vs OpenClaw 52.4)。说明agent benchmark只报模型得分而不报框架配置是不够的。

Failure mode分析(Table 3)比较有参考价值:36.4%的失败是contract/format类,即agent产出了内容但格式不满足验证条件;24.6%是tool/recovery类,即工具调用出错后没能恢复。真正的推理错误只占一小部分。对框架设计的启示:容错和输出校验比堆模型能力更影响实际成功率。

强模型(gpt-5.4、claude-opus-4.6)跨harness的方差更小,中等模型对harness质量更敏感。好的harness能显著拉高中等模型的上限。

Token效率方面差异显著,同样任务不同harness消耗的token能差3-4倍,主要取决于上下文构建策略。

局限

全部是离线沙箱任务,没有在线服务、用户交互、长期记忆场景。LLM judge score 依赖LLM judge,引入了评估方的主观性。只测了配置级差异,没有因果分解。

Section 5提出的execution-alignment概念值得注意:框架的核心价值在于维持agent推理、workspace实际状态、工具返回结果、最终验证条件之间的对应关系,大多数失败的根本原因不是模型推理出错,而是agent的内部判断和外部实际状态脱节了,比如以为文件改对了其实没改,以为命令成功了其实报错了。

Nanobot 有那么好? 它的 harness 好在哪儿, 很怀疑这个榜单啊, 是不是香港大学自己排的 :distorted_face:

===========
哦? 是下崽器360啊, 那没事了

nanobot + gpt5.4 > codex + gpt5.4
我在做什么梦 :distorted_face:

怎么还有DeepSeek V4 Flash > Claude Opus 4.6的
可能我真的不懂科学研究

junday (异人) 5

nanobot有人用过吗?说说怎么样

aikooor 6

我觉得这种没有理论证明都很难说明通用性,还是以实际使用为准吧。。。。