


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

P
Proofpoint News Feed
Blog — PlanetScale
Blog — PlanetScale
GbyAI
GbyAI
C
Check Point Blog
腾讯CDC
Stack Overflow Blog
Stack Overflow Blog
Cyber Security Advisories - MS-ISAC
The GitHub Blog
The GitHub Blog
A
About on SuperTechFans
Recent Announcements
L
LangChain Blog
Microsoft Azure Blog
小众软件
小众软件
J
Java Code Geeks
博客园_首页
Jina AI
Jina AI
美团技术团队
H
Help Net Security
MyScale Blog
MyScale Blog
Engineering at Meta
Engineering at Meta
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
人人都是产品经理
人人都是产品经理
Y
Y Combinator Blog
S
SegmentFault 最新的问题

博客园 - T.t.T!Ck.¢#

博文阅读密码验证 - 博客园 博文阅读密码验证 - 博客园 人工神经网络(Artificial Neural Netwroks)笔记-模拟退火算法(Simulated Annealing) 人工神经网络(Artificial Neural Netwroks)笔记-径向基函数(Radial Basis Function- RBF) 人工神经网络(Artificial Neural Netwroks)笔记-粒子群优化(Partical Swarm Optimization - PSO) 识别地图上的地名-- 笔记一 人工神经网络(Artificial Neural Netwroks)笔记-基本的非确定性统计训练算法 - T.t.T!Ck.¢# 人工神经网络(Artificial Neural Netwroks)笔记 人工神经网络(Artificial Neural Netwroks)笔记-消除样本顺序的BP算法 博文阅读密码验证 - 博客园 人工神经网络(Artificial Neural Netwroks)笔记-连续多输出感知器算法 人工神经网络(Artificial Neural Netwroks)笔记--离散多输出感知器训练算法 博文阅读密码验证 - 博客园 人工神经网络(Artificial Neural Netwroks)笔记-离散单输出感知器算法 BeIT Memcached web页面列表的内容抽取 文本相似度计算--余弦定理和广义Jaccard系数 倒排序索引实验 坏事做尽--通过修改IL获取某资源文件 - T.t.T!Ck.¢# - 博客园
Mutual Information 互信息的应用
T.t.T!Ck.¢# · 2008-06-25 · via 博客园 - T.t.T!Ck.¢#

MI使用如下公式计算某个特征项t和类别c之间的相关性。
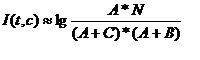
MI.bmp

其中,Atc同时出现的次数;Bt出现而c没有出现的次数;Cc出现而t没有出现的次数。N为所有文档数。如果tc不相关,则I(t,c)值为0。如果有m个类,于是对于每个t会有m个值,取它们的平均,就可得到特征选取所需的一个线性序。大的I平均值的特征被选取的可能性大。

上面为互信息(Mutual Information,MI)在文本自动分类中的应用,体现了词和某类文本的相关性

互信息(Mutual Information,MI)应用还相当广泛,例如可以做新词发现。

新词发现的思路如下:

对训练集中的文本进行字频的统计,并且统计相邻的字之间的互信息,当互信息的值达到某一个阀值的时候,我们可以认为这两个字是一个词,三字,四字,N字的词可以在这基础上进行扩展

搜索引擎检索的结果的排序现在都是使用PageRank算法计算得到重要度而进行排序

小型的搜索引擎要搞PageRank算法这样的统计貌似并不是一件容易的事情,因此某些小型的搜索引擎会喜欢说 相关度排序

相关度排序要做的事情就简单多了

就是计算 检索的关键字与检索结果的相关性,而这种计算又可以转换为 检索的关键字与检索结果的词的相关性计算

此时还是可以使用互信息(Mutual Information,MI)来进行计算,但是计算的数量要增加不少

主要计算的是两个词在文章中同时出现的次数,例如 原子弹 和 核辐射 同现的次数肯定比  核辐射 和 猪肉 同现的次数要高,而我们也知道 原子弹和核辐射是比较相关的。

正是根据这样的思想得到了相关度排序的依据

互信息(Mutual Information,MI) 的缺点是 前期预处理的计算量比较大,计算结果会形成一个 big table,当然只要适当调整阀值还是可以接受的。

在项目中完成的一个  搜索引擎相关度排序就是利用互信息(Mutual Information,MI)来实现,计算得到的模型大概是 50MB, BT一点利用单例模式一次加载到内存中去,给其他应用使用,虽然资源占用比较大,但是得到的效果还是不错的