


在 AI 浪潮席卷而来的当下,我们团队紧跟技术趋势,近期致力于构建企业级 AI 中台。我们的技术栈涵盖了 OCR 识别、智能语音交互、语音数字人、知识库 以及 AI Agent 等核心模块。
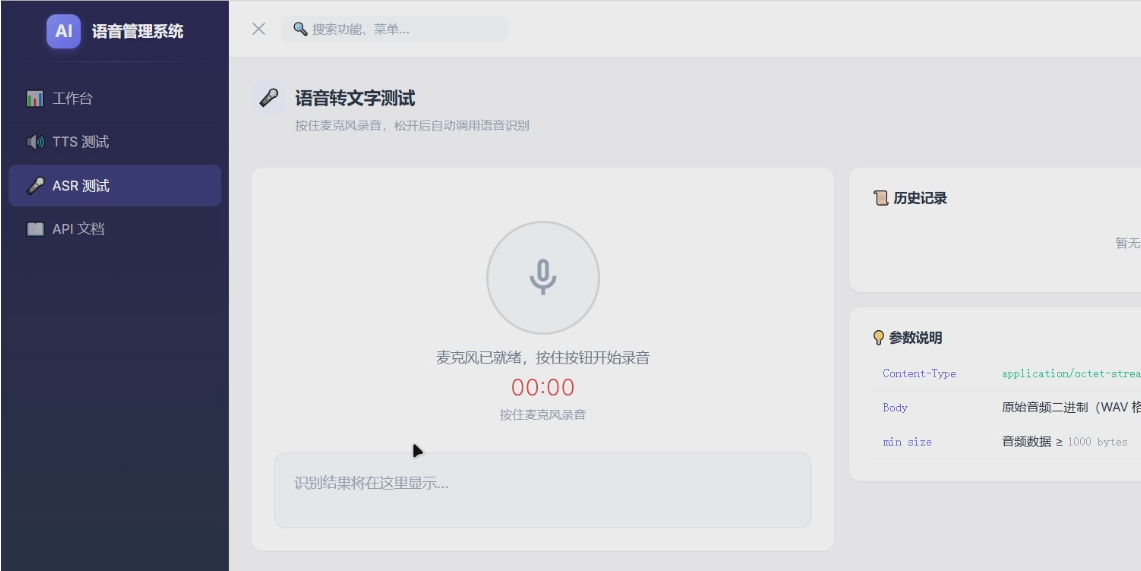
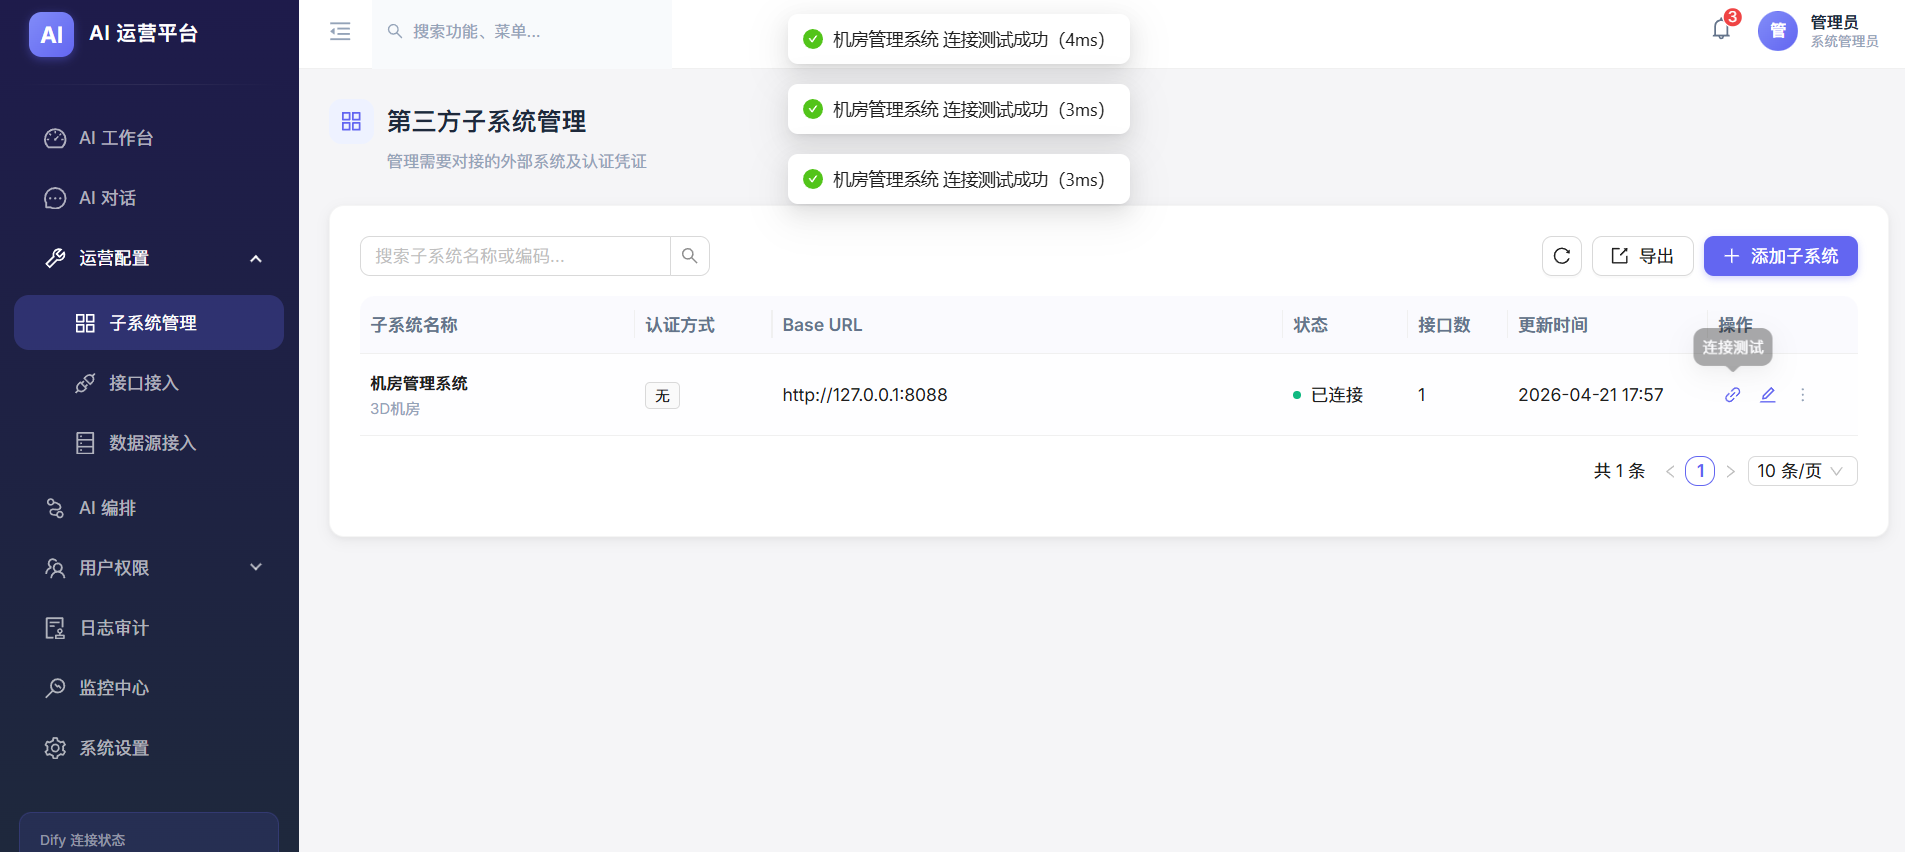
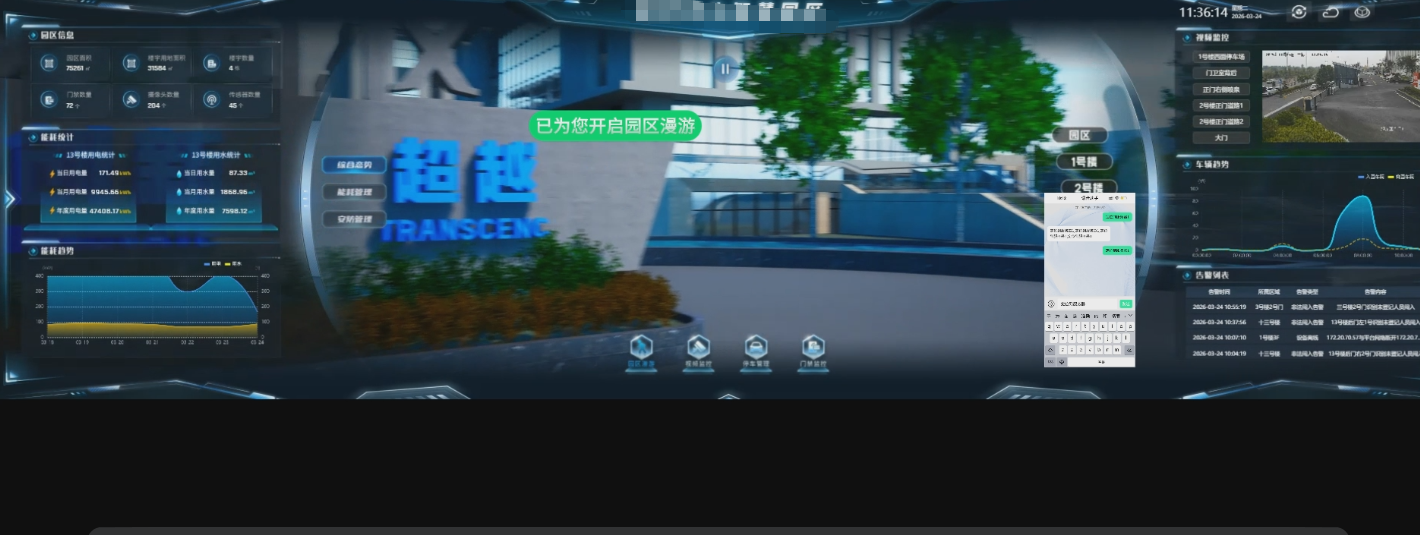
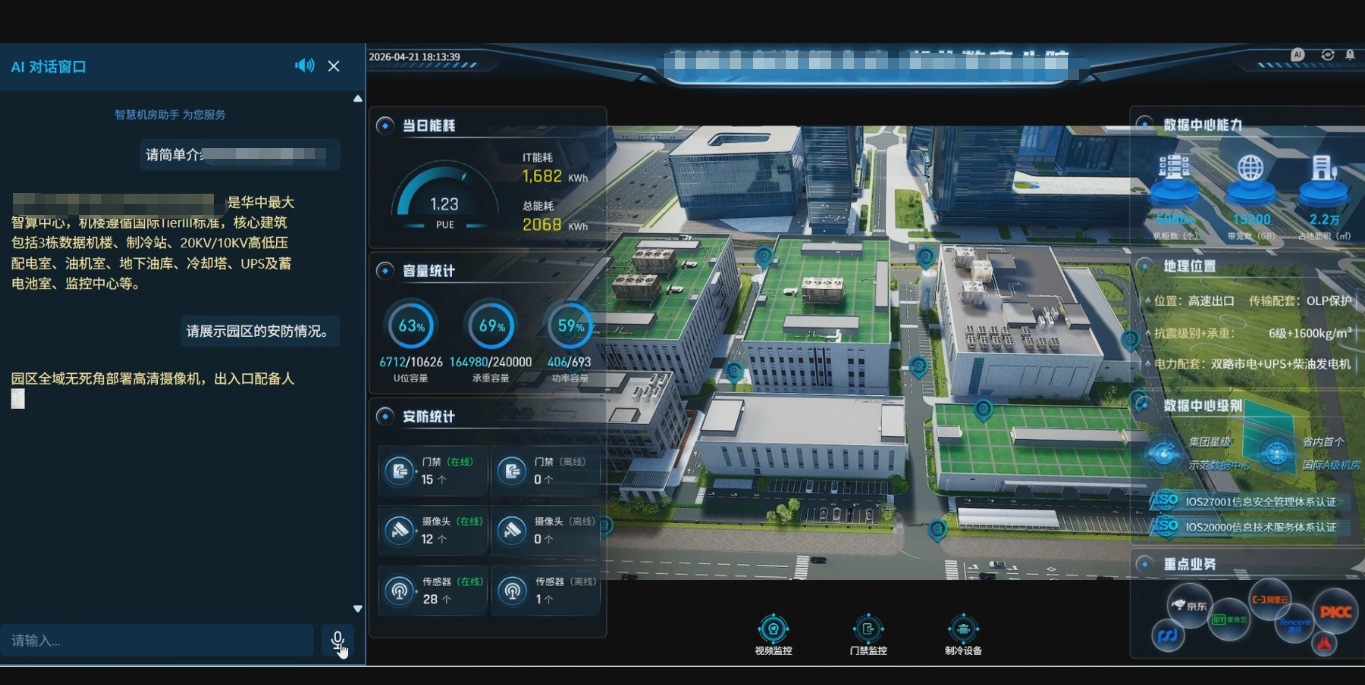
AI中台和数字孪生系统的结合,赋予数字孪生系统 语音交互,智能播报,业务助手等能力。 **从“可视”到“可听、可说、可思” **
最近我在处理一个孪生资产管理的知识库时,就遇到了一个非常典型的痛点:当用户搜索“1#楼”时,系统经常召回不到任何有效信息;或者即使召回了,也是一堆重复啰嗦的设备列表,导致 LLM 被噪声淹没,回答质量极差。
做 RAG(检索增强生成)的朋友都知道,最让人头秃的往往不是大模型不会回答,而是它根本“找不着北”。
经过一番排查和优化,我通过“层级化分片”配合“高频重复噪声去重”策略,将召回率和最终回答的准确率提升了几个量级。今天就来复盘一下这个过程,并拆解背后的技术原理与代码实现。
在优化之前,我的数据是典型的“扁平化表格”结构。向量数据库里存储的是一条条独立的记录。这种传统的“一刀切”分片方式,带来了两个致命问题:
lou1。虽然人类知道它们是一回事,但 Embedding 模型很难完美对齐。更致命的是,假设用户问“1#楼1层有哪些温湿度传感器?”,系统可能召回了传感器的记录,但这条记录里根本没有“它在1#楼”的信息。模型就像拿到了拼图的一块,却死活拼不出全貌。type 都是“温湿度传感器”,status 都是“正常”)。如果按行切分,这些高频重复的词汇会极大掩盖掉真正有区分度的词(如具体编号、位置),导致向量在空间里挤成一团,区分度极低,检索时全是“伪高分”的废话。你可能会有疑问,多写几遍“温湿度传感器”和“状态正常”,难道不是更能强调它的特征吗?实际上恰恰相反,这种重复语言会从底层严重破坏 RAG 的检索效果:
为了解决这两个问题,我放弃了扁平化的单行切分,设计了一套组合拳:
优化后的分片效果长这样:
### 🏢 1#大楼 (ID: lou1)
**层级路径**:park -> lou1 (1#大楼)
**别名**:1号楼, 1楼, 1栋, 1#楼

#### 1. 包含的子级资产
- **floor**
  - 编号: IDC1-1, IDC1-2, IDC1-3
### 🏢 1F (ID: IDC1-1)
**层级路径**:lou1 -> IDC1-1 (1F)
**别名**:无

#### 1. 包含的子级资产
- **device** (公共属性: status: 正常, vendor: 海康威视)
  - 编号列表: SENS1, SENS2, SENS3... (共 10 个)
别名: 1号楼, 1楼。无论用户输入哪种叫法,Embedding 模型都能在该文本块中找到高度匹配的语义特征,相当于给向量加了一个“强力磁铁”。SENS1 是属于 lou1 的,消除了跨片段推理的难度。以下是完整的 Python 代码实现,包含数据预处理、同义词注入、层级聚合以及智能去重抽象的核心逻辑:
import pandas as pd

def generate_optimized_hierarchical_chunks(df: pd.DataFrame) -> list:
    """
    将扁平的 DataFrame 转化为层级化且去重的 Markdown 分片列表
    """
    chunks = []
    # 预先建立索引,方便快速查找子节点
    children_map = df.groupby("belong_to")

    for index, row in df.iterrows():
        asset_id = row['model_id']
        asset_name = row['model_name']
        asset_type = row['type']
        belong_to = row['belong_to']

        # 1. 动态生成同义词(解决“1#楼”召回难的问题)
        synonyms = []
        if asset_type == 'building' and '#' in asset_name:
            num = asset_name.split('#')[0]
            synonyms = [f"{num}号楼", f"{num}楼", f"{num}栋"]

        # 2. 获取当前节点的所有直接子节点
        children = children_map.get_group(asset_id) if asset_id in children_map.groups else pd.DataFrame()

        # 3. 【核心优化】处理子节点:去重、抽象与折叠
        children_text_list = []
        if not children.empty:
            # 按类型分组
            for child_type, group in children.groupby("type"):
                # 提取该类型下所有子节点的公共属性(去重)
                common_attrs = {}
                for col in group.columns:
                    if col not in ['asset_name', 'model_id', 'model_name', 'belong_to']:
                        unique_vals = group[col].dropna().unique()
                        if len(unique_vals) == 1:
                            common_attrs[col] = unique_vals[0]

                # 构建紧凑的展示文本
                type_header = f"- **{child_type}**"
                if common_attrs:
                    attrs_str = ", ".join([f"{k}: {v}" for k, v in common_attrs.items()])
                    type_header += f" (公共属性: {attrs_str})"

                children_text_list.append(type_header)

                # 折叠展示 ID,大幅减少重复文本量
                id_list = group['model_id'].tolist()
                if len(id_list) > 5:
                    display_ids = ", ".join(id_list[:3])
                    children_text_list.append(f"  - 编号列表: {display_ids}... (共 {len(id_list)} 个)")
                else:
                    children_text_list.append(f"  - 编号: {', '.join(id_list)}")

        # 4. 组装最终 Markdown 文本块
        chunk_text = f"""### 🏢 {asset_name} (ID: {asset_id})
**层级路径**:{belong_to} -> {asset_id} ({asset_name})
**别名**:{', '.join(synonyms) if synonyms else '无'}

#### 1. 包含的子级资产
"""
        if children_text_list:
            chunk_text += "\n".join(children_text_list)
        else:
            chunk_text += "- 无直接子级资产\n"

        chunks.append({
            "id": asset_id,
            "text": chunk_text.strip(),
            "type": asset_type
        })

    return chunks

# --- 模拟带有层级关系和大量重复描述的数据 ---
raw_data = [
    {"asset_name": "park", "belong_to": "", "model_id": "park", "model_name": "园区", "type": "park"},
    {"asset_name": "lou1", "belong_to": "park", "model_id": "lou1", "model_name": "1#大楼", "type": "building"},
    {"asset_name": "IDC1-1", "belong_to": "lou1", "model_id": "IDC1-1", "model_name": "1F", "type": "floor"},
    # 假设这一层有10个传感器,它们的 type, status, vendor 全都一样(高频重复噪声)
    *[{"asset_name": f"SENS{i}", "belong_to": "IDC1-1", "model_id": f"SENS{i}", "model_name": "温湿度传感器", "type": "device", "status": "正常", "vendor": "海康威视"} for i in range(1, 11)]
]
df = pd.DataFrame(raw_data)

# 生成优化后的分片
optimized_chunks = generate_optimized_hierarchical_chunks(df)

# 打印查看 1F 楼层这一级的完美去重分片效果
for chunk in optimized_chunks:
    if chunk['id'] == 'IDC1-1':
        print(chunk['text'])
经过上面处理,现实测试,召回率从原来的50% 提高了90%多,效果非常明显。
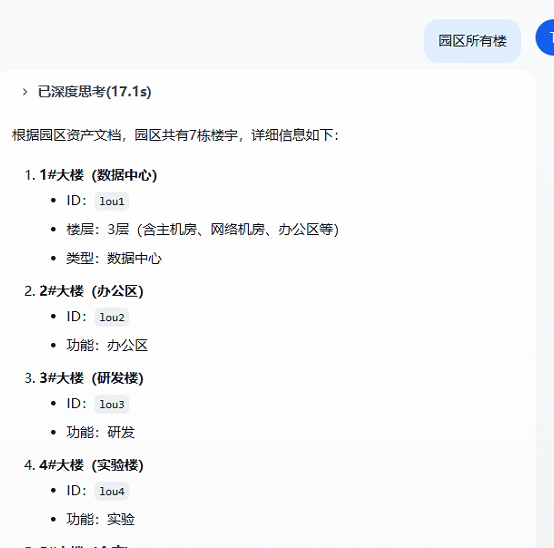
RAG 系统的效果,三分靠模型,七分靠数据治理。如果你也面临召回率低、模型经常“胡说八道”的困境,不妨试试这套组合拳:
召回率上来只是第一步,接下来你还可以引入 Rerank(重排序)模型来进一步过滤噪声,提升最终的回答准确率。继续冲!
最后,关注公号“ITMan彪叔” 可以添加作者微信进行交流,及时收到更多有价值的文章。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。