


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

让小产品的独立变现更简单 - ezindie.com
Y
Y Combinator Blog
Blog — PlanetScale
Blog — PlanetScale
H
Hackread – Cybersecurity News, Data Breaches, AI and More
WordPress大学
WordPress大学
B
Blog RSS Feed
A
About on SuperTechFans
V
Visual Studio Blog
J
Java Code Geeks
U
Unit 42
人人都是产品经理
人人都是产品经理
Martin Fowler
Martin Fowler
Recent Announcements
M
MIT News - Artificial intelligence
IT之家
IT之家
The Cloudflare Blog
T
The Blog of Author Tim Ferriss
C
Check Point Blog
博客园 - 叶小钗
P
Proofpoint News Feed
Microsoft Security Blog
B
Blog
S
SegmentFault 最新的问题
Microsoft Azure Blog

See you soon

让 JDTLS 能正确识别 Scala3 源码 | See you soon 哟,好久不见,无线打印 | See you soon 试试将文章版本化管理吧 | See you soon 使用 Quadlet 将 Podman 中的 Postgres 当作 systemd 服务运行 | See you soon 大他者,那个无时无刻都在盯着你的东西 | See you soon Laws of Software Engineering,软件工程定律 | See you soon 浅记多因素身份认证 | See you soon Linux 内核中的度量单位 | See you soon 重置 GPG 智能密钥 | See you soon 向 NAS 引入 samba | See you soon 无法重复键入的 Fcitx5 | See you soon ZFS 降级事故 | See you soon 记被 XanMod Kernel 和 AppArmor 联合坑的一次踩坑 | See you soon agent 的 skill 与 toolcall | See you soon 记一次服务器被挂恶意挖矿二进制 | See you soon 活着的 Arc | See you soon 令 acme.sh 使用 Cloudflare 的 DNS API 签发与续签证书 | See you soon 于 Tokio 中卸载 CPU Bound 任务 | See you soon 如我所见,梦破碎的时候 | See you soon 74LS 家族手册 | See you soon JDK Projects 备忘录 | See you soon 关于历史 | See you soon 用 curl 下载 OnePlus 的 ROM | See you soon 实用命令切片 | See you soon 再见,Oh My Zsh。 | See you soon 你不应该复用 strings.Builder | See you soon 博客的明日 | See you soon 被 AppArmor 击杀的 Dockge | See you soon AI 时代的自我 | See you soon 支持删除的布隆过滤器 | See you soon
编译器笔记:增量编译 | See you soon
Krysztal Huang · 2023-10-06 · via See you soon

编译器笔记:增量编译

如何让编译程序尽可能的快?并行化编译是最原始的做法——让每个单元都互相独立编译,并且尽可能多地同时编译。更进阶的做法就是——增量编译。

增量编译原理

增量编译的基础可以是并行化编译,也可以是串行编译。但是这只是过程,最重要的是能对每个文件进行单元化编译。

这是并行化编译的基础,从速度上考虑增量编译的单元应该是文件而不是文本内容,如果一个文件内容变化了一点但是需要大量的 differ 计算那我们不如直接从 0 开始编译。

如何实现一个简单的增量编译

我会用最简单的话来讲述实现增量编译的原理,甚至简单到不需要有太多编译相关的知识。

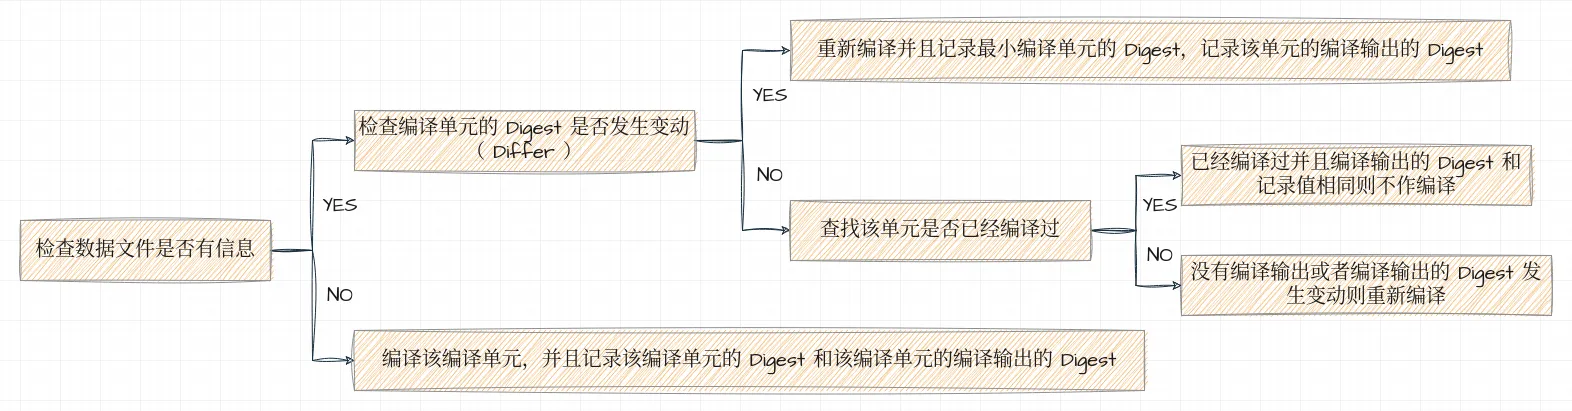
我们假定在 .caches 文件夹下有一个 compile.json 文件,用于记录上一次编译所产生的文件的信息:包含最小编译单元的 Digest(比如 MD5,SHA256),该单元输出的 Digest。

在编译文件时,先检查 compile.json 文件里是否有对应的信息:

  • 如果有的话
    • 检查编译单元的 Digest 是否发生变动( Differ )
      • 已经变动:重新编译并且记录最小编译单元的 Digest,记录该单元的编译输出的 Digest
      • 没有变动:查找该单元是否已经编译过
        • 已经编译过并且编译输出的 Digest 和记录值相同则不作编译
        • 没有编译输出或者编译输出的 Digest 发生变动则重新编译
  • 如果没有的话
    • 编译该编译单元,并且记录该编译单元的 Digest 和该编译单元的编译输出的 Digest

这样就是一个很简单的增量编译处理方式——输入没变就去找输出,输出变了就重新输出;输入变了那输出肯定和之前就不一样了。

这种处理方式有一个问题,那就是对于大项目来讲如果经历大重构会出现一大堆没办法被处理掉的之前的编译输出:因为这些编译输出已经是以前的文件的了,编译单元被重构后路径也发生了变化。

所以会有些文件不会被处理掉。

但我觉得问题不大,因为 cleanBuild 也是很必要的——而且各位的开发机也不缺这点储存。

用一个更直观的图来表达这个过程吧!
流程图