


HTTP是建立在TCP上面的,一次HTTP请求要经历TCP三次握手阶段,然后发送请求,得到相应,最后TCP断开连接。如果我们要发出多个HTTP请求,每次都这么搞,那每次要握手、请求、断开,就太浪费了,如果是HTTPS请求,就更加浪费了,每次HTTPS请求之前的连接多好几个包(不包括ACK的话会多4个)。所以如果我们在TCP或HTTP连接建立之后,可以传输、传输、传输,就能省很多资源。于是就有了“HTTP(S)连接池”的概念。和线程池非常像是不是。本文介绍连接池,连接池管理器,主要基于Python和 requests, urllib3 两个库。主要讲HTTP连接池,HTTPS连接池原理一样,只不过不光缓存TCP连接,还有发起请求之前对证书认证等过程。
HTTP连接池 urllib3.HTTPConnectionPool
首先需要明确的是,HTTP连接池缓存的是TCP连接,这个链接是相对于客户端和服务器的,说简单点,就是针对一个url(ip)目标的,所以连接池建立的时候要指定对哪一个主机缓存连接。比如发送给 domain.com/a 的请求和发送给 domain.com/b 的请求是可以使用一个TCP连接的,但是发送给 a-domain.com 的请求和 b-domain.com/b 的请求就不可能用一个连接完成的。
尝试使用一下:
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
from urllib3 import HTTPConnectionPool pool = HTTPConnectionPool('blog.csdn.net', maxsize=1) # ip: 47.95.47.253 def send_http(): for _ in range(5): r = pool.request('GET', '/a', redirect=False) print(r.status) print("Connections: {}; Requests: {}".format(pool.num_connections, pool.num_requests)) send_http() |
这里我们用一个连接池发送了5次请求,运行结果如下:
Python
|
1 2 3 4 5 6 7 8 9 10 11 |
$ python test_pool.py 307 Connections: 1; Requests: 1 307 Connections: 1; Requests: 2 307 Connections: 1; Requests: 3 307 Connections: 1; Requests: 4 307 Connections: 1; Requests: 5 |
同时,用Wireshark抓包,用 ip.src==47.95.47.253 or ip.dst==47.95.47.253 and (tcp.flags==0x12)过滤出来TCP握手的包,可以看到只抓到1个。证明我们5次请求只建立了一个TCP连接。
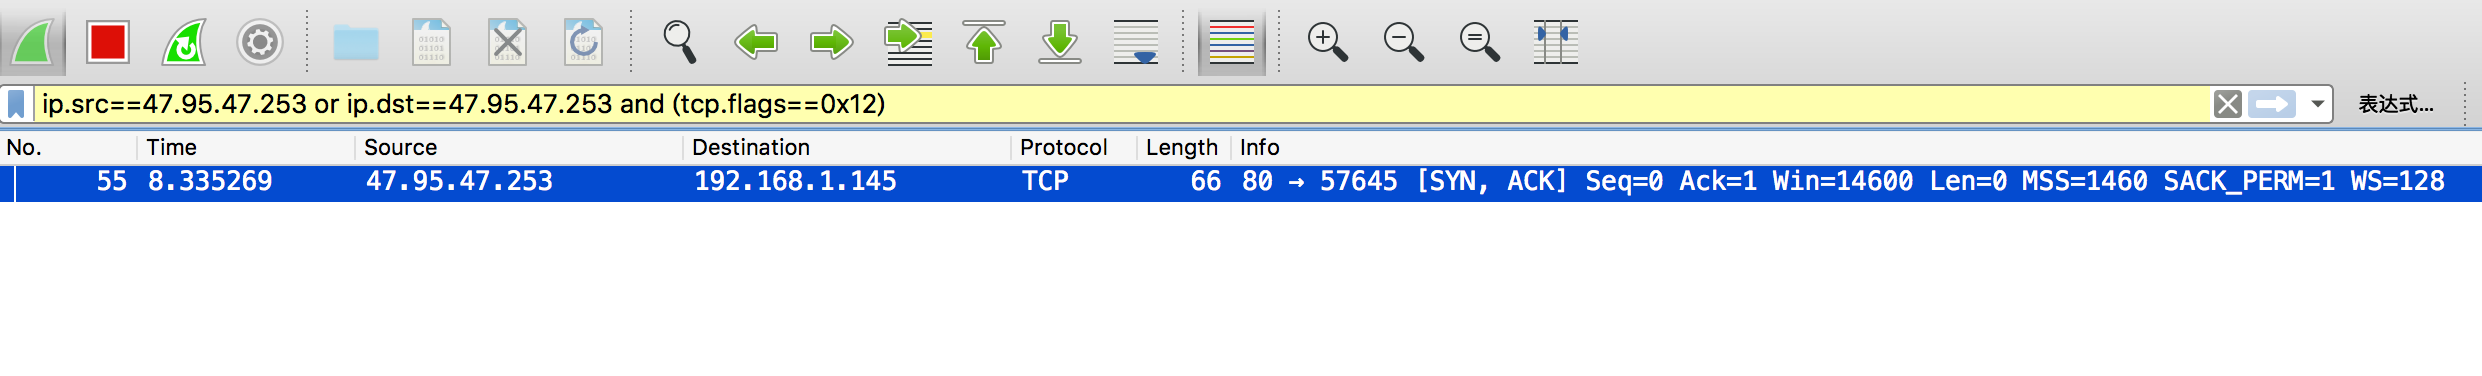
有个需要注意的参数是maxsize,这个参数指定了缓存连接的数量,默认是1.如果在多线程的情况下,可能两个线程用到了同一个pool,只有一个连接被缓存的话,另一个线程就需要新开一个连接。这时候会有两种情况:
- 如果
block参数是True,那么第二个线程被阻塞,直到这唯一一个可用的连接被释放。 - 如果
blcok参数是False(默认),那么第二个线程会新建一个连接,但是使用完成之后连接被销毁。连接池只会保存一个连接。
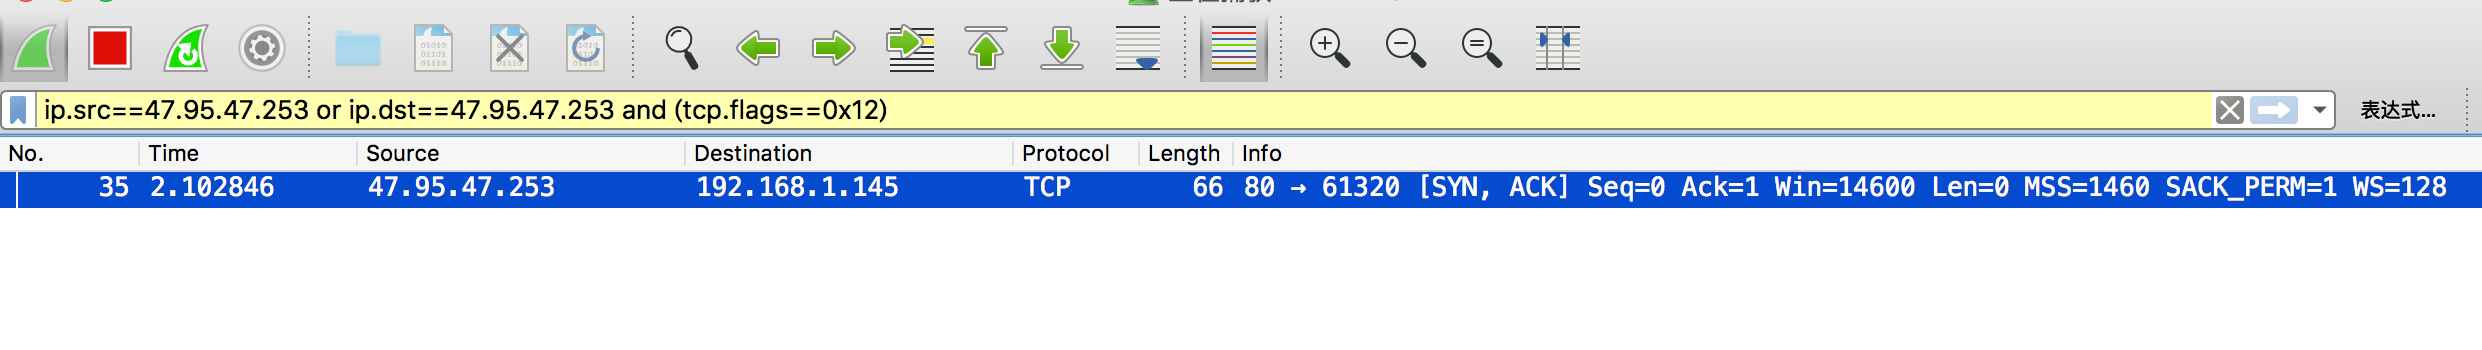
测试一下第一种情况,线程1和2同时发送请求,结束之后新的两个线程又发送请求。通过输出结果和Wireshark抓包发现自始至终只有1个TCP连接,没有新的建立。
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 |
import threading from urllib3 import HTTPConnectionPool pool = HTTPConnectionPool('blog.csdn.net', maxsize=1, block=True) # ip: 47.95.47.253 def send_http(): for _ in range(5): r = pool.request('GET', '/a', redirect=False) print(r.status) print("Connections: {}; Requests: {}".format(pool.num_connections, pool.num_requests)) t1 = threading.Thread(target=send_http) t2 = threading.Thread(target=send_http) t1.start() t2.start() import time time.sleep(2) t3 = threading.Thread(target=send_http) t4 = threading.Thread(target=send_http) t3.start() t4.start() |
输出结果,连接数始终是1:
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 |
$ python test_pool_threading.py 307 Connections: 1; Requests: 1 307 Connections: 1; Requests: 2 307 Connections: 1; Requests: 3 307 Connections: 1; Requests: 4 307 Connections: 1; Requests: 6 307 Connections: 1; Requests: 6 307 Connections: 1; Requests: 7 307 Connections: 1; Requests: 8 307 Connections: 1; Requests: 9 307 Connections: 1; Requests: 10 307 Connections: 1; Requests: 11 307 Connections: 1; Requests: 12 307 Connections: 1; Requests: 13 307 Connections: 1; Requests: 14 307 Connections: 1; Requests: 15 307 Connections: 1; Requests: 16 307 Connections: 1; Requests: 17 307 Connections: 1; Requests: 18 307 Connections: 1; Requests: 19 307 Connections: 1; Requests: 20 |
Wireshark抓包,只有1次连接:
再试一下第二种情况,下面的代码和上面的唯一的区别是block参数是False。
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 |
import threading from urllib3 import HTTPConnectionPool pool = HTTPConnectionPool('blog.csdn.net', maxsize=1, block=False) # ip: 47.95.47.253 def send_http(): for _ in range(5): r = pool.request('GET', '/a', redirect=False) print(r.status) print("Connections: {}; Requests: {}".format(pool.num_connections, pool.num_requests)) t1 = threading.Thread(target=send_http) t2 = threading.Thread(target=send_http) t1.start() t2.start() import time time.sleep(2) t3 = threading.Thread(target=send_http) t4 = threading.Thread(target=send_http) t3.start() t4.start() |
输出结果:
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 |
python test_pool_threading.py 307 Connections: 2; Requests: 2 307 Connections: 2; Requests: 3 307 Connections: 2; Requests: 4 307 Connections: 2; Requests: 5 307 Connections: 2; Requests: 6 307 Connections: 2; Requests: 7 307 Connections: 2; Requests: 8 307 Connections: 2; Requests: 9 307 Connections: 2; Requests: 10 307 Connections: 2; Requests: 10 307 Connections: 3; Requests: 12 307 Connections: 3; Requests: 13 307 Connections: 3; Requests: 14 307 Connections: 3; Requests: 15 307 Connections: 3; Requests: 16 307 Connections: 3; Requests: 17 307 Connections: 3; Requests: 18 307 Connections: 3; Requests: 19 307 Connections: 3; Requests: 20 307 Connections: 3; Requests: 20 |
Wireshark抓包,前两个线程会创建两个连接,一个连接使用之后被缓存,另一个使用之后就断开。在后面线程3和4的时候,一个线程会使用缓存的连接,另一个又会新开一个连接。所以一共有三次握手的包。
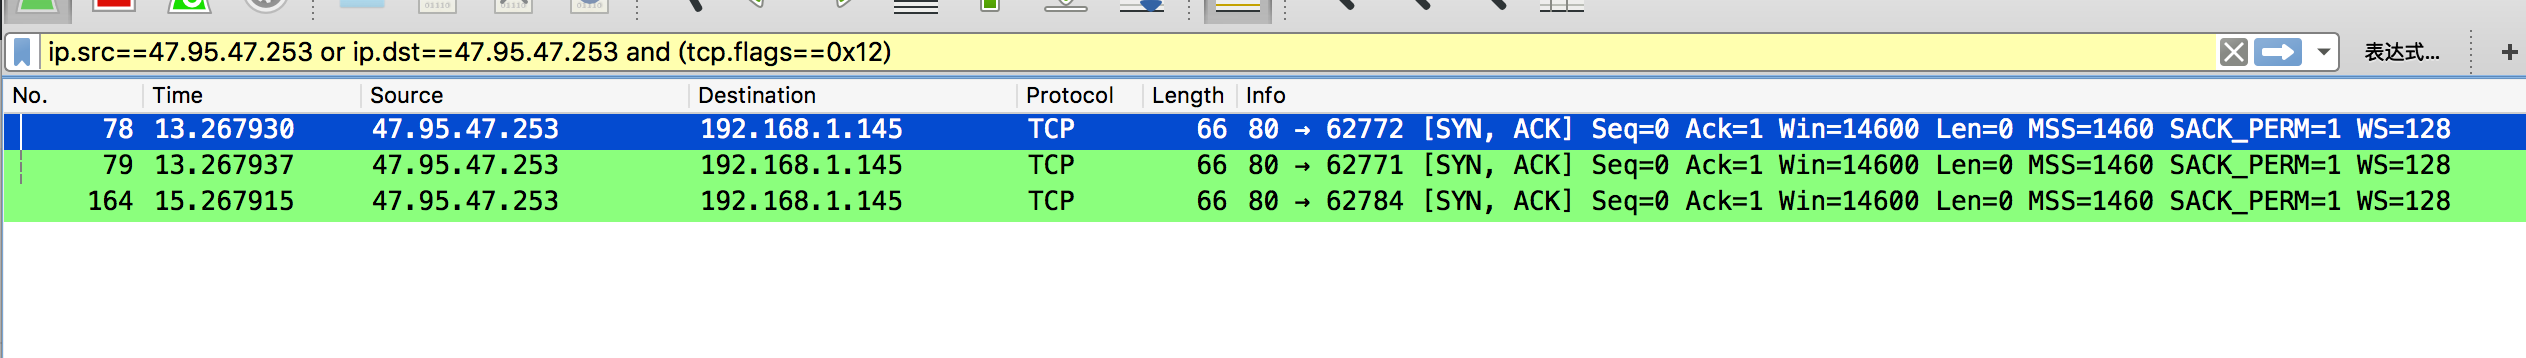
综上,在多线程的环境中,多缓存一些连接可能带来性能上的提升,一般连接数等于线程数,这样保证所有的线程都有缓存的连接可用。当然,也要结合实际的情况考虑timeout 和 block等参数。
连接池管理器 urllib3.PoolManager
上面介绍的连接池是面向对方主机管理的,如果我要向不同的域名发请求,希望缓存多个域名的连接,就要有多个连接池。好在urllib3将这一层也抽象了。
PoolManager做的事情并不多,基本上就是一个MRU原则(Least Recently Used )维护自己的Pool。比如初始化的大小设置为10,那么需要建立第11个连接池的时候,最最旧的一个连接池就被销毁。
Python
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
>>> from urllib3 import PoolManager >>> manager = PoolManager(10) >>> r = manager.request('GET', 'http://google.com/') >>> r.headers['server'] 'gws' >>> r = manager.request('GET', 'http://yahoo.com/') >>> r.headers['server'] 'YTS/1.20.0' >>> r = manager.request('POST', 'http://google.com/mail') >>> r = manager.request('HEAD', 'http://google.com/calendar') >>> len(manager.pools) 2 >>> conn = manager.connection_from_host('google.com') >>> conn.num_requests 3 |
它的函数原型是class urllib3.poolmanager.PoolManager(num_pools=10, **connection_pool_kw),只有一个参数num_pools表示池的数量,其余参数将会传给Pool初始化。
HTTP请求相当dirty,好在优秀的库requests帮我们搞定了各种复杂的情况。建议涉及HTTP操作的都是用requests这个封装好的库。
requests中有Adapter的概念,事实上,所有的请求都是通过默认的一个HTTPAdapter发出去的。如果我们想给一个域名加代理,都可以amount一个自定义的Adapter。
Python
|
1 2 3 4 |
import requests s = requests.Session() s.mount('https://', HTTPAdapter(pool_connections=1, pool_maxsize=2)) |
参数很明确,pool_connections会传到HTTPConnectionPool控制缓存连接的数量,pool_maxsize会传到PoolManager控制Pool的数量。
关于“连接池”和“连接池管理器”我有一个很困惑的地方, 为什么要分开这两个概念呢?这样的话要控制连接池连接的数量和连接池的数量,就要权衡我的应用是都连接向同一个网站的,还是连接向不同的网站的。然后根据线程权衡设置这两个数量。如果只有一个概念,连接池里面可以有各种域名的连接的缓存,我就可以直接考虑线程的数量来设置缓存连接的数量了。反正同一连接池的两个连接是两个连接,两个连接池的连接也是两个连接。如果去掉连接池管理器,直接将概念压扁成一层,那么对连接数量的管理就更方便了不是吗?可能urllib这么做也有它的原因吧,如果读者知道其中的原因或者我的想法的漏洞可以指点一下。