


在前面的文章中,我们曾提到最为常见的
监督学习任务是回归(预测价值)和分类(预测类别)。我们使用线性回归、决策树和随机森林等各种算法探讨了回归任务,即预测房屋价值。现在,我们将把注意力转向分类系统。
MNIST数据集
我们将使用 MNIST 数据集,这是一组由人类手写的 70,000 张小数字图像。每张图片都标注了所代表的数字。人们对这个数据集的研究非常深入,以至于它经常被称为机器学习的 “hello world”:每当人们提出一种新的分类算法时,他们都会好奇地想看看这种算法在 MNIST 上的表现如何,而且任何学习机器学习的人迟早都会用到这个数据集。
Scikit-Learn 提供了许多下载流行数据集的辅助函数。MNIST 就是其中之一。以下代码从 OpenML.org 获取 MNIST 数据集:
from sklearn.datasets import fetch_openml
mnist = fetch_openml('mnist_784', as_frame=False)
sklearn.datasets 包主要包含三种类型的函数:fetch_* 函数(如 fetch_openml())用于下载现实生活中的数据集;load_* 函数用于加载 Scikit-Learn捆绑的小型玩具数据集(因此无需通过互联网下载);make_* 函数用于生成假数据集,对测试非常有用。生成的数据集通常以 (X, y) 元组的形式返回,其中包含输入数据和目标数据,两者都是 NumPy 数组。其他数据集以 sklearn.utils.Bunch 对象的形式返回,这是一个字典,其条目也可以作为属性访问。它们通常包含以下条目:
“DESCR”
数据集描述
“data”
输入数据,通常为Numpy二维数组
“target”
标签,通常为Numpy一维数组
fetch_openml() 函数有点不寻常,因为默认情况下,它以 Pandas DataFrame 的形式返回输入,以 Pandas Series 的形式返回标签(除非数据集很稀疏)。但 MNIST 数据集包含图像,而 DataFrame 并不适合图像,因此最好设置 as_frame=False,以 NumPy 数组的形式获取数据。让我们来看看这些数组:
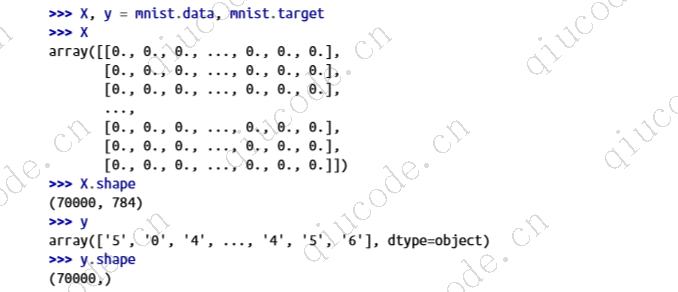
共有 70,000 幅图像,每幅图像有 784 个特征。这是因为每幅图像都是 28 × 28 像素,每个特征只代表一个像素的强度,从 0(白色)到 255(黑色)。让我们来看看数据集中的一个数字(图 3-1)。我们需要做的就是抓取一个实例的特征向量,将其重塑为 28 × 28 数组,然后使用 Matplotlib 的 imshow() 函数显示出来。我们使用 cmap="binary" 来获取灰度颜色图,其中 0 代表白色,255 代表黑色:
import matplotlib.pyplot as plt

def plot_digit(image_data):
    image = image_data.reshape(28, 28)
    plt.imshow(image, cmap="binary")
    plt.axis("off")

some_digit = X[0]
plot_digit(some_digit)
plt.show()

这看起来很像是数字 5,标签也是这么写的:
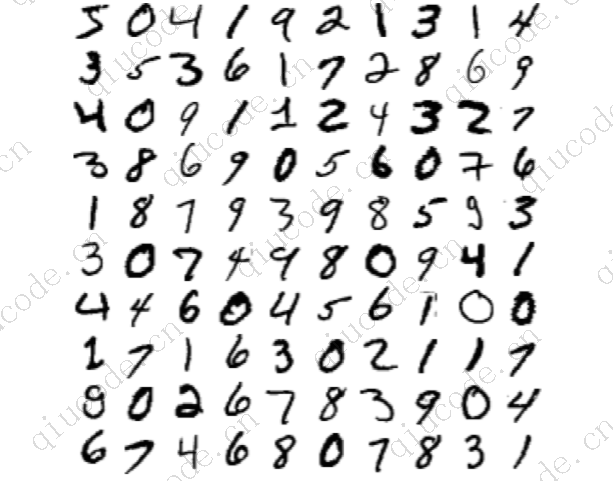
为了让您了解分类任务的复杂性,下图 展示了 MNIST 数据集中的几张图片。
但是,在仔细检查数据之前,您应该先创建一个测试集,并将其放在一边。由 fetch_openml() 返回的 MNIST 数据集实际上已经分为训练集(前 60,000 张图像)和测试集(后 10,000 张图像):
X_train, X_test, y_train, y_test = X[:60000], X[60000:], y[:60000], y[60000:]
我们已经对训练集进行了洗牌,因为这样可以保证所有交叉验证折叠都是相似的(我们不希望某个折叠缺少某些数字)。此外,有些学习算法对训练实例的顺序很敏感,如果连续获得很多相似的实例,它们的性能就会很差。对数据集进行洗牌可以确保这种情况不会发生
训练二进制分类器
现在让我们简化问题,只尝试识别一个数字–例如数字 5。这个 “5-检测器 “将是二进制分类器的一个例子,它只能区分 5 和非 5 这两个类别。首先,我们将为这项分类任务创建目标向量:
y_train_5 = (y_train == '5')  # True for all 5s, False for all other digits
y_test_5 = (y_test == '5')
现在,让我们选择一个分类器并对其进行训练。使用 Scikit-Learn 的 SGDClassifier类,从随机梯度下降(SGD,或随机 GD)分类器开始是个不错的选择。这种分类器能够高效处理超大数据集。部分原因是 SGD 一次只处理一个独立的训练实例,这也使得 SGD 非常适合在线学习,稍后你将看到这一点。让我们创建一个 SGDClassifier,并对整个训练集进行训练:
from sklearn.linear_model import SGDClassifier

sgd_clf = SGDClassifier(random_state=42)
sgd_clf.fit(X_train, y_train_5)
现在,我们可以用它来检测数字 5 的图像:
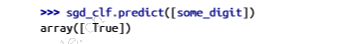
分类器猜测这张图片代表 5(True)。看来在这个特殊情况下它猜对了!期待下一篇对模型的性能评估的讲解。