


文章基于OpenAI官方公布的Sora技术文档,从模型能力、训练方式和技术原理三个角度出发,剖析Sora的出现对人工智能的发展,到底意味着什么?
见字如面,文章内容相较于视频内容会更加精简,如需了解更多细节的内容请观看视频,视频地址:https://www.bilibili.com/video/BV1Xx4y1y7Ga
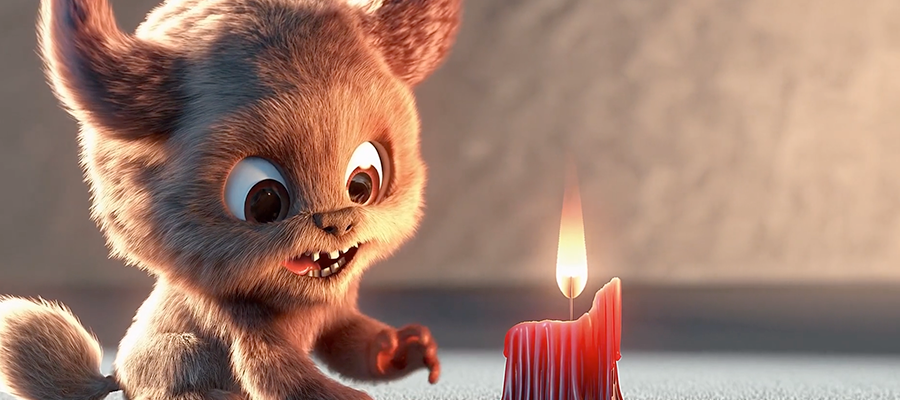
2024年2月16日凌晨(美国时间2月15日)OpenAI推出视频生成模型:Sora,一款文生视频(text-to-video)的模型。
Sora是通过学习视频内容,来理解现实世界的动态变化,并用计算机视觉技术模拟这些变化,从而创造出新的视觉内容。
我们来直观地感受一下什么是Sora?
这是一段提示词(Prompt):
A Chinese Lunar New Year celebration video with Chinese Dragon
翻译成中文:
与中国龙庆祝中国新年。
文生视频。现在文字有了,我们来看视频效果。
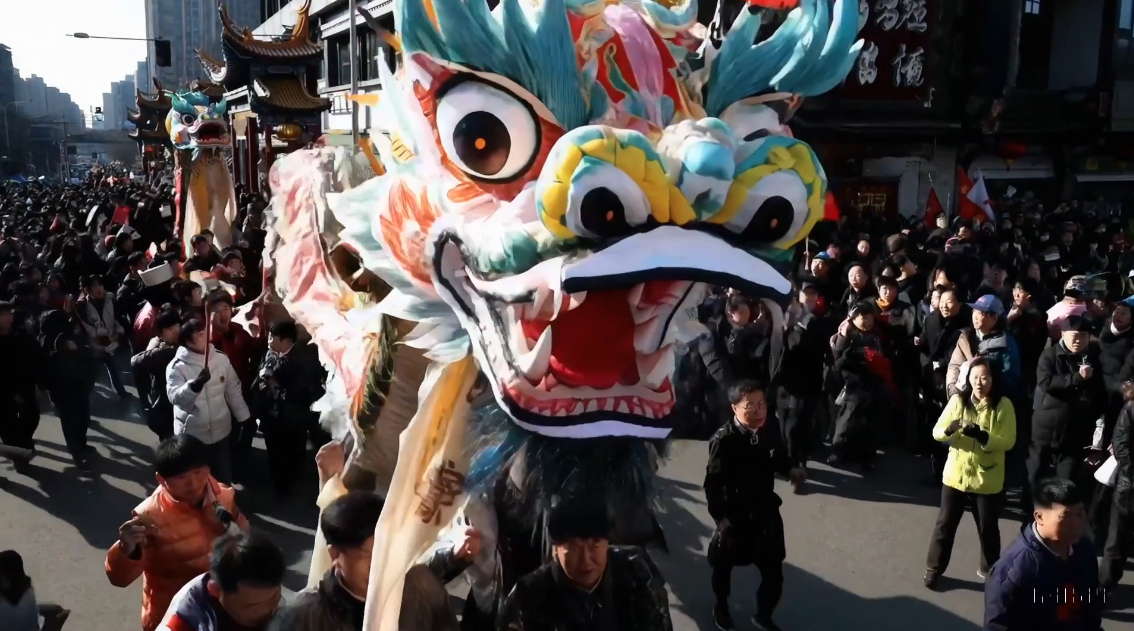
可以发现无论是舞龙的细节表现,还是人群跟着舞龙队伍的真实感,效果是如此的逼真。
当然Sora的能力还远不止如此,除了支持文字生成视频外,还支持文字+图片、文字+视频、视频+视频的方式创作新的视频内容。
Sora生成的视频内容,符合现实世界的物理规律。
这说明Sora学习的不仅仅是视频中的画面,还在学习视频中元素之间的关系,学习现实世界中的物理规律。
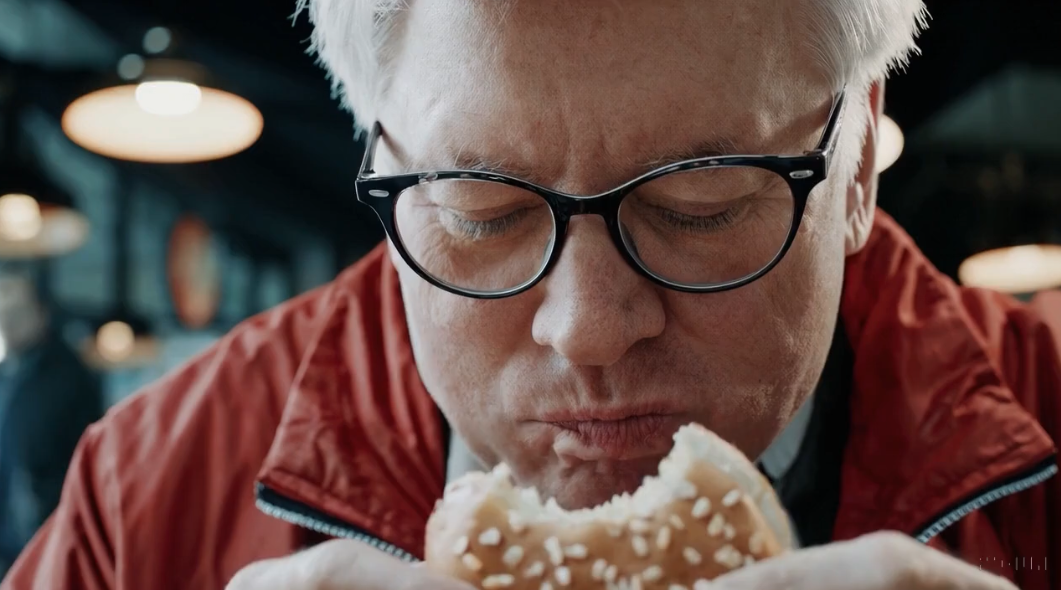
比如:一个人咬一口汉堡后,能够在汉堡上能够留下咬痕。
对于视频创作者而言,能够基于不同创作平台视频尺寸要求来生成视频内容。
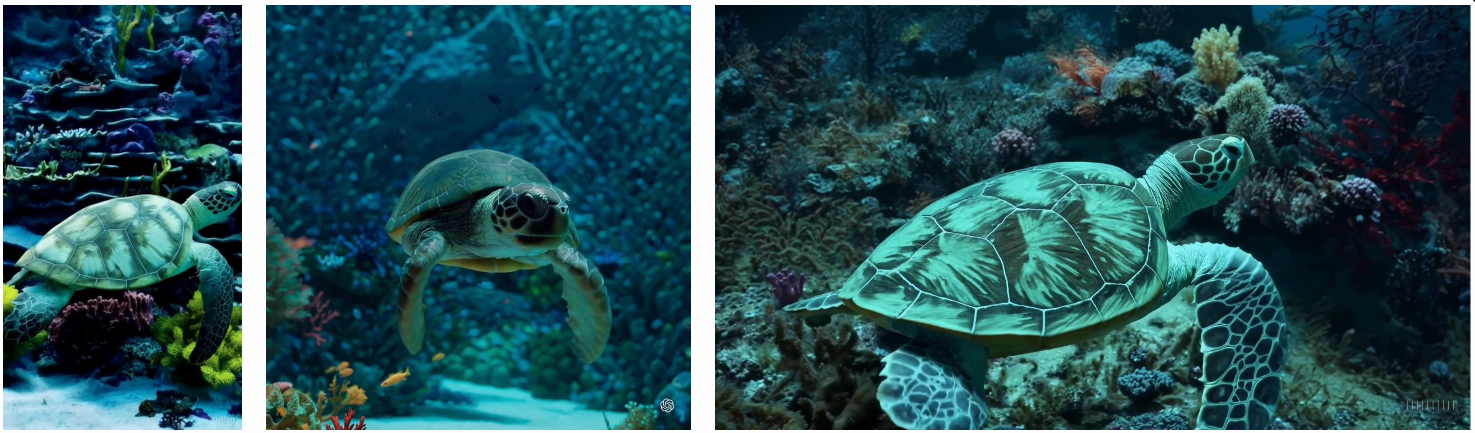
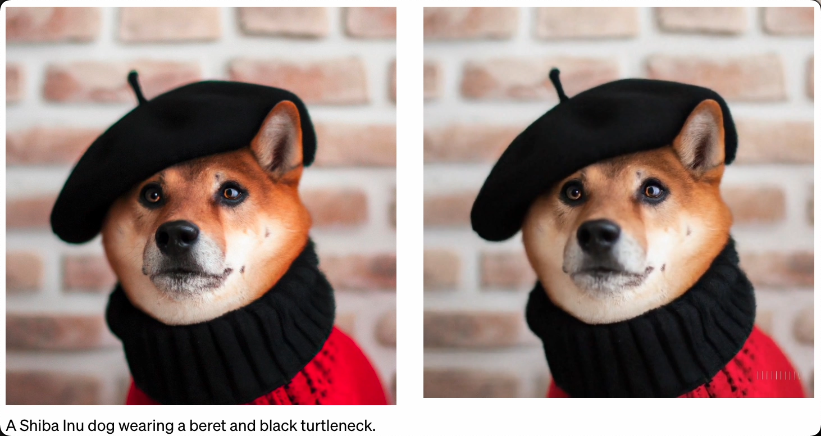
Sora支持在两个视频之间进行过渡处理,从而实现视频之间的无缝过渡。
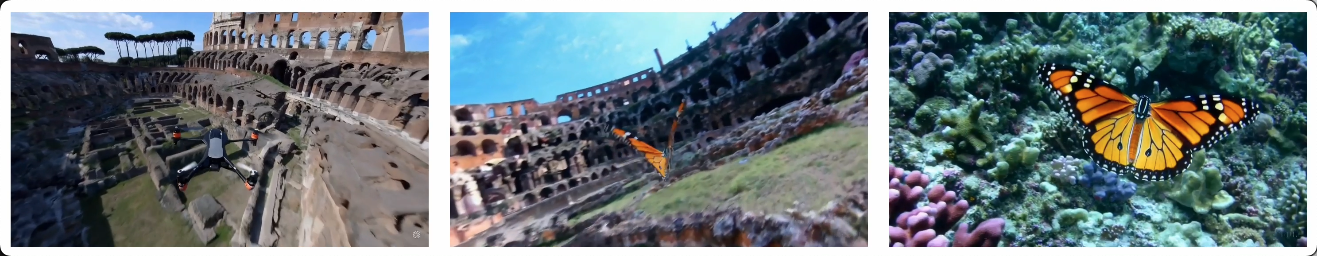
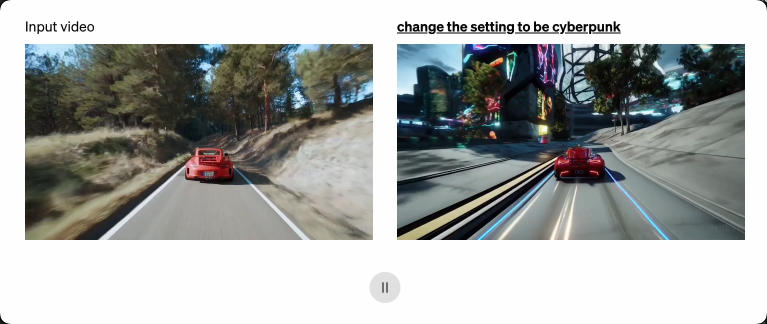
Sora能够基于文本提示,从而改变原视频的风格化和视频中的元素。
Sora能够在原视频的前后延长和拓展视频。
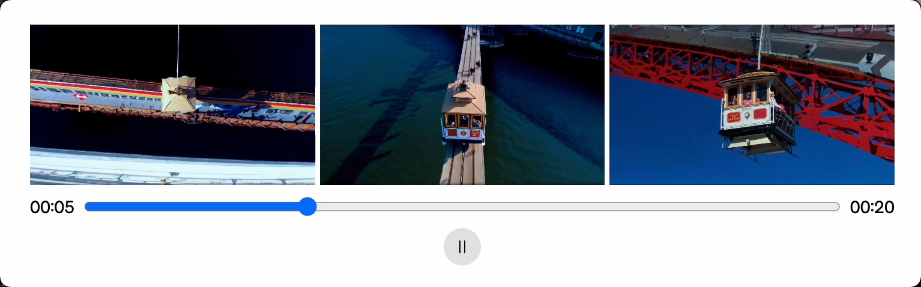
案例中三个视频,它们都是从生成的视频片段开始向前进行了视频的延伸。
因此,这三个视频的开头都不同,但结局都是相同的。
Sora可以生成带有动态摄像机运动的视频。随着摄像机的移动和旋转,人和场景元素在三维空间中一致移动。
在官方技术报告中,有一段这样的表述:
Sora is a generalist model of visual date
翻译成中文:
Sora是一个“通用模型”。
但要训练一个通用模型的前提条件之一:“大规模的训练数据”。
Sora是怎么训练的呢?
分为一下两步:所有数据皆为“我”所用、帮助AI更好的学习。
沿用ChatGPT之前大力出奇迹的训练方式:通过互联网的海量数据进行训练后,从而获得了通用的模型能力。
互联网中的庞大数据,之所以能被GPT进行训练,是因为在训练前进行了【数据标记处理】,英文被称之为Tokenization。
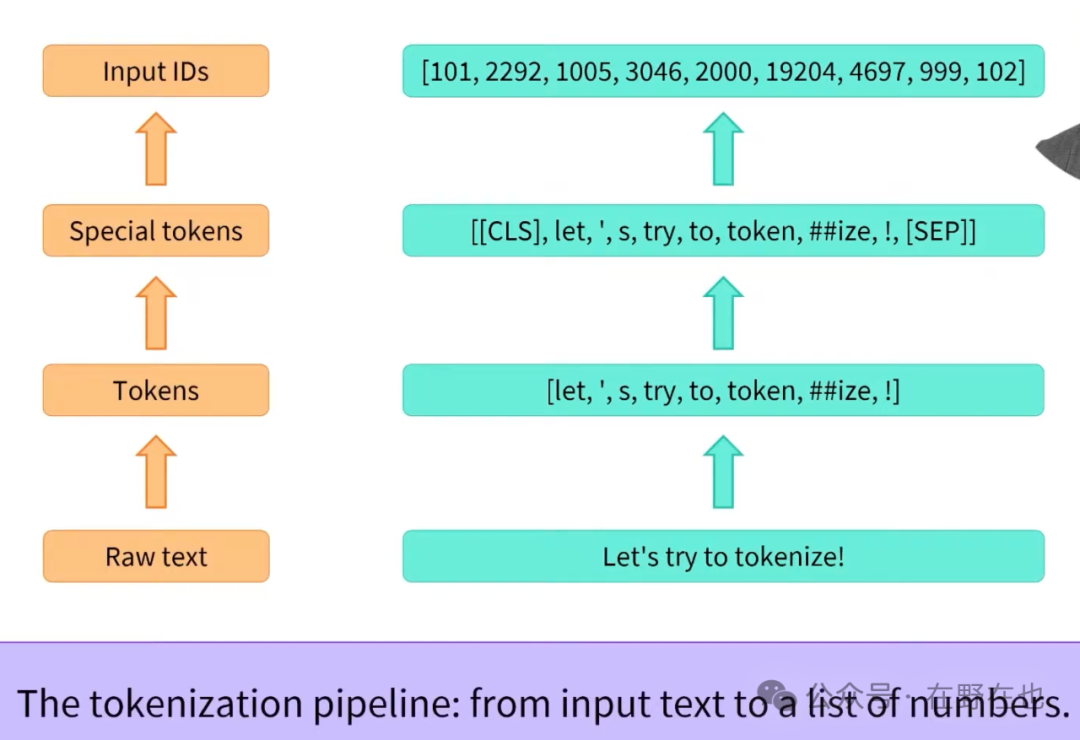
大白话说就是:将训练的文本内容转译为计算机能够理解的语言。
Sora沿用了GPT标记训练数据集的思路,对视频内容进行标记。视频标记被称作为visual patches,中文翻译过来叫做:视觉补丁,其核心的作用就是将视频内容,标记后,转译为计算机能够理解的语言。
那有了视频标记后,如何让标记的速度更快?标记的质量更高?
就引出了下面一项技术。
Sora在对数据集处理方式时沿用了DALL-E3的Re-Captioning技术。
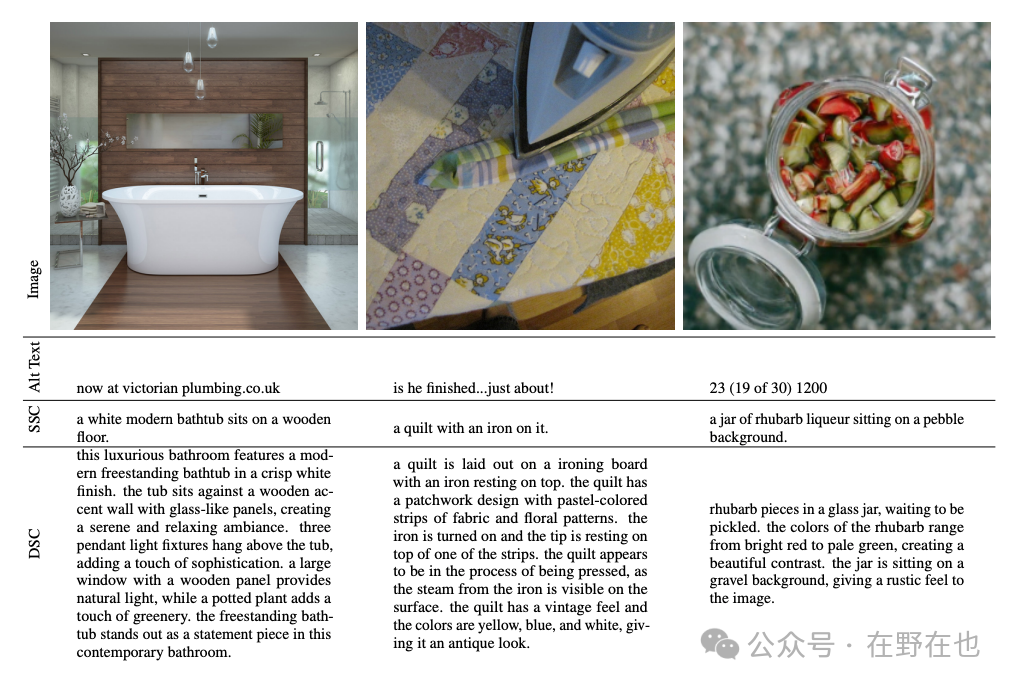
Re-Caption技术简单的来说是根据输入的图像生成对应的图像描述的文本内容。
这样做的好处:
AI学习到的不再是抽象的图像元素,并且1000个人有1000个哈姆雷特,通过图像+图像描述的方式,能够指引AI去人类图片的思路。
Sora运用该技术的具体的步骤是:
Sora目前运用的是Diffusion model(扩散模型)+ Transformer两种技术架构的结合。
这个技术路线和文生图的Stable diffusion的技术路线非常类似。
用一句话概括Sora扩散模型的实现过程:将原视频训练素材压缩后给Sora学习,学习如何将压缩后的视频内容还原和生成新的视频。
这里包含了两个关键步骤:Encoder-编码、Decoder-解码。
1)Encoder
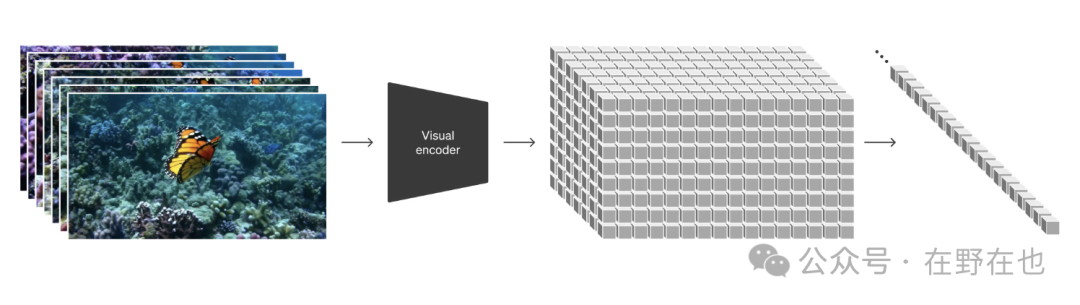
Encoder就是将原视频进行压缩,压缩至一个低维度的空间,压缩后视频充满了噪点,Sora就是学习压缩后的数据。
2)Decoder
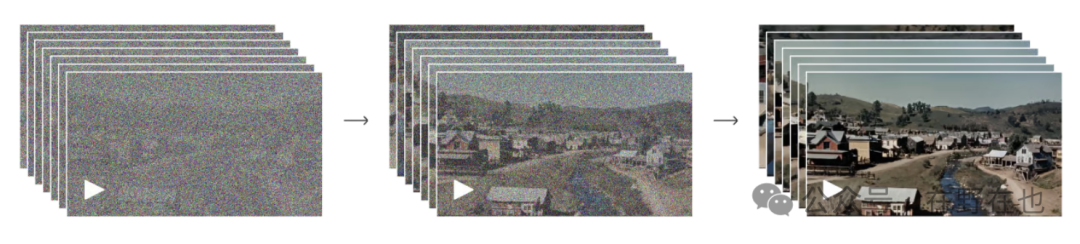
Decoder就是将压缩后的视频进行还原或创造,恢复至高清的像素空间。
那为什么Sora不直接拿原视频进行训练呢?
我们举个例子。
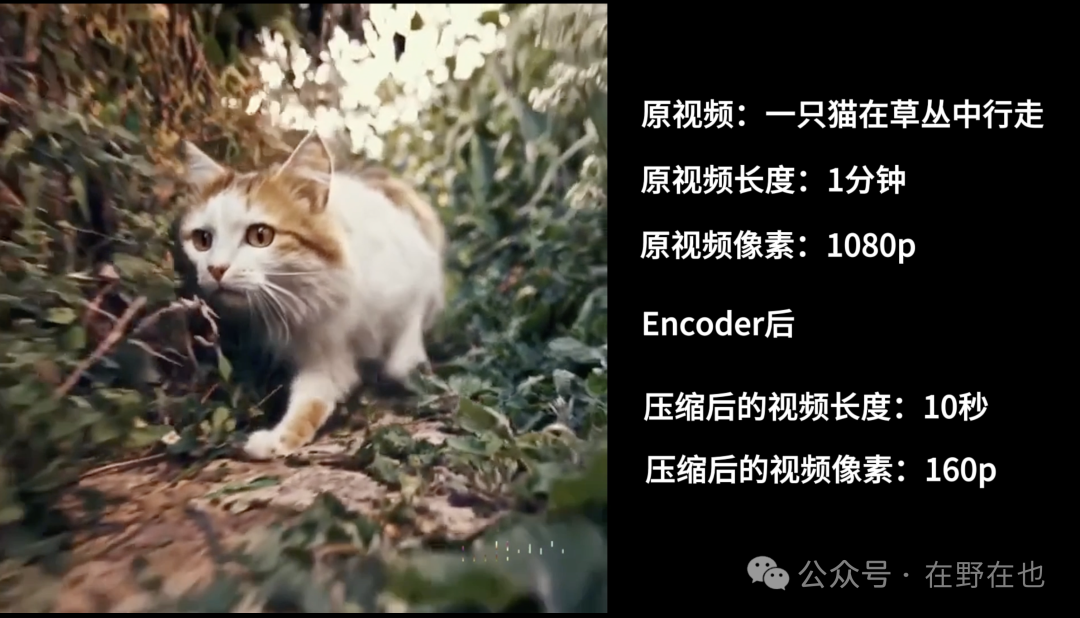
原视频进行Encoder编码后,整个视频的大小极具降低,所以训练的数据越小,消耗的算力资源越少,可训练的数据规模更大。
Sora 建立在过去对 DALL·E 、GPT、Diffusion model 研究之上的,所以技术的爆发并非偶然,而是多项技术共同作用的结果。
那Sora的出现对人工智能的发展,到底意味着什么?
Sora的官方技术文档中有两句话让我印象深刻:
We’re teaching AI to understand and simulate the physical world in motion, with the goal of training models that help people solve problems that require real-world interaction
翻译成中文:
我们正在教AI理解和模拟运动中的物理世界,目标是训练模型来帮助人们解决现实世界中的交互问题。
OpenAI最终想做的,其实不是一个“文生视频”的工具,而是一个通用的“物理世界模拟器”。
而Sora,只是验证了,这条道路可行的一个里程碑。
Sora的出现,短期来看,能够提高创作者、影视从业者的生产效率;长期来看,AI能够更佳全面的理解人类生活中现实世界,AGI通用人工智能正在加速到来。
见字如面,希望文章对你有所帮助~
声明:文章中的视频内容均出自Sora生成
来源自OpenAI官方技术报告
Sora官方技术报告地址:https://openai.com/research/video-generation-models-as-world-simulators
作者:在野在也,公众号:在野在也
本文由 @在野在也 原创发布于人人都是产品经理。未经作者许可,禁止转载。
题图来自 Sora 官网演示视频截图
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。