在人工智能领域,模型微调已成为提升模型性能、使其适应特定任务的关键技术。本文将全面系统地介绍模型微调的各个方面,帮助读者深入理解这一重要技术。
一、什么是模型微调
模型微调是指在已经训练好的预训练模型基础上,进行进一步的调整和优化,以使模型的输出更加符合特定的应用需求。从本质上讲,微调也是模型训练的一种形式,其过程与训练一个全新的模型有诸多相似之处。
谁来做微调
微调工作通常需要由具备丰富经验的研发人员或算法工程师来承担。这一过程不仅需要扎实的技术功底,还离不开两个核心要素:代码实现能力和充足的算力支持。值得一提的是,虽然目前有一些平台提供了可视化界面来辅助微调,但这些界面的功能往往较为有限,只能起到一定的辅助作用。
什么样的模型可以微调
并非所有模型都适合进行微调,以下两类模型是比较常见的微调对象:
- 大部分开源模型,例如 LLaMA、qwen、glm 等。这些模型具有开放的架构和参数,为用户进行个性化调整提供了便利。
- API 中开放微调接口的闭源模型或平台,如文心、智谱 AI 等。不过,开源模型和闭源模型在微调时存在明显差异:开源模型经过微调后可以生成新的模型;而闭源模型的微调过程则是在平台的服务器上进行,用户无法直接获取模型的原始参数。
影响微调的核心因素
微调的效果受到多个因素的综合影响,其中最为核心的包括:
- 基座模型的选择:基座模型的性能和特性在很大程度上决定了微调的上限。
- 微调方式的选择:不同的微调方法适用于不同的场景和需求。
- 数据质量:高质量的数据是确保微调成功的关键基础。
二、模型微调工作流程
第一步:需求分析与目标设定
这一阶段主要由项目组或产品经理主导,是微调工作的起点和关键。
什么情况下需要微调
在实际应用中,以下几种情况通常需要考虑对模型进行微调:
- 项目性质要求:例如甲方明确提出需求、出于资本化考虑或为了完成政绩工程等。此外,微调也是快速获得符合特定领域需求的大模型的常见手段,如矿山大模型、领域大模型等。
- 沟通方式和语言风格有特殊要求:当基座模型通过 prompt 控制无法稳定实现特定的沟通方式或语言风格时,如 AI 儿童讲故事场景。
- 基座模型缺少垂直领域数据:在医疗、军事等对专业知识要求较高的领域,由于互联网公开数据可能无法满足需求,导致基座模型无法完成专业任务。
- 基座模型无法完成特定任务:例如需要模型实现自动化操作电脑、手机等功能。
微调之前需要考虑的问题
在决定进行微调之前,需要全面评估以下几个方面:
- 是否已经充分尝试了 prompt(包括 few-shot、cot 等方式)和 RAG 技术?
- 是否能够保障微调所需的数据量级和数据质量?
- 由于基座模型会不断推出新版本,其能力也会不断提升,是否考虑过需要重新微调的情况?
核心工作步骤
1)明确业务需求和微调模型的目标:
- 仔细审视所选的基座模型在实际场景中的表现,判断是否真的需要微调。
- 检查是否已经尝试了各种 prompt 方法。
- 考虑是否对任务进行了合理拆解。
- 确认是否已经完善了 RAG 系统。需要注意的是,在大多数情况下,可能并不需要进行微调。
2)确定需要解决的具体问题。
3)设定预期的性能提升目标。
4)明确特定的业务指标或限制条件。
第二步:数据收集与准备
数据收集与准备工作主要由产品经理主导,这是微调工作的基础。
数据收集
根据具体的需求,从企业的数据库、日志文件、用户交互记录等多种来源收集相关数据。需要强调的是,在真实场景中收集真实数据至关重要,这将直接影响到微调的效果。
数据清洗
对收集到的数据进行清洗,去除其中的噪声、错误和不一致性,确保数据的质量。高质量的数据是模型能够有效学习的前提。
数据标注
如果采用监督学习方法进行微调,则需要对数据进行标注。这一步可能需要雇佣外部团队或利用内部资源来完成。准确的标注数据对于模型的训练和性能提升具有重要意义。
数据划分
将数据集划分为训练集、验证集和测试集,以便对模型的性能进行评估:
- 训练集:占比 70-80%,用于模型的实际训练和学习。
- 验证集:占比 10-15%,用于评估模型在训练过程中的表现,以便及时做出调整。
- 测试集:占比 10-15%,在模型训练完成后用于最终评估模型的性能。
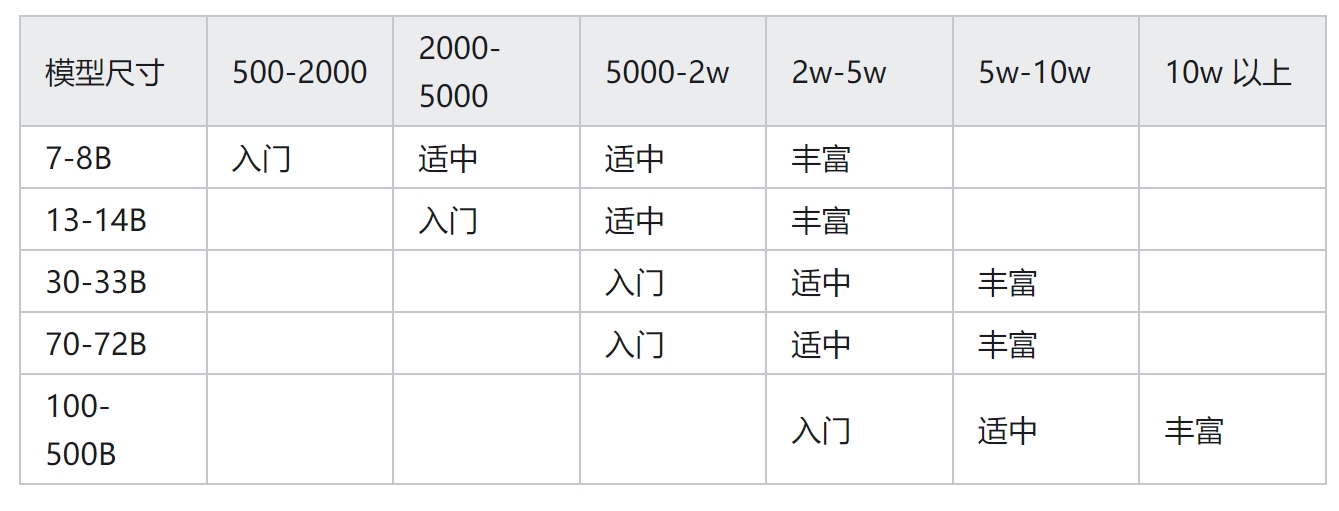
模型微调的数据量(LoRA 微调)
模型尺寸与微调数量级之间存在一定的大致关系,如下表所示:
数据质量标准
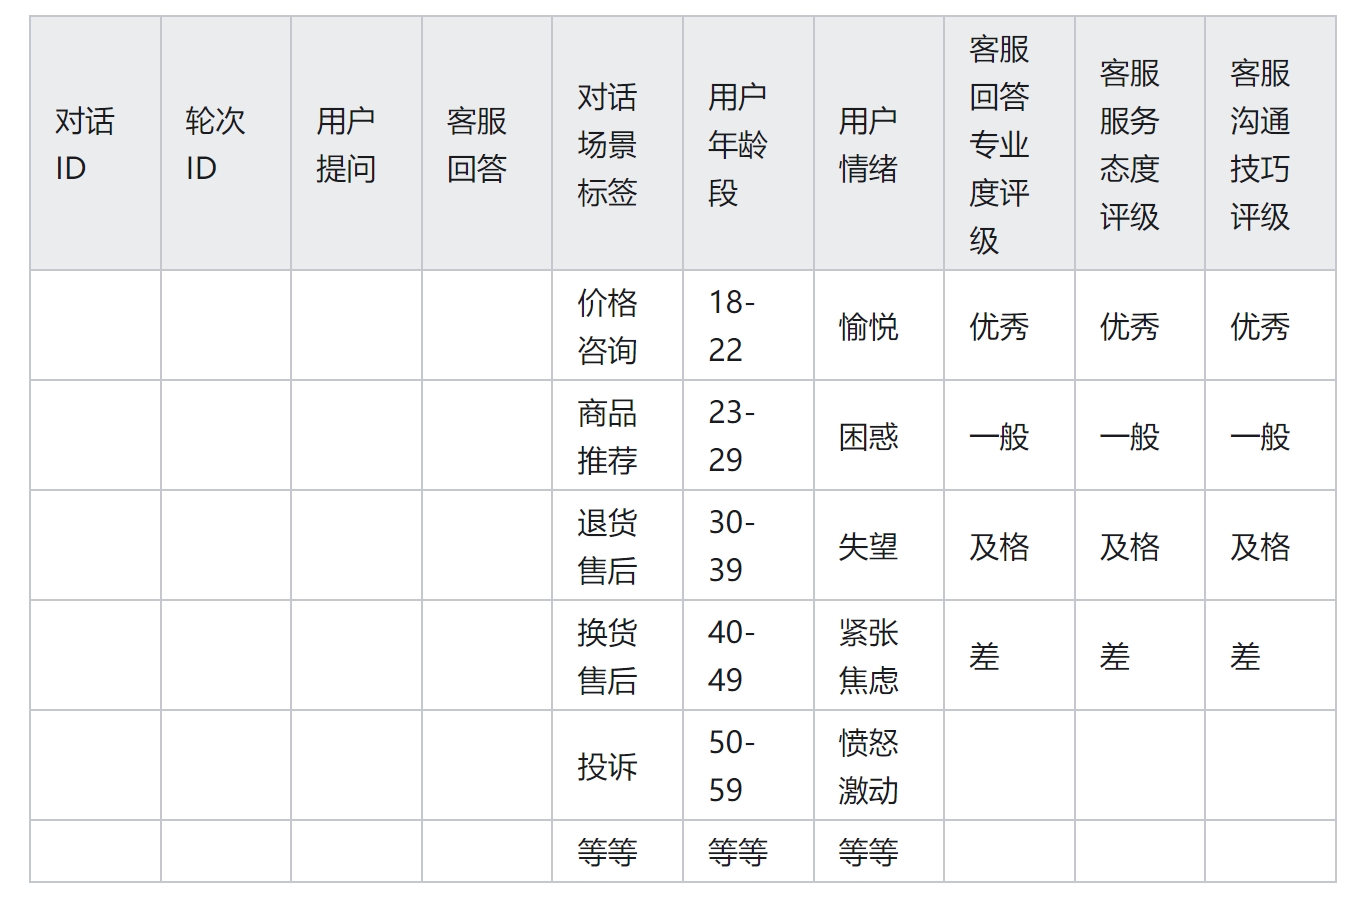
以智能客服系统的对话场景模型微调为例,数据质量标准可以包括以下多个维度:
第三步:模型选择
模型选择通常由算法主导,产品经理也应积极参与。
前提考虑
在选择模型之前,同样需要考虑以下几个问题:
- 是否已经充分尝试了 prompt(包括 few-shot、cot 等方式)和 RAG 技术?
- 是否能够保障微调所需的数据量级和数据质量?
- 由于基座模型会不断更新,是否考虑过需要重新微调的情况?
选择模型的原则和方法
- 开源和闭源的选择:原则上优先选择开源模型,但最终决策需要根据具体的业务场景来确定。
- 基座模型公司的选择:例如智谱 AI 的 glm 系列模型,其中 glm4 的最强模型不开源,而阿里系的 qwen 模型是一个值得推荐的选择。
- 模型尺寸的选择:需要从效果和成本两个方面综合考虑,在项目中,可能需要根据不同的场景选择不同尺寸的模型。一般来说,可以先尝试最大尺寸的模型以获取最佳效果,然后再根据实际需求降到最小可行尺寸。
基于场景的模型选择
在实际项目中,模型的选择需要综合考虑效果和成本。一个项目可能包含多个场景,因此可能需要选择不同的模型。通常需要通过实验和经验来确定最佳的模型选择和微调方式,例如:
- 对于一些复杂任务,可能需要采用 33b + 的模型进行全量微调。
- 而对于另一些任务,可能采用 110 + 的模型并冻结部分参数进行微调更为合适。
第四步:模型微调
模型微调由算法工程师实施,是整个工作流程的核心环节。
模型微调方式(本质上是 SFT)
1)全模型微调:对整个模型的所有参数进行调整。
2)轻量化微调(Parameter-Efficient Fine-tuning,PEFT):
- 低秩适应微调(Low-Rank Adaptation,LoRA):这是最常用的微调技术之一。
- prompt tuning。
- P-Tuning。
- Prefix-Tuning。
3)冻结部分参数微调:只对模型的部分参数进行调整,其余参数保持冻结。
4)渐进微调:逐步调整模型的参数,以提高微调的效果和稳定性。
5)多任务微调:同时对多个任务进行微调,以提高模型的泛化能力。
LoRA 微调原理
LoRA 微调的核心原理是只选择原始模型的部分参数作为目标微调参数(通常 r 取 4、8、16、32 等),不更改模型的原始参数,而是在原始参数的基础上增加一个偏移量,从而得到一套新的参数。这种方法具有高效、节省算力等优点,因此在实际应用中最为常用。
QLoRA 微调
QLoRA 微调的主要目的是解决显存占用量过大的问题。显存占用量的计算方法如下:参数量 ×4×4 倍(装进来 + 转起来)/(1024×1024×1024)=xG 显存。以 7B 模型为例,其参数量为 7000000000,计算可得显存占用约为 11200000000 字节,即约 104G,这需要 5 张 NVIDIA 4090 显卡(每张 24G)。QLoRA 通过将 4 个字节的浮点数改成 1 个字节的整数,直接将显存占用降低到原来的四分之一,大大提高了模型微调的可行性。
第五步:模型评估
模型评估由产品经理主导,是确保模型满足预期需求的关键环节。
评估手段:支持率
在特定场景下评估微调后的模型能力,支持率是一个重要的指标。通用领域的评估往往没有实际意义。具体评估方法如下:
1)设计问答任务,使用微调前和微调后的模型分别回答问题,然后由人工在不知道回答来源的情况下进行偏好选择。
2)评估标准:
- 如果微调后的模型支持率低于 50%,说明这次微调不仅没有提升模型能力,反而破坏了原有模型的能力。
- 如果支持率在 50% 左右,说明微调几乎没有取得进步。
- 如果支持率在 50%-70% 之间,微调的成果不够理想。
- 如果支持率在 70%-80% 之间,说明这次微调是成功的。
- 如果支持率超过 80%,表明在大多数场景下,这次微调都取得了显著的提升。
第六步:模型部署
一旦模型通过评估,就可以由研发人员将其部署到生产环境中,使其能够为实际业务提供服务。
第七步:监控与维护
模型部署到生产环境后,需要由产品经理负责进行监控与维护:
- 性能监控:定期检查模型的性能,确保其持续满足业务需求。
- 更新与再训练:随着新数据的获取或业务环境的变化,可能需要对模型进行再次训练或微调,以适应新的情况。
第八步:反馈循环
产品经理需要设计反馈和监督机制,建立一个有效的反馈循环:收集模型使用过程中的反馈信息,用于指导未来的改进和优化工作,使模型能够不断进化和完善。
三、数据工程
需要明确的是,微调不是一次性工程,持续的数据收集和体系化的数据处理比微调技术本身更为重要。
如何收集偏好数据(相当于人工标注)
- 点赞点踩:通过用户对模型输出的点赞或点踩行为来收集偏好数据。
- 多选项选择:例如一次性给用户展示 4 张图,让用户选择偏好的选项;或者让模型生成两个答案,让用户进行选择。
- 客服工作台辅助:在客服工作台中,模型生成 4 个辅助回复,其中 2 个来自原模型,2 个来自微调后的模型,让客服选择一个最合适的回复,从而收集偏好数据。
产品功能设计
- 数据收集能力:在产品功能设计上,一定要具备数据收集能力,以便及时获取用户反馈和偏好数据。
- 定向数据收集:针对特定场景,在产品功能上设计定向数据收集的机制,提高数据的针对性和有效性。
设计好数据管理平台
- 利用 LLM 能力:让数据管理平台具备一定的智能,提高数据管理的效率和质量。
- 参考案例:如百度智能云的数据管理和数据标注平台。
数据管理平台产品框架
- 数据来源管理:管理自有数据、公开数据、用户生成数据、专家撰写的数据、模型合成数据、众包收集数据等多种数据来源,并实现在线系统数据的直接导入和数据平台与在线系统的实时对接。
- 体系化标注:包括标签定义、标签层次构建、打标任务管理和打标任务分层等,支持用户打标、服务人员打标、专家打标、AI 打标、交叉打标、交叉复检和专家抽检等多种标注方式。
- 数据去重与增强:通过 prompt 的相似度计算、数据来源整体质量分级等方法进行数据去重,同时采用同义词替换、词序打乱、反向翻译、数据混合等技术进行数据增强。例如,将 200 条问答数据通过模型生成相同的提问,可扩展为 400 条数据;将数据翻译成其他语言再翻译回原语言,可实现表达方法的多样性。
- 数据打包:实现训练集、验证集和测试集的自动化划分,建立数据集与模型版本、模型评估结果的关联,并按标签评估数据的可用性和复用性。
- 模型评估:支持偏好打标、专家打分、用户偏好收集等评估方式,并按标签产出评估结果,实现评估与打标数据的复用。
- 多利用能力强大的模型辅助工作:例如利用强大的模型进行数据过滤、自动打标、交叉复检、prompt 的相似度计算、response 质量对比、数据增强和模型评估等工作,提高数据工程的效率和质量。
四、后记
原则
- 如果没有高质量的数据,微调实操的意义不大。数据质量是决定微调效果的关键因素,即使采用最先进的微调技术,若没有高质量的数据支撑,也难以取得理想的效果。
- 不强调数据量的大小,但是数据质量一定要高。在数据工程中,应更加注重数据的质量而非数量,高质量的数据能够使模型更加有效地学习到所需的知识和模式。
通过以上对模型微调的全面介绍,相信读者已经对模型微调有了深入的理解。在实际应用中,需要根据具体的业务需求和场景,合理选择微调方法和数据处理方式,以实现模型性能的有效提升。
本文由 @李雨田 原创发布于人人都是产品经理。未经作者许可,禁止转载。
题图来自Unsplash,基于CC0协议。
该文观点仅代表作者本人,人人都是产品经理平台仅提供信息存储空间服务。



