惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

V
Visual Studio Blog
量子位
大猫的无限游戏
大猫的无限游戏
Hugging Face - Blog
Hugging Face - Blog
S
SegmentFault 最新的问题
Blog — PlanetScale
Blog — PlanetScale
月光博客
月光博客
Google DeepMind News
小众软件
小众软件
WordPress大学
WordPress大学
宝玉的分享
宝玉的分享
MongoDB | Blog
MongoDB | Blog
B
Blog RSS Feed
博客园 - Franky
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
B
Blog
博客园 - 聂微东
The GitHub Blog
The GitHub Blog
Recent Announcements
Y
Y Combinator Blog
Microsoft Security Blog
雷峰网
雷峰网
Jina AI
Jina AI
酷 壳 – CoolShell
酷 壳 – CoolShell

陈少文的网站

巨变与机遇的未来十年 Kubernetes 平台管理软件压力测试方案 使用镜像部署 Hexo 静态页面 终于等到你 - GitHub 镜像仓库服务(ghcr.io) 一起来学 Go --(6)Interface 一起来学 Go --(5)Goroutine 和 Channel 什么是函数式编程 如何在 Kubernetes 集群集成 Kata 柯里化与偏函数 使用 PyGithub 自动创建 Label 软件产品是团队能力的输出 Helm 2 、Helm 3 比较 IoT 变现 Kubernetes 中的 DNS 服务 国内的 Helm 镜像源 Harbor 使用自签证书支持 Https 访问 DevOps 工具链之 Prow 如何使用 kfctl 安装 Kubeflow VS Code 无法下载 Go 插件的工具包 工程师更应具有服务精神 你不知道的 Docker 使用技巧 使用 Docker 运行 Tensorflow 论中国 什么是左移 如何清空 Git 仓库全部历史记录 一禅小和尚 有风吹过厨房 时间的玫瑰 如何在 CentOS 安装 GPU 驱动 开发 Tips(19)
Python2 源码学习之字典和列表实现
微信公众号 · 2018-03-12 · via 陈少文的网站

1. 为什么字典比列表查询快

首先,请看下面这段代码

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
from time import time

t = time()
data = [chr(i) for i in range(97, 123)]
# data = dict.fromkeys(data,True)
print data
for i in range(9999999):
    after_filter = []
    for find in ['aa', 'b', 'cc', 'd', 'ee']:
        if find not in data:
            after_filter.append(find)
print after_filter
print time() - t

直接运行:

['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j', 'k', 'l', 'm', 'n', 'o', 'p', 'q', 'r', 's', 't', 'u', 'v', 'w', 'x', 'y', 'z']
['aa', 'cc', 'ee']
24.5699999332

去掉注释 data = dict.fromkeys(data,True) 后:

{'a': True, 'c': True, 'b': True, 'e': True, 'd': True, 'g': True, 'f': True, 'i': True, 'h': True, 'k': True, 'j': True, 'm': True, 'l': True, 'o': True, 'n': True, 'q': True, 'p': True, 's': True, 'r': True, 'u': True, 't': True, 'w': True, 'v': True, 'y': True, 'x': True, 'z': True}
['aa', 'cc', 'ee']
17.8080000877

反复测试多次,结果不会偏差超过 1 秒。为什么将列表通过 dict.fromkeys 函数转换为字典之后,运行速度会明显加快呢?

Python 字典中使用了 hash table,因此查找操作的复杂度为 O(1),而 list 实际是个数组,在 list 中,查找需要遍历整个 list,其复杂度为 O(n),因此对成员的查找访问等操作字典要比 list 更快。下面,我们一起来看下 Python 源码中列表和字典结构是如何实现的?

2. Python 源码中的常见对象

Python 中的对象都继承自 PyObject 或 PyVarObject。继承自 PyObject 的对象长度固定,比如 int 等。继承自 PyVarObject 的对象长度可变,比如 list、dict等。而 PyObject 和 PyVarObject 拥有相同的头部 PyObject_HEAD。

  • PyObject_HEAD

定义于 include/object.h 中

1
2
3
4
#define PyObject_HEAD                   \
    _PyObject_HEAD_EXTRA                \
    Py_ssize_t ob_refcnt;               \
    struct _typeobject *ob_type;

_PyObject_HEAD_EXTRA 是双向链表结构,用于垃圾回收。ob_refcnt 是对象的引用计数,当没有被引用时,自动回收内存。ob_type 是指向类型对象的指针,决定了对象的类型。

  • PyObject

定义于 include/object.h 中

1
2
3
typedef struct _object {
    PyObject_HEAD
} PyObject;
  • PyVarObject

定义于 include/object.h 中

1
2
3
4
5
6
7
#define PyObject_VAR_HEAD               \
    PyObject_HEAD                       \
    Py_ssize_t ob_size; // 可变部分的元素数量

typedef struct {
    PyObject_VAR_HEAD
} PyVarObject;

PyVarObject 包含一组对象,数量由 ob_size 指定。

3. Python 中列表的实现

  • 定义

include/listobject.h

1
2
3
4
5
6
7
#define PyList_MAXFREELIST 80

typedef struct {
    PyObject_VAR_HEAD   // 表示变长对象,其中的 ob_size 表示实际使用的内存大小
    PyObject **ob_item; // 列表元素所在内存块的首地址
    Py_ssize_t allocated; // 列表总共分配的内存数量
} PyListObject;
  • 内置函数

Objects/listobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
static PyMethodDef list_methods[] = {
    {"__getitem__", (PyCFunction)list_subscript, METH_O|METH_COEXIST, getitem_doc},
    {"__reversed__",(PyCFunction)list_reversed, METH_NOARGS, reversed_doc},
    {"__sizeof__",  (PyCFunction)list_sizeof, METH_NOARGS, sizeof_doc},
    {"append",          (PyCFunction)listappend,  METH_O, append_doc},
    {"insert",          (PyCFunction)listinsert,  METH_VARARGS, insert_doc},
    {"extend",          (PyCFunction)listextend,  METH_O, extend_doc},
    {"pop",             (PyCFunction)listpop,     METH_VARARGS, pop_doc},
    {"remove",          (PyCFunction)listremove,  METH_O, remove_doc},
    {"index",           (PyCFunction)listindex,   METH_VARARGS, index_doc},
    {"count",           (PyCFunction)listcount,   METH_O, count_doc},
    {"reverse",         (PyCFunction)listreverse, METH_NOARGS, reverse_doc},
    {"sort",            (PyCFunction)listsort,    METH_VARARGS | METH_KEYWORDS, sort_doc},
    {NULL,              NULL}           /* sentinel */
};

在定义列表的文件中,定义了 Python 中 list 内置方法对应的 C 函数。下面简单看下这些函数的实现逻辑。

  • 初始化

Objects/listobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
PyList_New(Py_ssize_t size)
{
    ...
    // 如果缓冲池非空, 从缓冲池取
    if (numfree) {
        numfree--;
        op = free_list[numfree];
        _Py_NewReference((PyObject *)op);
        ...
    } else {
        // 否则, 申请新的内存空间
        op = PyObject_GC_New(PyListObject, &PyList_Type);
        ...
    }
    if (size <= 0)
        op->ob_item = NULL;
    else {
        ...
        // 初始化
        memset(op->ob_item, 0, nbytes);
    }
    ...
}
  • append

调用逻辑:listappend -> app1 ->list_resize +1 后,PyList_SET_ITEM

include/listobject.h

1
#define PyList_SET_ITEM(op, i, v) (((PyListObject *)(op))->ob_item[i] = (v))

Objects/listobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
static int
list_resize(PyListObject *self, Py_ssize_t newsize)
{
    PyObject **items;
    size_t new_allocated;
    Py_ssize_t allocated = self->allocated;

    // 如果内存大小够用,并且新内存大小超过之前的一半,则需要分配新内存
    if (allocated >= newsize && newsize >= (allocated >> 1)) {
        assert(self->ob_item != NULL || newsize == 0);
        Py_SIZE(self) = newsize;
        return 0;
    }
    //否则分配新的内存空间
    new_allocated = (newsize >> 3) + (newsize < 9 ? 3 : 6);
    ...
}

list_resize() 会多申请一些空间以避免频繁地内存操作,增长趋势是:0,4, 8,16,25,35,46,58,72,88, …实际上在分配内存是调用的是 C 语言的 realloc 方法。

  • insert

调用逻辑:listinsert-> ins1->list_resize +1 ,移动元素后插入新数据。

Objects/listobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
static int
ins1(PyListObject *self, Py_ssize_t where, PyObject *v)
{
    ...
    if (list_resize(self, n+1) == -1)
        return -1;

    // 如果插入位置为负数,则加上列表长度一次,如果依然为负数,则插在首位
    if (where < 0) {
        where += n;
        if (where < 0)
            where = 0;
    }
    // 如果插入位置超过列表长度,则插在列表末尾处
    if (where > n)
        where = n;
    items = self->ob_item;
    // 向后移动元素,再插入新的数据
    for (i = n; --i >= where; )
        items[i+1] = items[i];
    Py_INCREF(v);
    items[where] = v;
    return 0;
}

其他方法这里就不一一列举了。

4. Python 中字典的实现

Python 中的字典是通过哈希表实现的。哈希表是一个数组,它的索引是对键运用哈希函数求得的,采用开放地址法解决冲突问题。

  • 定义

Include/dictobject.h

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
typedef struct {
    Py_ssize_t me_hash; //用于缓存 me_key 的哈希值,避免每次查询都需要计算 hash
    PyObject *me_key;
    PyObject *me_value;
} PyDictEntry;

typedef struct _dictobject PyDictObject;
struct _dictobject {
    PyObject_HEAD
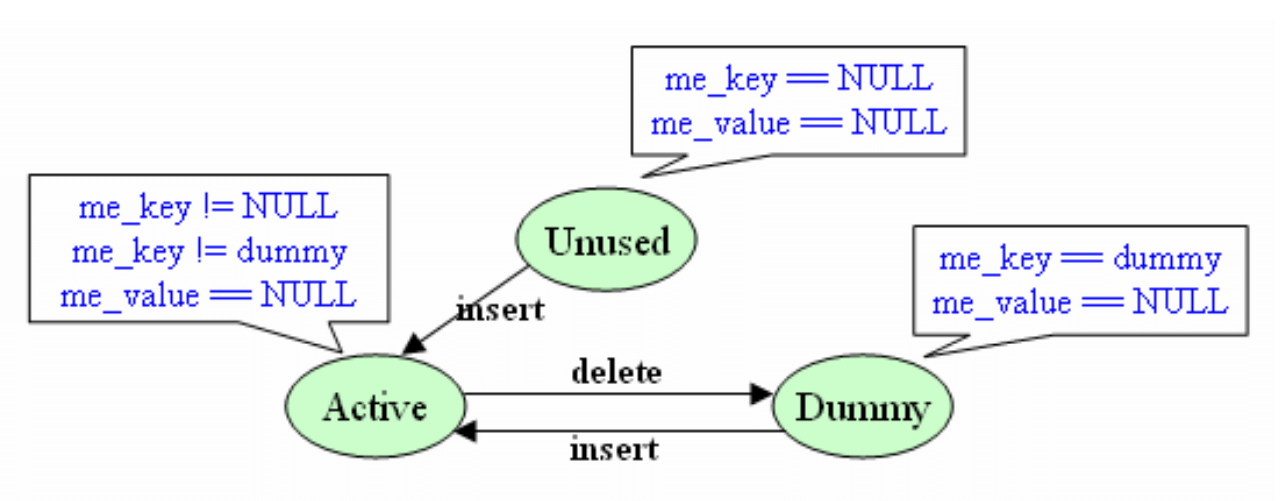
    Py_ssize_t ma_fill; //表示所有激活元素(active entry)和虚拟元素(dummy entry)的计数。
    Py_ssize_t ma_used; //所有激活元素的计数
    Py_ssize_t ma_mask; //哈希表的位掩码,这个表中包含 ma_mask + 1 个哈希槽(slot)    PyDictEntry *ma_table; //PyDictEntry 结构体的数组, PyDictEntry 包含 key 对象、value 对象,以及 key 的哈希;
    PyDictEntry *(*ma_lookup)(PyDictObject *mp, PyObject *key, long hash);//用于查找 key 的函数指针
    PyDictEntry ma_smalltable[PyDict_MINSIZE]; //最小有 8 个槽的哈希表
};

上面是 字典 Key 值状态转换图。如果删除一个 key,这个元素将被设置为 dummy,并不是真的删除。dummy 状态的元素在插入新的元素之后,变为激活状态。

  • 基本函数

Objects/dictobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
static PyMethodDef mapp_methods[] = {
    ...
     sizeof__doc__},
    {"has_key",         (PyCFunction)dict_has_key,      METH_O,
     has_key__doc__},
    {"get",         (PyCFunction)dict_get,          METH_VARARGS,
     get__doc__},
    {"setdefault",  (PyCFunction)dict_setdefault,   METH_VARARGS,
     setdefault_doc__},
    {"pop",         (PyCFunction)dict_pop,          METH_VARARGS,
     pop__doc__},
    {"popitem",         (PyCFunction)dict_popitem,      METH_NOARGS,
     popitem__doc__},
    {"keys",            (PyCFunction)dict_keys,         METH_NOARGS,
    keys__doc__},
    {"items",           (PyCFunction)dict_items,        METH_NOARGS,
     items__doc__},
    {"values",          (PyCFunction)dict_values,       METH_NOARGS,
     values__doc__},
    {"viewkeys",        (PyCFunction)dictkeys_new,      METH_NOARGS,
     viewkeys__doc__},
    {"viewitems",       (PyCFunction)dictitems_new,     METH_NOARGS,
     viewitems__doc__},
    {"viewvalues",      (PyCFunction)dictvalues_new,    METH_NOARGS,
     viewvalues__doc__},
    {"update",          (PyCFunction)dict_update,       METH_VARARGS | METH_KEYWORDS,
     update__doc__},
    {"fromkeys",        (PyCFunction)dict_fromkeys,     METH_VARARGS | METH_CLASS,
     fromkeys__doc__},
    {"clear",           (PyCFunction)dict_clear,        METH_NOARGS,
     clear__doc__},
    {"copy",            (PyCFunction)dict_copy,         METH_NOARGS,
     copy__doc__},
    {"iterkeys",        (PyCFunction)dict_iterkeys,     METH_NOARGS,
     iterkeys__doc__},
    {"itervalues",      (PyCFunction)dict_itervalues,   METH_NOARGS,
     itervalues__doc__},
    {"iteritems",       (PyCFunction)dict_iteritems,    METH_NOARGS,
     iteritems__doc__},
    {NULL,              NULL}   /* sentinel */
};
  • 初始化

Objects/dictobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
PyObject *
PyDict_New(void)
{
    register PyDictObject *mp;
    // 初始化dummy
    if (dummy == NULL) { /* Auto-initialize dummy */
        dummy = PyString_FromString("<dummy key>");
        if (dummy == NULL)
            return NULL;
    }
    ...
    // 如果缓冲池可用,取最后一个可用对象,并将其清空、初始化。
    if (numfree) {
        mp = free_list[--numfree];
        assert (mp != NULL);
        assert (Py_TYPE(mp) == &PyDict_Type);
        _Py_NewReference((PyObject *)mp);
        if (mp->ma_fill) {
            EMPTY_TO_MINSIZE(mp);
        } else {
            /* At least set ma_table and ma_mask; these are wrong
               if an empty but presized dict is added to freelist */
            INIT_NONZERO_DICT_SLOTS(mp);
        }
        ...
    } else {
        // 否则,申请新的内存对象
        mp = PyObject_GC_New(PyDictObject, &PyDict_Type);
        if (mp == NULL)
            return NULL;
        ...
    }
    // 设置搜索方法
    mp->ma_lookup = lookdict_string;
    ...
    return (PyObject *)mp;
}

这里说明一下,字典对象的缓冲池free_list, 是一个长度为 80 的数组。

  • get

调用逻辑:dict_get -> lookdict_string -> lookdict,返回查询到的值

Objects/dictobject.c

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
static PyObject *
dict_get(register PyDictObject *mp, PyObject *args)
{
    ...
    ep = (mp->ma_lookup)(mp, key, hash);
    ...
    val = ep->me_value;
    ...
    return val;
}
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
static PyDictEntry *
lookdict(PyDictObject *mp, PyObject *key, register long hash)
{
    ...
    register PyDictEntry *freeslot;
    register size_t mask = (size_t)mp->ma_mask; // 掩码等于数组长度 - 1
    ...
    // 计算所在 entry 位置.
    i = (size_t)hash & mask;
    ep = &ep0[i];
    // 如果找到,则返回 entry
    if (ep->me_key == NULL || ep->me_key == key)
        return ep;

    // 如果是 dummy,赋值给 freeslot,freeslot 用来指向探测序列中第一个处于dummy 态的 entry。如果搜索失败,则返回 freeslot,其指向的 enery ->me_value 为  NULL
    if (ep->me_key == dummy)
        freeslot = ep;
    else {
        // 搜索成功
        if (ep->me_hash == hash) {
            startkey = ep->me_key;
            Py_INCREF(startkey);
            cmp = PyObject_RichCompareBool(startkey, key, Py_EQ);
            Py_DECREF(startkey);
            if (cmp < 0)
                return NULL;
            if (ep0 == mp->ma_table && ep->me_key == startkey) {
                if (cmp > 0)
                    return ep;
            }
            else {
                /* The compare did major nasty stuff to the
                 * dict:  start over.
                 * XXX A clever adversary could prevent this
                 * XXX from terminating.
                 */
                return lookdict(mp, key, hash);
            }
        }
        freeslot = NULL;
    }

    // 冲突时,二次探测
    for (perturb = hash; ; perturb >>= PERTURB_SHIFT) {
        i = (i << 2) + i + perturb + 1;
        ep = &ep0[i & mask];
        if (ep->me_key == NULL)
            return freeslot == NULL ? ep : freeslot;
        if (ep->me_key == key)
            return ep;
        if (ep->me_hash == hash && ep->me_key != dummy) {
            ...
        }
        else if (ep->me_key == dummy && freeslot == NULL)
            freeslot = ep;
    }
    ...
}

5. 参考