
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

aimingoo的专栏
aimingoo的专栏
I
InfoQ
B
Blog RSS Feed
D
Docker
GbyAI
GbyAI
N
Netflix TechBlog - Medium
Y
Y Combinator Blog
F
Fortinet All Blogs
P
Proofpoint News Feed
Microsoft Azure Blog
人人都是产品经理
人人都是产品经理
Martin Fowler
Martin Fowler
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
M
MIT News - Artificial intelligence
C
Check Point Blog
Vercel News
Vercel News
云风的 BLOG
云风的 BLOG
博客园 - Franky
Google DeepMind News
WordPress大学
WordPress大学
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
V
V2EX
Last Week in AI
Last Week in AI
L
LangChain Blog

Mobility

从薅 token 到管 skill:我的 pks 工具落地实践 把笔记、微信读书、知乎装进 Obsidian:我基于llm-wiki知识中枢搭建实录 免费AI视频生成器:我如何用零成本做出带旁白字幕的多场景AI视频 Agnes免费模型真能白嫖视频?我改造了ViMax来试试 教你薅token(二):构建agent无关的skills管理工作流 教你薅token:构建agent无关的AI工作流 用 AI Agent 完成 Hexo 主题迁移:从 Next 到 Butterfly 的全自动化实践 Vercel封禁163邮箱后,我是怎么恢复博客的 用LLM管理安全开发规范:一次llm-wiki实践 Vaadin框架教程:Java工程师的前端开发秘籍 hexo多语言方案总结及最佳实践 知乎增强工具-评论时间精确到秒 怎么理解数据库的四个隔离级别 kubernetes是什么-实用向教程 怎么更科学的用知乎摸鱼 读书笔记《系统之美》,如何面对现实中的复杂问题 分布式系统设计中的通用方法 高并发解决方案很难吗?轻松聊清楚高并发设计 SSP,DSP,RTB,ADX都是什么? 讲讲互联网广告的概念与发展 从redolog,undolog到隔离级别,刨根问底,讲清楚事务和ACID java项目低学习成本使用kubernetes的实践经验 剧变中的2021-一个中年工程师的年终总结 kubernetes环境下做金丝雀发布的一种思路 prometheus教程: 一篇文章讲懂prometheus 实现一个简单的java版本高性能获取ip地址所属国家工具 iterm2配置ssh书签, 实现记住密码和自动登录 怎样做一个好的技术分享 云原生究竟是什么 读书笔记 稻盛和夫《干法》-思考应该怎样去工作 review的个人价值
redis里的数据结构
流沙 · 2020-07-11 · via Mobility

Redis作为当前使用非常广泛的内存数据库,在代码层面做了很多极致的优化,已获取更好的性能。其中重要的一部分,就是对于底层数据结构的使用。Redis会根据数据量、数据大小等来优化对于不同结构的使用,从而获得更佳的运行效率和内存占用。Redis的核心数据结构包括简单动态字符串、列表、字典、跳跃表、整数集合、压缩列表。

接下来,我们就依次讲讲这些数据结构。

简单动态字符串(SDS)

Redis是用C语言实现的。先复习一下C,C里的字符串中不记录字符串长度,以空字符标记结尾。这样会显而易见的带来三个问题:1.获取字符串长度需要O(n)的复杂度;2.操作不慎会导致缓冲区溢出,例如内存中紧邻的两个字符串,如果对前一个调用strcat拼接其他字符串,就会造成溢出;3. 一些特殊内容,如图像、音频等转成二进制时,难免其中夹杂空字符等特殊字符,这样就无法被C字符串存储了,即C字符串不具备二进制安全性。

而这几点,对于Redis的应用场景来说,影响其实都是非常大的。因此,在redis中定义了一个新的结构,用来保存字符串,即SDS。

SDS的核心思想就是额外使用一个字段记录字符串的长度,这样,上面三个问题就都迎刃而解了。

此外,redis从4.0开始对SDS做了一个代码层面的优化,优化了内存占用,不过不影响其底层逻辑。

这是redis 3.0里SDS的源码:

1
2
3
4
5
struct sdshdr {
unsigned int len;
unsigned int free;
char buf[];
};

而这是redis 4.0之后SDS的源码:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
...
struct __attribute__ ((__packed__)) sdshdr5 {
unsigned char flags;
char buf[];
};
struct __attribute__ ((__packed__)) sdshdr8 {
uint8_t len;
uint8_t alloc;
unsigned char flags;
char buf[];
};
struct __attribute__ ((__packed__)) sdshdr16 {
uint16_t len;
uint16_t alloc;
unsigned char flags;
char buf[];
};
struct __attribute__ ((__packed__)) sdshdr32 {
uint32_t len;
uint32_t alloc;
unsigned char flags;
char buf[];
};
struct __attribute__ ((__packed__)) sdshdr64 {
uint64_t len;
uint64_t alloc;
unsigned char flags;
char buf[];
};
...
...

可以看到,在新版的源码里,数据存储会根据情况使用uint8,uint16等不同类型。在C里,一个int占用4个字节,因此,对于原版的SDS来说,即使存储的信息非常少,也会固定占到8个字节。而uint8只占一个字节,uint16只占2个字节,对于小数据来说,redis的内存占用会有明显优化。

此外,redis会有空间预分配、惰性释放等机制,减少内存分配的次数。SDS的实现方式也保证了大部分方法可以兼容C字符串,减少了大量实现成本。

链表

Redis里的链表是一个普通的双向无环链表,相信大家都很熟悉了,就不细说了,结构如下。

1
2
3
4
5
6
7
8
9
10
typedef struct listNode {

struct listNode *prev;

struct listNode *next;

void *value;

} listNode;

Redis中的列表对象,底层就是链表。

字典

字典也就是我们常说的map。

1
2
3
4
5
6
7
8
9
10
11
12
typedef struct dictht {

dictEntry **table;

unsigned long size;

unsigned long sizemask;

unsigned long used;

} dictht;

Redis中的字典是hash表,使用链地址法解决hash地址冲突。

类似于java等语言中的hashMap, redis的字典也会有rehash的机制,保证其负载因子维持在合理的范围内。

跳跃表 (skiplist)

Skiplist是一种应用非常广的数据结构,通常是作为AVL树的一种替代选择,和AVL树一样,skiplist的查找复杂度也是O(logn), 但是实现会简单的多,下边我们用短短的几行字就能把SkipList的所有内容讲的非常清楚。此外,在并发环境下,SkipList也会有很大优势,因为AVL数在平衡过程中,可能会涉及到很多节点,也就需要锁住很多节点,SkipList则完全不存在这种问题。
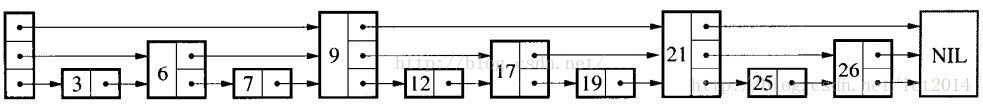
skiplist

从网上找了一张示意图,可以很清楚的展示出SkipList的结构。跳跃表说白了就是一个多层的列表,每一个元素会随机的出现在某一层上,然后某一层的链表中会包含所有高于或等于本层的元素。

跳跃表的查找就是从高层查起,逐步降层,定位到具体元素。比如要查询7, 其顺序就是9->6->7.

跳跃表的插入也是先做一次查找,然后直接给元素设置一个随机的层数,再调整指针。

删除则是删除节点,然后调整指针。

Redis中的有序集合,就是基于跳跃表实现的。

整数集合(intset)和压缩列表(ziplist)

这两个结构非常像,因此就放在一起讲了。它们都是针对特定条件下的小数据集做的特定优化。

整数集合是一个有序集合,使用的条件是集合中只包含整数,且元素个数不多。

压缩列表同样是针对列表项非常少的情况,且要求元素只能是小整数值或短字符串。它可以提供类似双向链表的功能。

因为整数集合和压缩列表都是针对小数据集的,所以可以使用连续的内存空间去保存,实现也就简单了很多,这里就不细说了。

在实际应用中,zipList可以作为链表或者字典的替代品,应用在redis的列表、哈希、有序集合中。整数集合则作为字典的替代品,用在集合对象中。

以上就是redis中主要的数据结构,在这些结构的基础上,redis实现了大量功能完善的对象,供我们使用。理解了redis这些底层结构的原理,也可以帮助我们更好的发挥redis的价值。

原文地址:https://lichuanyang.top/posts/22179/