


DRL(Deep Reinforcement Learning)的首次惊艳亮相,应该是 DeepMind 在2013年首次将其应用于 Atari 游戏中提出的 DQN(Deep Q Network)算法。到现在,短短7年间,DRL 已经从玩 Atari,进化为下围棋(Alphago)、玩电竞(Dota AI、StarCraft AI),一次次刷新大家的三观。
Q-Learning算法是一种使用时序差分求解强化学习控制问题的方法。通过当前的状态\(S\),动作\(A\),即时奖励\(R\),衰减因子\(γ\),探索率\(ϵ\),获取最优的动作价值函数\(Q\)(table)和最优策略\(π\)。
\(S\):表示环境的状态,在\(t\)时刻环境的状态为\(S_t\)
\(A\):agent的动作,在\(t\)时刻采取的动作为\(A_t\)
\(R\):环境的奖励,在\(t\)时刻agent在状态\(S_t\)采取动作\(A_t\)对应的奖励\(R_{t}\) 会在 \(t+1\) 时刻得到
\(\gamma\):折扣因子, 当前延时奖励的权重
\(\epsilon\):探索率,在Q-learning我们会根据当前状态,对应\(Q\)(table)值函数最大的值选取动作,可能会导致有的动作从来都没选取过,在agent选择动作时,有小概率会随机选取其他动作。这样做的目的是让agent尽可能学习到最优的策略。
首先我们基于状态\(S\),用\(ϵ−greed\)(贪心)选择到动作\(A\), 然后执行动作\(A\),得到奖励\(R\),并进入状态\(S'\),\(Q\)值的更新公式如下:
$$Q(S,A)=Q(S,A)+\alpha(R+\gamma maxQ(S',a)-Q(S,A))$$
初始化状态和动作价值函数对应的价值。(初始化\(Q\)表格)
for i from 1 to T(T:迭代的总轮数)
a)初始化\(S\)为当前状态的序列的第一个状态
b)用\(ϵ\)−贪婪法在当前状态\(S\)选择出动作\(A\)
c)在状态\(S\)执行当前动作\(A\),得到新状态\(S′\)和奖励\(R\)
d)更新价值函数\(Q(S,A)\):
$$Q(S,A)=Q(S,A)+\alpha(R+\gamma maxQ(S',a)-Q(S,A))$$
e)\(S=S'\)
f) if \(done\) 完成当前迭代
(1)迷宫游戏地图
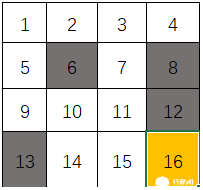
1表示迷宫入口
黑色的框为陷阱
黄色的框为出口(奖励点)
(2) 这是一个训练模型之后的Q表格
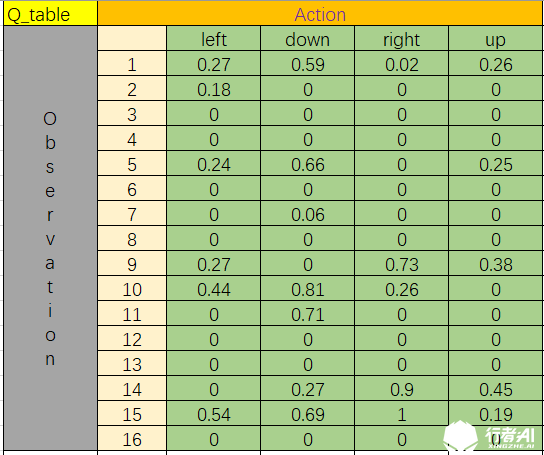
(3) 举个简单的例子
最后agent的动作路线为1-->5-->9-->10-->14-->15-->16
每跑一次,\(Q\)表格的值都会有所改变,但是原理不变。(通过不断的迭代,agent学习到的策略在Q(table)中对应的动作的值会越来越大)
前面讲过Q-Learning的决策是根据Q表格的值,执行那个动作后得到的奖励更多,就选取那个动作执行。前面所讲的状态空间和动作空间都很小,如果状态空间和动作空间变得非常大(可能为是一百维,一千维的数据),那我们还能用一个Q表格来表示吗?显然不可以,就引入了价值函数近似。
由于在实际问题中,一个问题的状态规模很大,一个可行的解决办法就是使用价值函数近似。我们引入一个状态价值函数\(\hat v\),由权重\(\omega\)描述,以状态\(s\)作为输入,计算得到状态\(s\)的价值:
$$\hat v(s,w)\approx v_\pi(s)$$
上面我们提到的\(\omega\)就相当于我们神经网络中的参数,通过输入的状态\(s\),采用MC(蒙特卡洛)/TD(时序差分)计算出价值函数作为输出,然后对权重\(\omega\)进行训练,直到收敛。事实上,所谓的DQN就是将神经网络和Q-Learning结合,将Q表格变成了Q网络。
DQN是一种Off-Policy算法,用李宏毅老师的话讲,可以看着别人学习,那么DQN为什么能够看着别人学习呢?DQN采用了一种经验回放的方式进行学习。每次agent和环境交互得到的奖励,当前状态和下一个状态等数据保存起来,用于后面Q网络的更新。
下面我们看下Nature DQN,其实Nature DQN为DQN第二代了,DQN NIPS为最原始的DQN,在这之上的还有很多的DQN的版本,比如Double DQN、Dueling DQN等等。之所以在这儿给大家介绍Nature DQN呢!笔者觉得这个版本的DQN,应该是最经典的了。接下来我们看看DQN是如何进行强化学习的吧。
输入:总迭代轮数\(T\),状态特征维度\(n\),动作维度\(A\), 步长\(a\),衰减因子\(\gamma\), 探索率\(\epsilon\), 当前Q网络\(Q\),目标Q网络\(Q'\), 批量梯度下降的样本数\(m\),目标Q网络参数更新频率\(P\)。
输出:Q网络参数
\[f(n) \begin{cases} R_j, &isdone_j\ is\ true\\ R_j+\gamma max_a′ Q' (\phi(S'_j),A_j',\omega') , &isdone_j\ is \ false \end{cases} \]
g)使用均方差损失函数\(\left(\frac{1}{m}\right)\)\(\sum_{j=1}^m\)(\(y_j-Q(\phi (S_j),A_j,\omega))^2\)通过神经网络梯度下降反向传播更新参数\(\omega\)
h)如果i%P=0,跟新目标\(Q\)网络的参数\(\omega'=\omega\)
i)如果\(S\)为终止状态,则当前迭代完毕,否则跳转到步骤(b)
(1) 网络结构
class Net(nn.Module):
    def __init__(self, ):
        super(Net, self).__init__()
        self.fc1 = nn.Linear(N_STATES, 50)
        self.fc1.weight.data.normal_(0, 0.1)   # initialization
        self.out = nn.Linear(50, N_ACTIONS)
        self.out.weight.data.normal_(0, 0.1)   # initialization
    def forward(self, x):
        x = self.fc1(x)
        x = F.relu(x)
        actions_value = self.out(x)
        return actions_value
(2) 动作的选取
    def choose_action(self, x):  #x为当前状态的4个值
        x = torch.unsqueeze(torch.FloatTensor(x), 0)  #在数据的第0维处增加一维
        # input only one sample
        if np.random.uniform() < EPSILON:   # greedy #贪婪取法
            actions_value = self.eval_net.forward(x)  ##传入eval_net获取下一个的动作
            action = torch.max(actions_value, 1)[1].data.numpy()  ##返回这一行中最大值的索引
            action = action[0] if ENV_A_SHAPE == 0 else action.reshape(ENV_A_SHAPE)  # return the argmax index
        else:   # random
            action = np.random.randint(0, N_ACTIONS)
            # action = random.sample(N_ACTIONS)
            action = action if ENV_A_SHAPE == 0 else action.reshape(ENV_A_SHAPE)
        return action
加入了一个探索值\((\epsilon)\),在即小的可能性是随机选择动作。
(3) 经验池
    def store_transition(self, s, a, r, s_):  #s和s_都为4个值,分别为  位置 移动速度  角度  移动角度
        transition = np.hstack((s, [a, r], s_))
        # replace the old memory with new memory #更新经验
        index = self.memory_counter % MEMORY_CAPACITY
        self.memory[index, :] = transition  #将第index经验替换为transition
        self.memory_counter += 1
(4) 更新网络参数
 def learn(self):
        # target parameter update 目标参数更新
        if self.learn_step_counter % TARGET_REPLACE_ITER == 0:
            self.target_net.load_state_dict(self.eval_net.state_dict())  ## 每学习200步将eval_net的参数赋值给target_net
        self.learn_step_counter += 1
        # sample batch transitions  #选取过渡
        sample_index = np.random.choice(MEMORY_CAPACITY, BATCH_SIZE) #从MEMORY_CAPACITY随机选取BATCH_SIZE个
        b_memory = self.memory[sample_index, :]
        b_s = torch.FloatTensor(b_memory[:, :N_STATES])  #第一个状态
        b_a = torch.LongTensor(b_memory[:, N_STATES:N_STATES+1].astype(int)) #动作
        print("--------")
        print(b_a)
        print("-----")
        b_r = torch.FloatTensor(b_memory[:, N_STATES+1:N_STATES+2]) #得分
        b_s_ = torch.FloatTensor(b_memory[:, -N_STATES:]) #下一个状态
        # q_eval w.r.t the action in experience
        q_eval = self.eval_net(b_s).gather(1, b_a)   # shape (batch, 1) 当前状态的Q值使用eval_net计算
        # print("++++++")
        # print(self.eval_net(b_s))
        # print(self.eval_net(b_s).gather(1,b_a))
        # print("+++++++")

        q_next = self.target_net(b_s_).detach()   #使用target_net计算下一步Q值  # detach from graph, don't backpropagate detach防止targent——net反向传播
        q_target = b_r + GAMMA * q_next.max(1)[0].view(BATCH_SIZE, 1)   # shape (batch, 1)
        loss = self.loss_func(q_eval, q_target)
        self.optimizer.zero_grad()   #zer——grad设置所有优化器的梯度为0
        loss.backward()   #反向传播
        self.optimizer.step()    #执行下个优化
DQN是深度强化学习的门槛,只要踏进了大门,后面的学习就会很轻松。
行者AI(成都潜在人工智能科技有限公司,xingzhe.ai)致力于使用人工智能和机器学习技术提高游戏和文娱行业的生产力,并持续改善行业的用户体验。我们有内容安全团队、游戏机器人团队、数据平台团队、智能音乐团队和自动化测试团队。 > >如果您对世界拥有强烈的好奇心,不畏惧挑战性问题;能够容忍摸索过程中的各种不确定性、并且坚持下去;能够寻找创新的方式来应对挑战,并同时拥有事无巨细的责任心以确保解决方案的有效执行。那么请将您的个人简历、相关的工作成果及您具体感兴趣的职位提交给我们。我们欢迎拥抱挑战、并具有创新思维的人才加入我们的团队。请联系:hr@xingzhe.ai > >如果您有任何关于内容安全、游戏机器人、数据平台、智能音乐和自动化测试方面的需求,我们也非常荣幸能为您服务。可以联系:contact@xingzhe.ai
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。