



惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

F
Fortinet All Blogs
aimingoo的专栏
aimingoo的专栏
V
Visual Studio Blog
罗磊的独立博客
爱范儿
爱范儿
J
Java Code Geeks
博客园 - 司徒正美
N
Netflix TechBlog - Medium
Microsoft Security Blog
美团技术团队
小众软件
小众软件
Google DeepMind News
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
V
V2EX
博客园 - 聂微东
云风的 BLOG
云风的 BLOG
WordPress大学
WordPress大学
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Jina AI
Jina AI
Y
Y Combinator Blog
博客园 - 叶小钗
人人都是产品经理
人人都是产品经理
Martin Fowler
Martin Fowler
Vercel News
Vercel News

博客园 - 西瓜K菠萝

【转载】主成分分析法(PCA) 最优化问题的简洁介绍 svm常用核函数 [转]核函数K(kernel function) 【转载】极大值与等高线 [转载]用等高线图(Contour maps)可视化多变量函数 【转载】反向传播算法解释 【转载】正则化避免过拟合 【转载】多项式分布 【转载】广义线性模型 【转载】指数分布族 Octave 里的 fminunc 【转载】第3周笔记-逻辑回归 先验概率、后验概率、贝叶斯公式、 似然函数 从几率到logisitic函数 如何理解logistic函数? 【转载】logistic回归 【转载】逻辑回归 【转载】用OCTAVE实现一元线性回归的梯度下降算法
[转载]牛顿方法
西瓜K菠萝 · 2018-03-18 · via 博客园 - 西瓜K菠萝

[转载]牛顿方法

Posted on 2018-03-18 22:25  西瓜K菠萝  阅读(242)  评论()    收藏  举报

http://blog.csdn.net/v1_vivian/article/details/52038037

牛顿方法也是对解空间进行搜索。

基本思想:对于函数f(x),如果我们要找到使得函数值为0的x值时,做法如下:
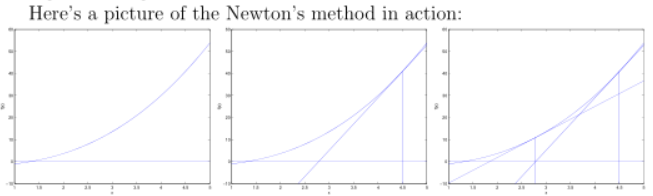
1、随机选一个点(θ0),然后求出该点的切线,即导数。

2、延长它使之与x轴相交,以相交时的x的值(θ1)。

3、重复1、2直到f(x)==0

我们可以得知:其中θ的更新规则为:

对于机器学习问题,我们优化的目标函数为极大似然估计函数,当极大似然估计函数取得最大时,其导数为0。

所以,我们可以使得,由此可得:
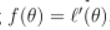
上面是当参数θ为实数时的情况,当参数为向量时,更新规则为:(其中,H是一个n*n的矩阵,n为参数向量的长度,即特征数,H是函数的二阶导数矩阵,被称为Hessian矩阵,此时,用一个表示一阶导数的向量乘上一个表示二阶导数的矩阵的逆,来表达上式中的一阶导数除以二阶导数)
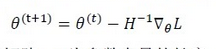
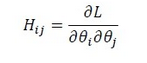
          

牛顿方法的优点:

牛顿方法与梯度下降方法功能一样,都是在寻到解空间,但相比较而言,牛顿方法的优点是收敛速度快,通常只要经过十几次迭代就可以达到收敛。牛顿方法也被称为二次收敛,因为当迭代到距离收敛值比较近的时候,每次迭代都能使误差变为原来的平方。

牛顿方法的缺点:

牛顿方法的缺点是当参数向量较大时,每次迭代都需要计算一次Hessian矩阵的逆,比较耗时。