


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Microsoft Azure Blog
WordPress大学
WordPress大学
小众软件
小众软件
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
V
V2EX
Hugging Face - Blog
Hugging Face - Blog
美团技术团队
博客园 - 三生石上(FineUI控件)
Last Week in AI
Last Week in AI
酷 壳 – CoolShell
酷 壳 – CoolShell
博客园 - Franky
Microsoft Security Blog
Y
Y Combinator Blog
A
About on SuperTechFans
The GitHub Blog
The GitHub Blog
U
Unit 42
H
Hackread – Cybersecurity News, Data Breaches, AI and More
云风的 BLOG
云风的 BLOG
IT之家
IT之家
MyScale Blog
MyScale Blog
V
Visual Studio Blog
Cyber Security Advisories - MS-ISAC
I
InfoQ
博客园 - 司徒正美

博客园 - 高天蒲

前端 mysql常见问题 互联网数据的挖掘和分析 针对wordpress的二次开发 datejs lib awk Optimal Logging python 复制文件 PHP笔记 grep 笔记 svn笔记 快速开发的要素 Javascript 类、命名空间、代码组织 武士与黑客 ImageMagick Errors: Convert PDF to Images web.py学习随笔 HTML5 and CSS3 做前端的一些小工具 提高勾搭的成功几率(瞎写的,打扰了)
网页内容爬取:如何提取正文内容
高天蒲 · 2013-03-15 · via 博客园 - 高天蒲

创建一个新网站,一开始没有内容,通常需要抓取其他人的网页内容,一般的操作步骤如下:

根据url下载网页内容,针对每个网页的html结构特征,利用正则表达式,或者其他的方式,做文本解析,提取出想要的正文。

为每个网页写特征分析这个还是太耗费开发的时间,我的思路是这样的。

Python的BeautifulSoup包大家都知道吧,

import BeautifulSoup
soup = BeautifulSoup.BeautifulSoup(html)

利用这个包先把html里script,style给清理了:

[script.extract() for script in soup.findAll('script')]
[style.extract() for style in soup.findAll('style')]

清理完成后,这个包有一个prettify()函数,把代码格式给搞的标准一些:

然后用正则表达式,把所有的HTML标签全部清理了:

reg1 = re.compile("<[^>]*>")
content = reg1.sub('',soup.prettify())

剩下的都是纯文本的文件了,通常是一行行的,把空白行给排除了,这样就会知道总计有多少行,每行的字符数有多少,我用excel搞了一些每行字符数的统计,如下图:
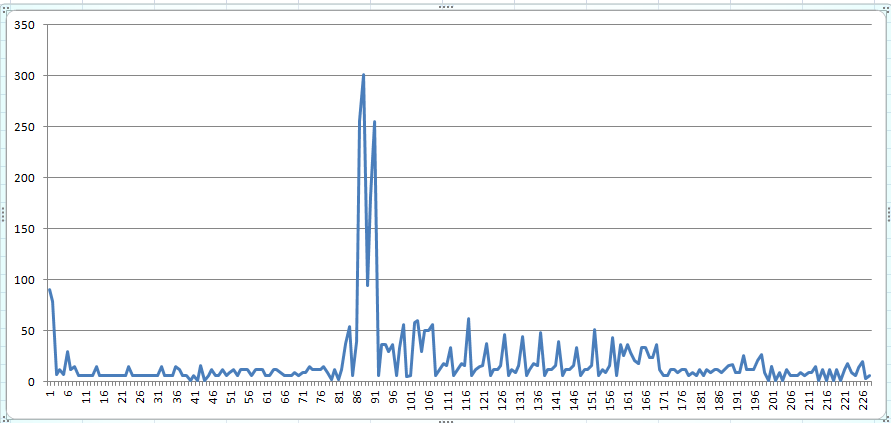
x坐标为行数,y坐标为该行的字符数

很明显,会有一个峰值,81~91行就应该是这个网页的正文部分。我只需要提取81~91行的文字就行了。

问题来了,照着这个思路,有什么好的算法能够通过数据分析的方式统计出长文本的峰值在哪几行?

附带一个开源的提取文本的python包,https://github.com/xgdlm/python-goose