- 标签: #CLIP #Image2Text #Text2Image #OpenAI
- 创建时间:2023-04-21 00:17:52
基本原理
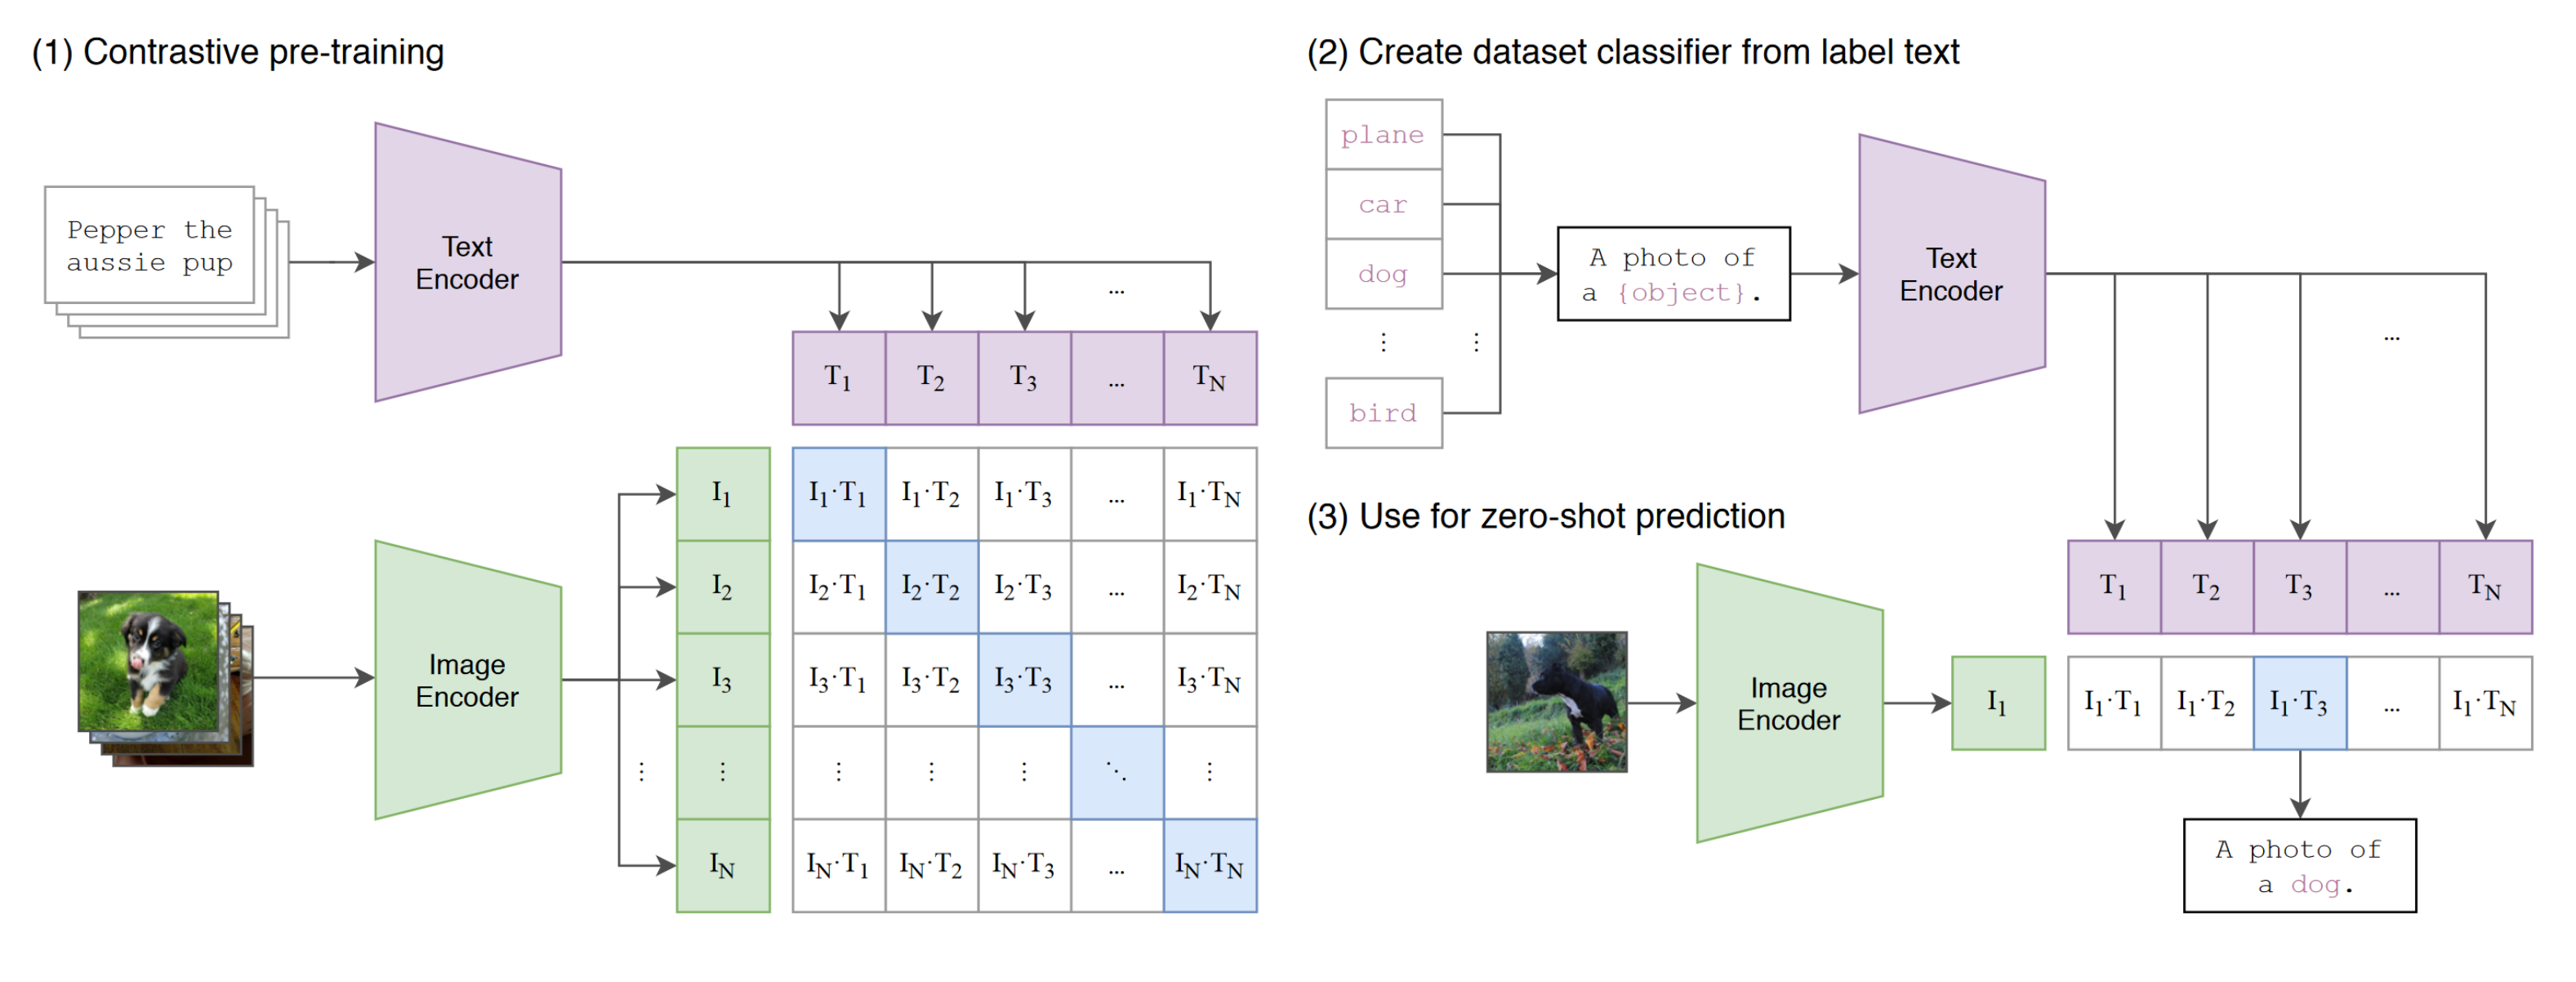
- CLIP是一个图像分类模型。
- 准备训练数据:准备大量的文本描述和图片的训练对,然后把进行对比训练。
- 文本描述和图片的训练对的数据获取:从互联网上获得400Million的图像文本数据对。这个 规模大致和GPT-2的数据规模相当。
1. 好处1:数据获取容易。传统的做法会对图像进行分类,以ImageNet为例,获得图片后需要人工进行分类标注,这个周期长成本高。
2. 好处2:迁移能力强。过去是精确分类一张图片,这样当出现一个未包含的图片的时候,在已知图片分类里就找不到对应的答案了。而CLIP因为训练的素材里面的描述是文本性的(而不是一两个单词的简单分类名称),因此它获得了更好的泛化能力。
- 因为有了这么大的数据,所以需要更好大量的算力,以及优质的算法。
- Text Encoder采用的是Transformer。
- Image Encoder采用的是Vision Transformer。
- 整个计算在256个V100 GPU上训练2周(12天),得出了ViT-L/14@336px模型。
- CLIP的设计初衷是为了能够做到零样本迁移(Zero-Shot)到下游数据集上的,也就是说,希望训练完的模型,在遇到一个完全没有见过的图片训练集的时候,可以进行高效的分类。为了达到这个零样本学习的能力:
- 研发人员摒弃了传统的数据集,因为传统的数据集通常是建立在明确分类基础上的,所以当一个新分类的图片出现的时候,这个模型就不知所措了。
- 把一般的分类换成一个描述性的文本,则可以比较好的解决这个问题。这里列出了他们准备文本描述的模板,通过这些模板,可以把一个带有歧义的单词,变成一个有意义的图像描述,比如论文里举例:boxer,当只提到这个词的时候,我们可能以为它是个拳击手,但是当结合了模板
A photo of a {label}, a type of pet.(其中{label}替换成boxer)那么boxer就可以被理解为一种狗(其中在生成数据的时候,比如a type of pet部分也是可以自动拼进去的,比如图片本来就来自牛津词典宠物图片集,那么自然就可以增加这样的分类信息,这会进一步让图像识别变得更加精准)。
- 主要用途:图像搜索(基于文本)、自然语言描述图像等。
- 限制:参考论文P18(6. Limitations)
- 结果:CLIP在Zero-Shot的情况下,在大部分常见数据集上都比特定训练的模型表现的好。在一些特别的模型基础上,Zero-Shot可能不一定有很好的效果,但是进行Few-shot则比特定训练的模型表现要好,因此模型具备很强的迁移能力。
- 引发的思考:
- 数据量大,就可以获得不一样的研究方法和模型效果。其实CLIP用到的方法并不新鲜,前人也有用过类似的方法,但是因为没有采用这么大的数据量,所以没有达到SOTA的效果。
- 模型的输入输出都变成了token,也可以理解都都是文本,它和NLP领域的GPT模型带来的颠覆性相似。
- 因为是一般性的文本描述,而不是特定分类描述,所以模型具备了多模态的特性。
- 因为是一般性的文本描述,所以模型可以用于自然语言描述图像。
- 这个项目的训练方法没有开源,但是训练结果的模型开源了。
基于CLIP延展的项目
- StyleCLIP:变化发型、眼睛等。
- CLIPDraw :CLIPDraw: Exploring Text-to-Drawing Synthesis through Language-Image Encoders 可以通过CLIP绘制一些蜡笔画。
- Paper:Open-Vocabulary Object Detection Using Captions 基于字幕的开放词汇目标检测 目标检测。
- Contrastive Language-Image Forensic Search 基于文本对视频中的内容进行检索。
参考资料
- Paper: Learning Transferable Visual Models From Natural Language Supervision 从自然语言监督中学习可迁移的视觉模型
- CLIP 论文逐段精读【论文精读】
- OpenAI | CLIP: Connecting text and images CLIP:连接文本和图像
转载请注明出处:https://www.cnblogs.com/volnet/p/openai-clip.html









