配置
- 安装插件
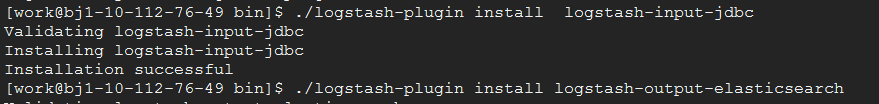
由于这里是从mysql同步数据到elasticsearch,所以需要安装jdbc的入插件和elasticsearch的出插件:logstash-input-jdbc、logstash-output-elasticsearch
安装效果图如下所示:- 下载mysql连接库
由于logstash是ruby开发的,所以这里要下载mysql的连接库jar包,从官网下载,我这里下载的是:mysql-connector-java-5.1.46.jar
将下载好的mysql-connector-java-5.1.46.jar,放至/usr/local/logstash/config/目录下。- 修改配置文件
在config目录下,创建配置文件(logstash-mysql-es.conf):这里有几个注意点:input { jdbc { # mysql相关jdbc配置 jdbc_connection_string => "jdbc:mysql://10.112.76.30:3306/jack_test?useUnicode=true&characterEncoding=utf-8&useSSL=false" jdbc_user => "root" jdbc_password => "123456"
(1)jdbc_driver_library
mysql-connector-java-5.1.46.jar的存放目录,这个一定要配置正确,支持全路径和相对路径。如果配置不对,将会报“can ”错误。
(2)sql_last_value
标志目前logstash同步的位置信息(类似offset)。比如id、updatetime。logstash通过这个标志,可以判断目前同步到哪一条数据。
(3)statement、statement_filepath
statement:执行同步的sql语句,可以同步部分数据。
statement_filepath:存储执行同步的sql语句。不和statement同时使用。
(4)schedule
定时器,表示每隔多长时间同步一次数据。格式类似crontab。
(5)tracking_column、tracking_column_type
tracking_column:表示表中哪一列用于判断logstash同步的位置信息。与sql_last_value比较判断是否需要同步这条数据。
tracking_column_type:racking_column指定列的类型。支持两种类型:numeric(默认)、timestamp。注意:如果列是时间字段(比如updateTime),一定要指定这个类型为timestamp。我就踩了这个大坑。。。一直同步不成功!!!
(6)last_run_metadata_path
存储sql_last_value值的文件名称及位置。
(7)document_id
生成elasticsearch的文档值,尽量使用同步的数据中已有的唯一标识。比如同步订单数据,可以使用订单号。
启动
在根目录下,执行命令:
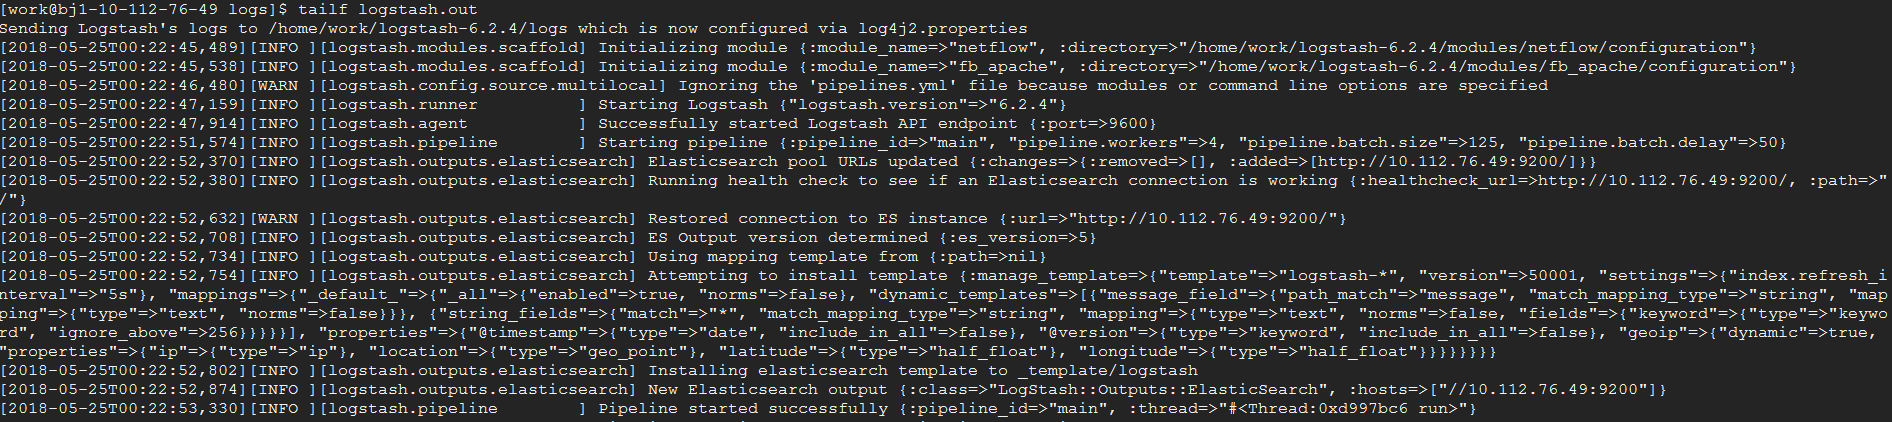
nohup bin/logstash -f config/logstash-mysql-es.conf > logs/logstash.out &效果图如下:
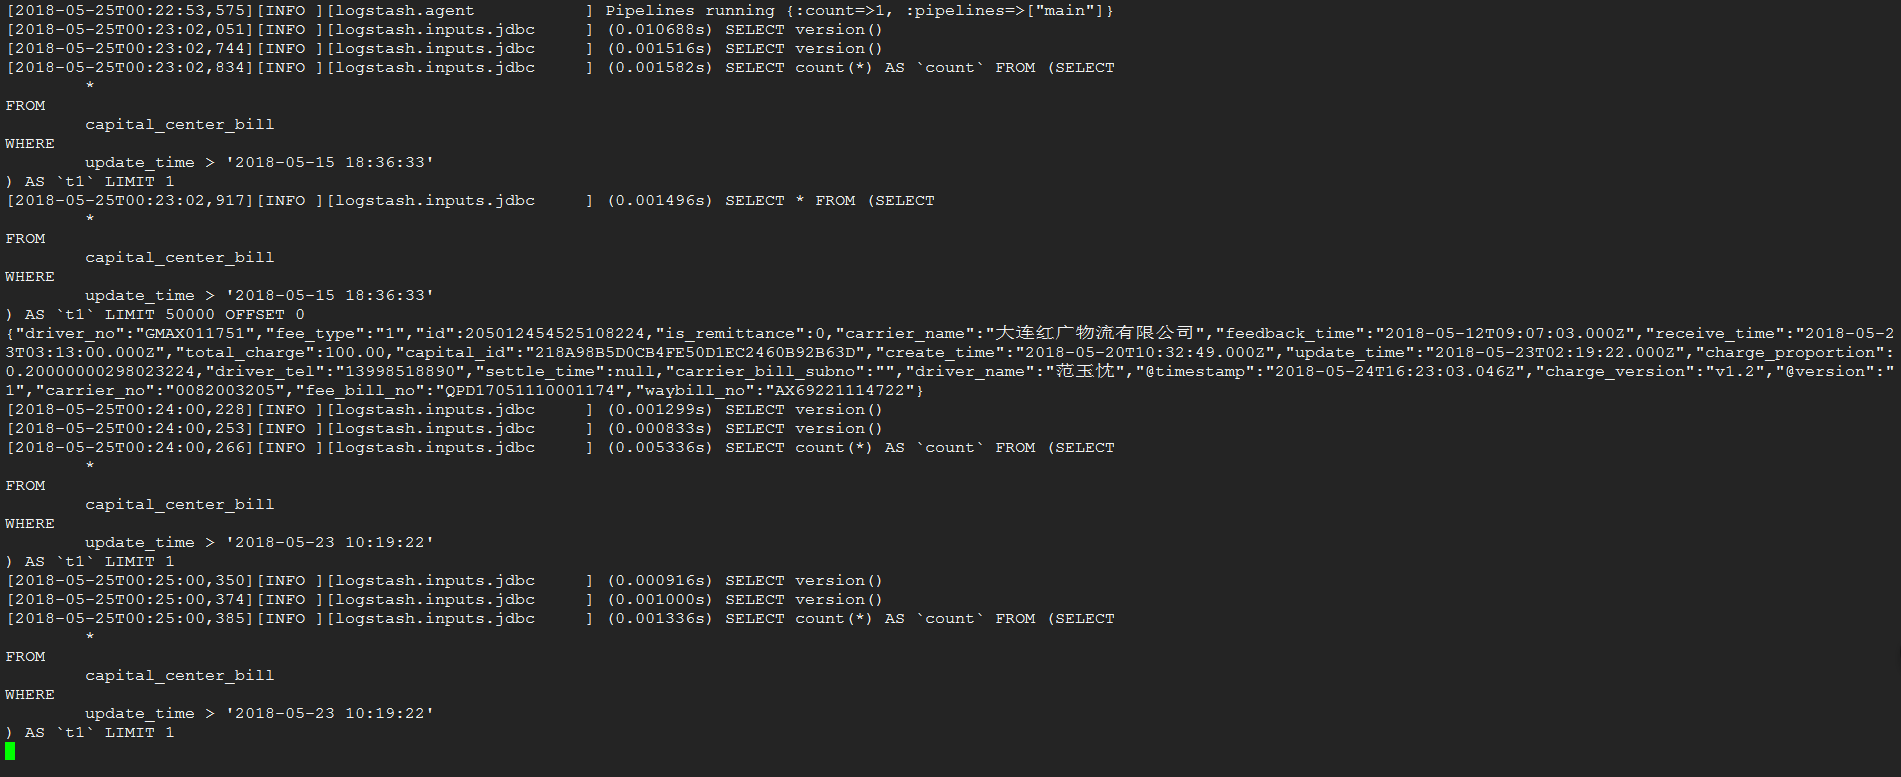
同步
完成了一条数据的同步
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。