惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

D
DataBreaches.Net
Y
Y Combinator Blog
I
InfoQ
Recent Announcements
Cyber Security Advisories - MS-ISAC
博客园 - Franky
IT之家
IT之家
H
Help Net Security
月光博客
月光博客
S
SegmentFault 最新的问题
B
Blog
aimingoo的专栏
aimingoo的专栏
GbyAI
GbyAI
P
Proofpoint News Feed
让小产品的独立变现更简单 - ezindie.com
G
Google Developers Blog
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
U
Unit 42
Vercel News
Vercel News
博客园 - 叶小钗
Microsoft Security Blog
腾讯CDC
Jina AI
Jina AI
T
The Blog of Author Tim Ferriss

博客园 - lmqljt

推荐系统公开课 王树森 讲解工业界真实的推荐系统 LangChain教程,langchain快速入门, Agent智能体rag项目实战 火山图 差异分析等 箱线图 拓展(缺口箱线图)等 多尺度时序间相关性:MSGNet 时序分析通用基础模型:TimesNet 预测/插补/分类/异常检测 扩散模型Difussion 随笔 大论文题目类参考 注意力机制创新思维分析 热力图 以分类为例 02 国际象棋入门快易精 初级下法 棋子杀王 SCI拒稿重投 torch.manual_seed(seed)用法及注意事项 make_classification函数 杂志审稿人打分表参考 python+matplotlib绘图线条类型和颜色选择 Sobol全局灵敏性分析 np.transpose(),torch.permute(),tensor.permute() DTW(动态时间规整)算法原理与应用 第2期 分布迁移下的深度学习时间序列异常检测方法探究 2021-09-22
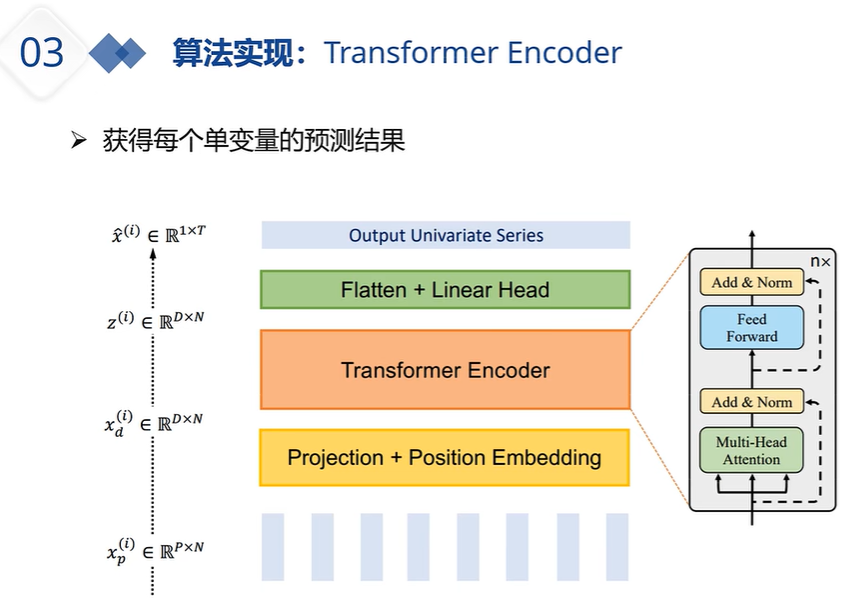
PatchTST:通道独立的时序Transformer
lmqljt · 2025-07-07 · via 博客园 - lmqljt

通道独立更大意义上是扩展数据集,提升模型泛化性能吧,也有几篇论文在讨论这个问题了。毕竟现在时序预测的一个瓶颈就是数据量上不去。

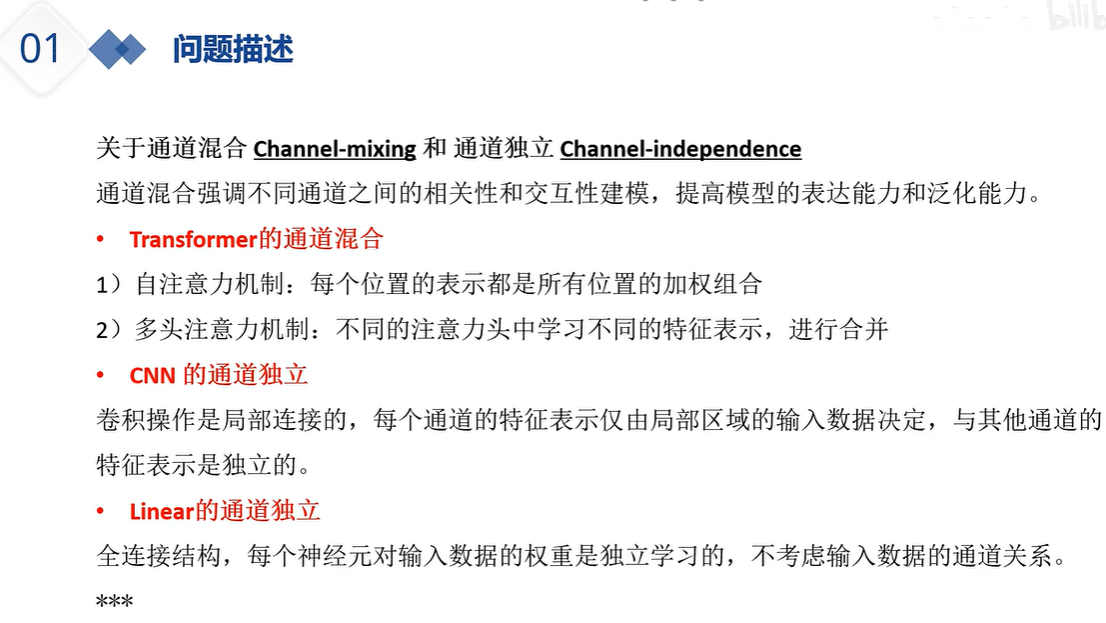
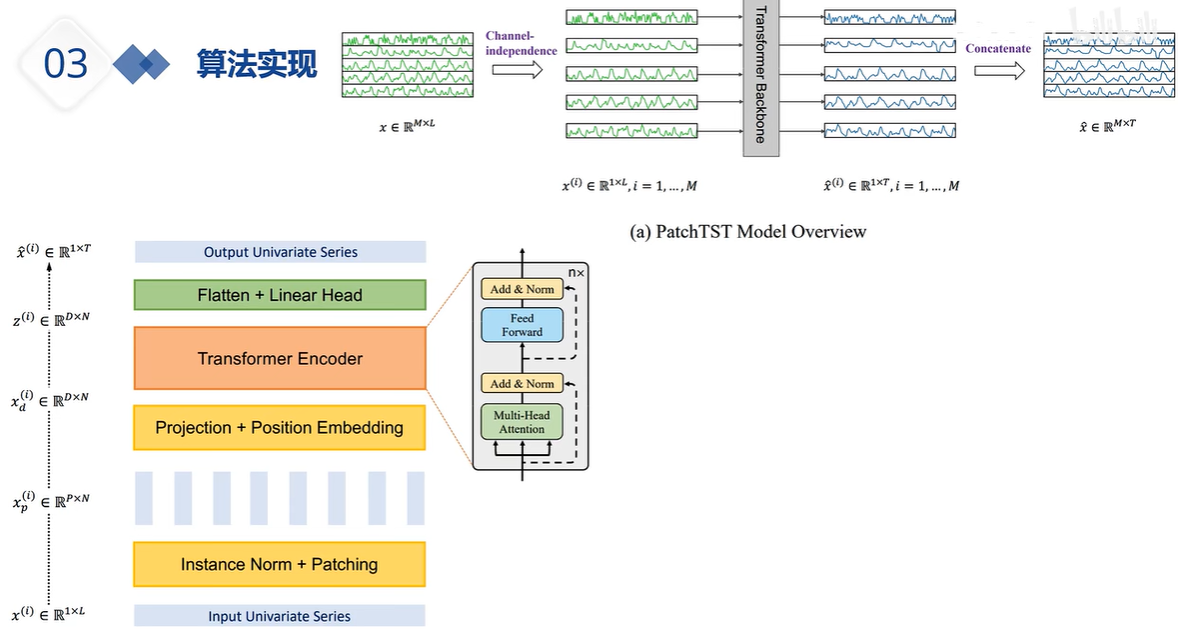
他指的这个通道说的就是特征,比如我有十四个特征不知道你有没有看过itansformer这篇文章,假如我的输入(32,96,14)这代表的是32个样本每个样本大小为96个历史长度,14个特征这样,通道独立说的就是进行一个转置(32,14,96)那么第一行代表的就是96个时间步的第一个特征,那么他做自注意力机制其实就是特征与特征,通道与通道之间做自注意力机制

而且他 每个通道共享transformer权重啊 这能算通道独立吗?对特征之间相关性不大的数据,特征独立反而可以避免模型因为特征之间复杂的相互关系学习不到而降低性能。大佬,我想问一下,用多变量预测单变量,既然是独立通道,那么每个特征又是怎么影响输出的呢?

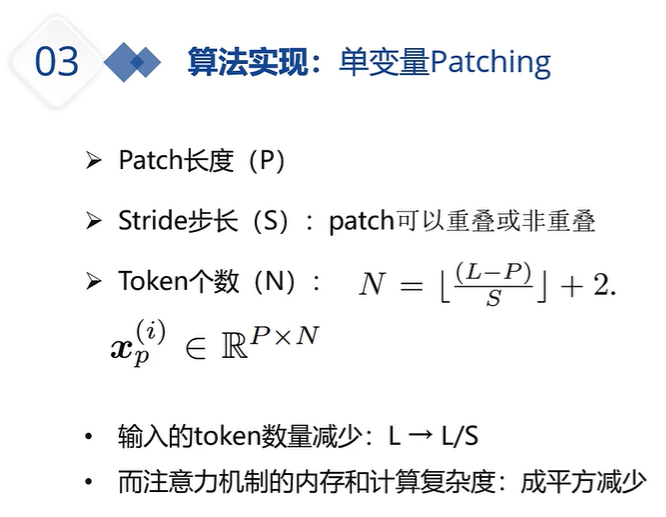
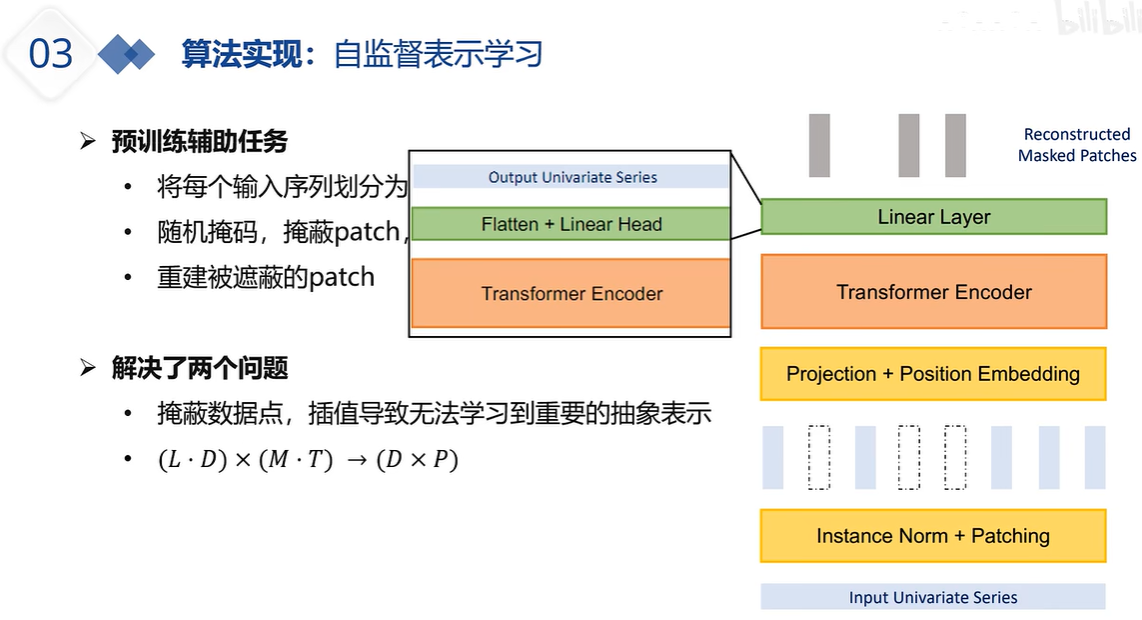
对数据patch处理后,数据点变成了数据段。这种情况下,数据输入到transformer前需要怎么处理呢,数据维度变了 

时序former的输入一般是(B,L,F),数据维度本身也是考虑了步长的

我的理解是,虽然数据点变成了数据段,升了一维,但由于通道独立,每个变量单独地进trans,因此又降了一维,一升一降就抵消了

我看了代码,patch之后,维度成了四维。然后其中一个维度和batch合并了,维度又还是三维了

x: 【bs x nvars x patch_num x d_model】->u: 【bs * nvars x patch_num x d_model】,意思就是将变量个数nvars与batchsize乘到了一起,即nvars变成了与batchsize同一级的参数,这样一来自注意力就不能跨变量了,就如同朴素的Transformer中自注意力无法跨batch一样。
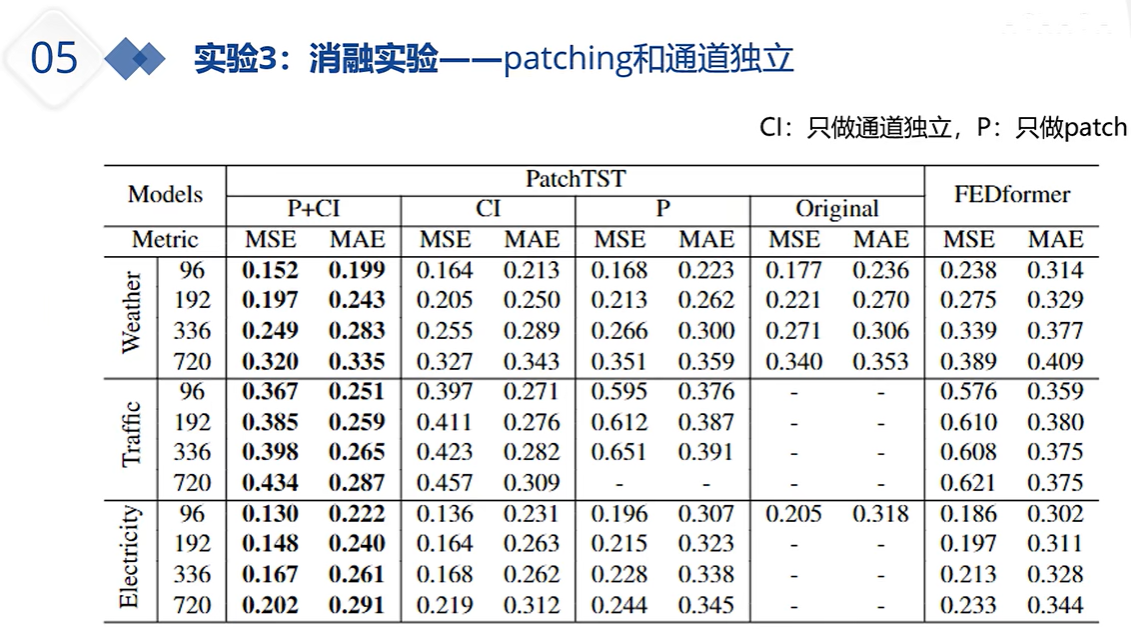
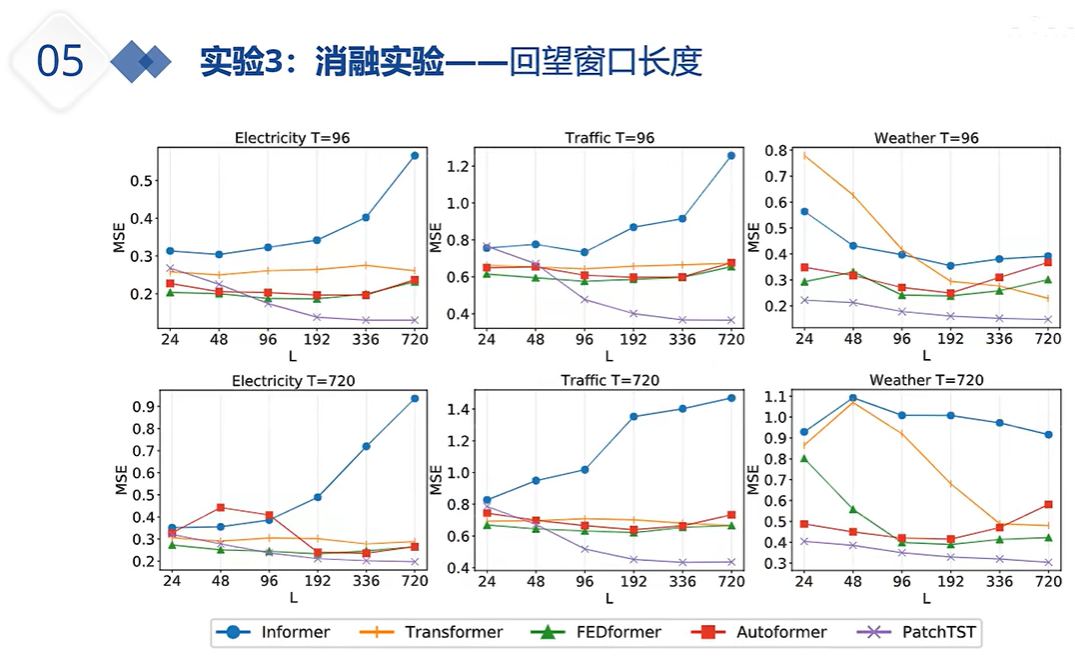
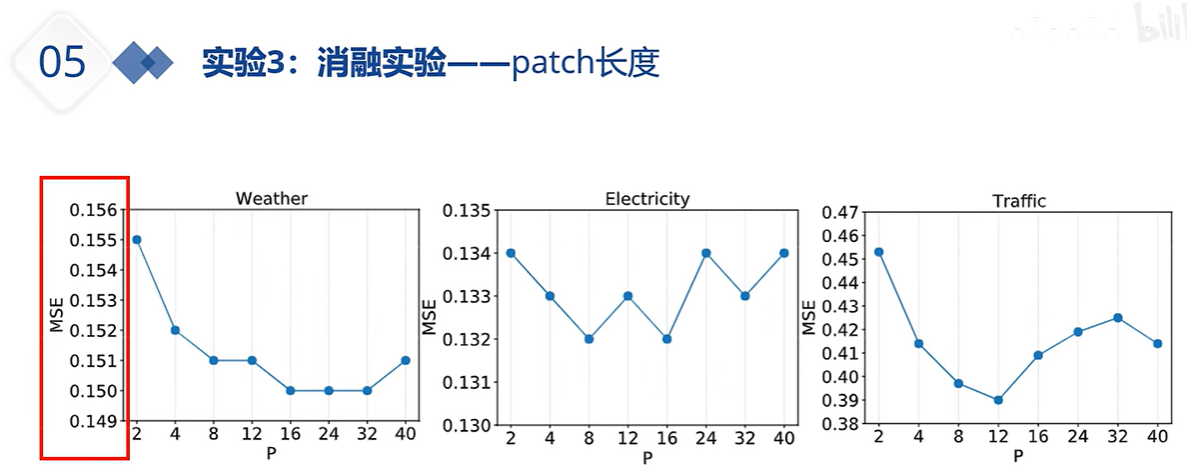
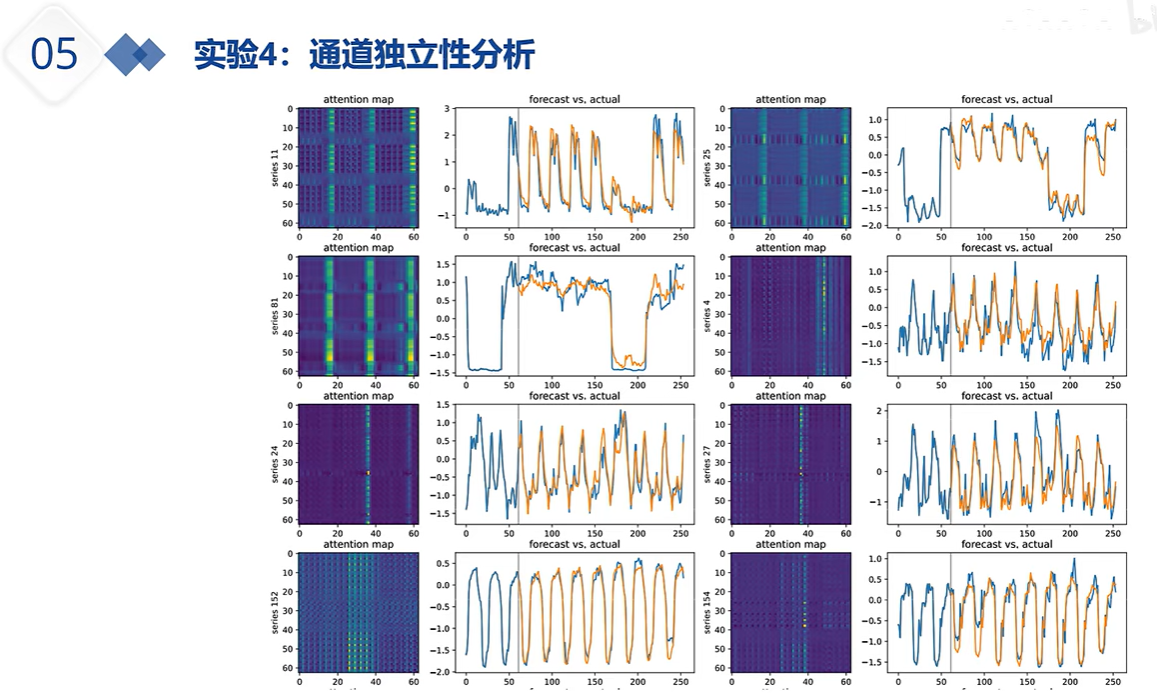
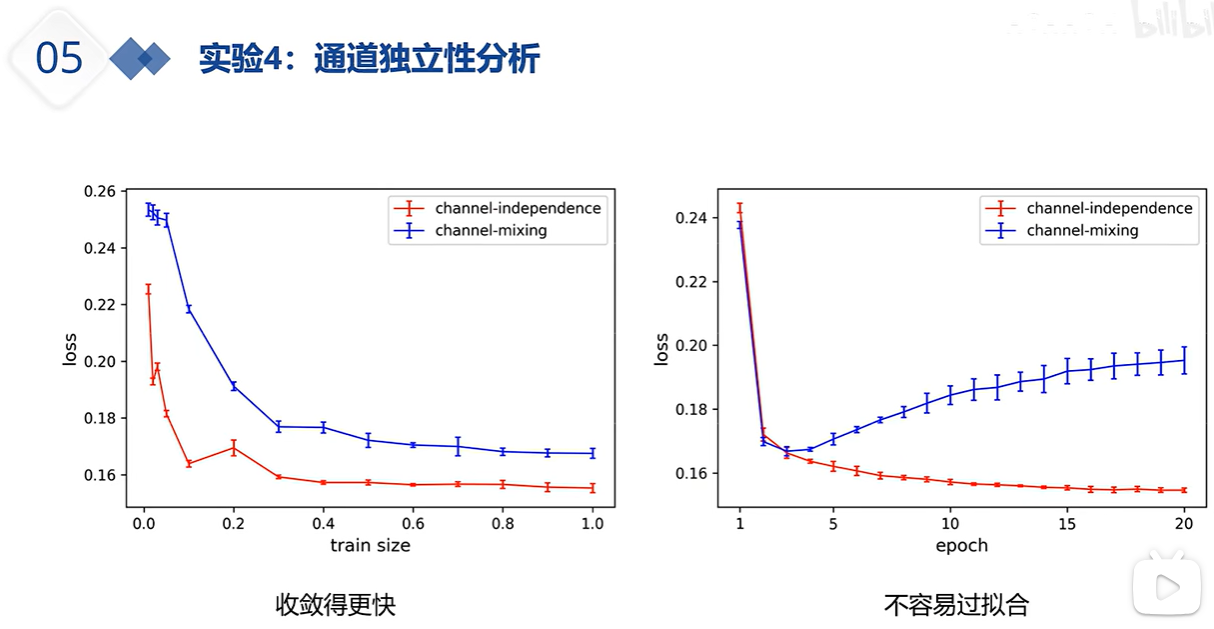
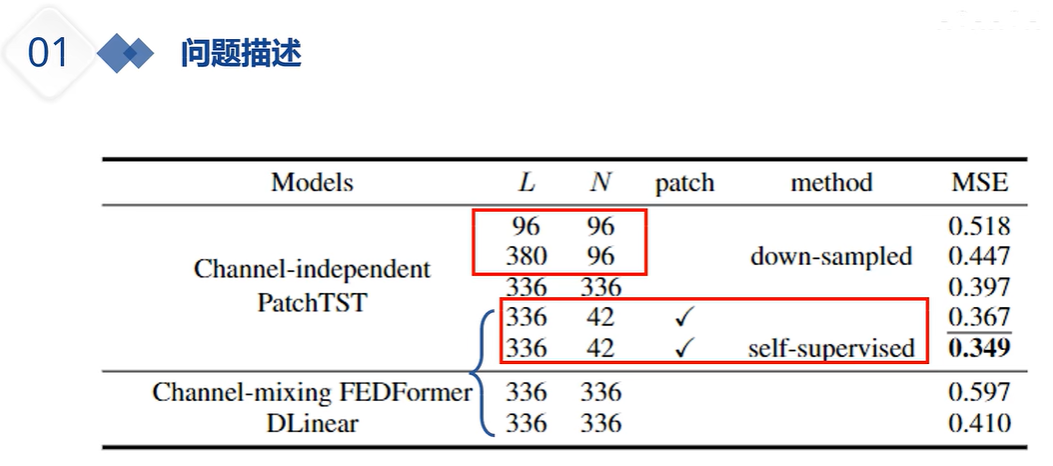
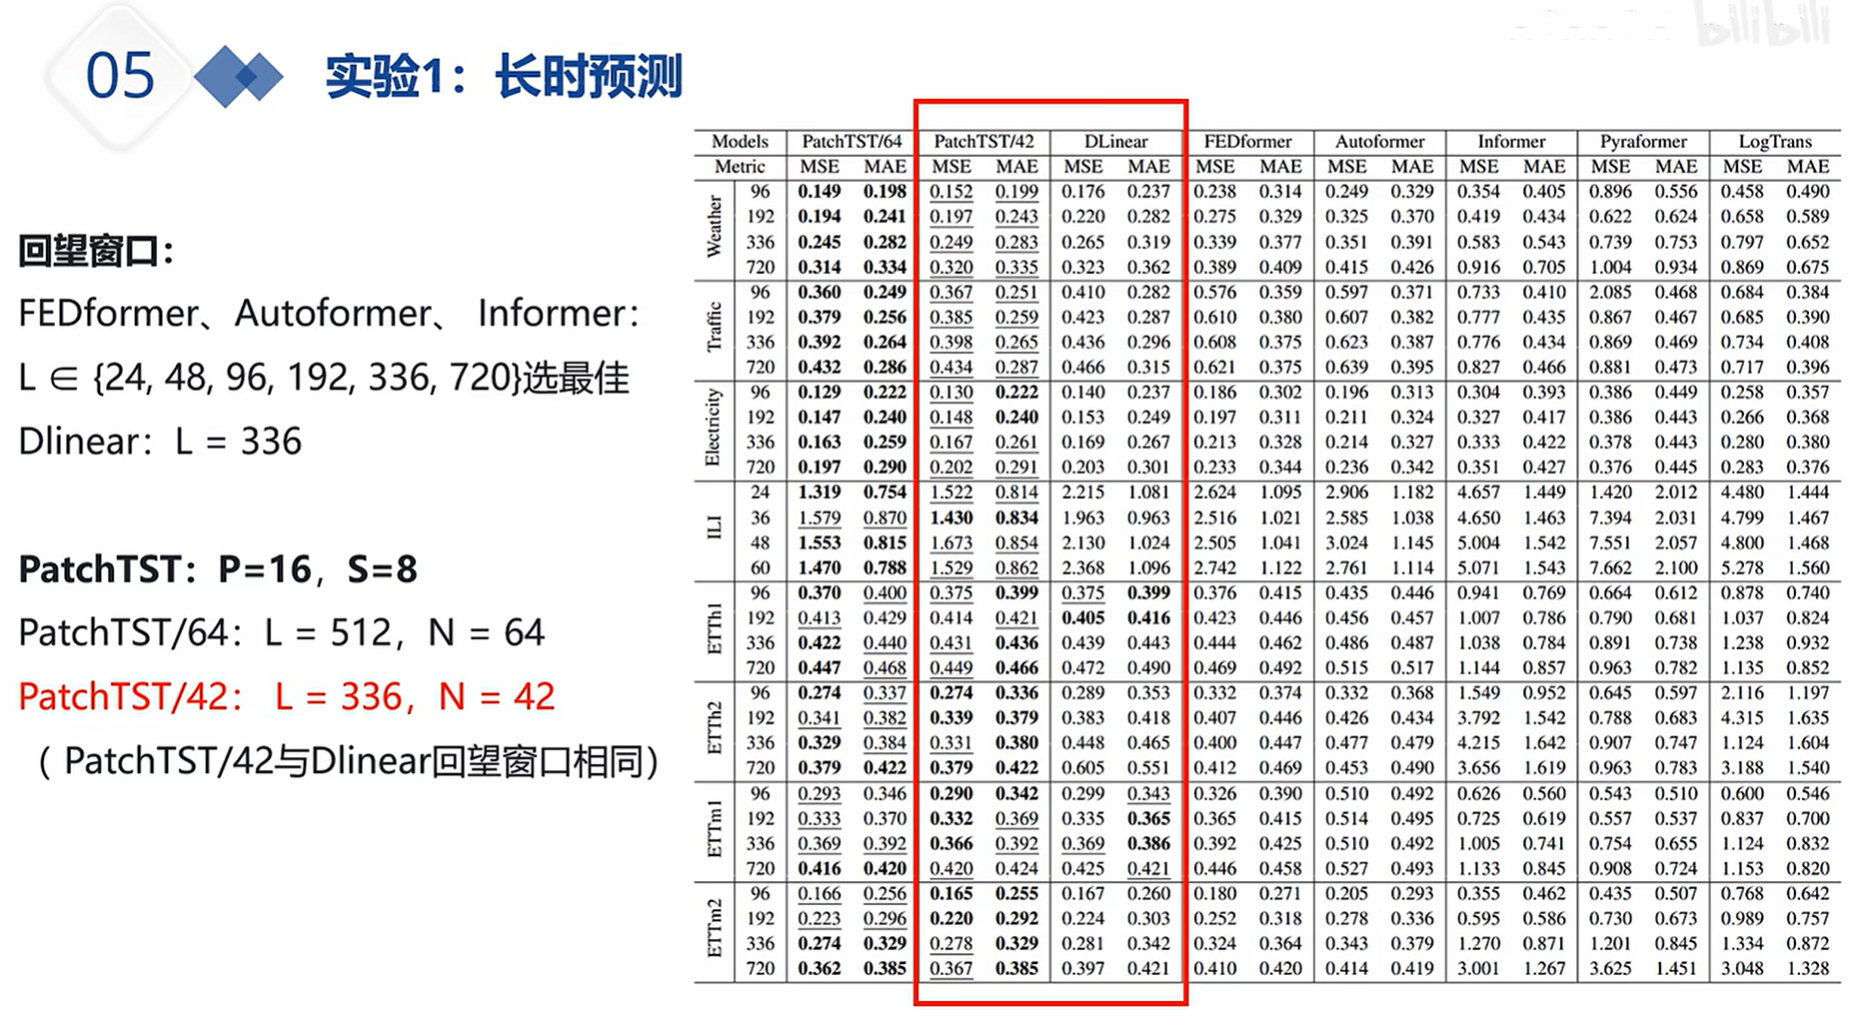
上图红线是通道独立 蓝线是通道混合;单通道 各个通道间的注意力相近,他们互现学习能让预测效果变得更好,但所有变量一起学习 可能学到的冗余错误信息比较多,导致最终预测效果变差。多通道信息混合从某种程度上说,影响/损害了注意力的效果;另一方面,独立的通道 或 通道独立能让模型个收敛的更快。切不容易过拟合。