惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Recent Announcements
博客园 - Franky
博客园 - 三生石上(FineUI控件)
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Apple Machine Learning Research
云风的 BLOG
云风的 BLOG
人人都是产品经理
人人都是产品经理
博客园 - 【当耐特】
L
LangChain Blog
Stack Overflow Blog
Stack Overflow Blog
H
Help Net Security
爱范儿
爱范儿
罗磊的独立博客
博客园_首页
美团技术团队
让小产品的独立变现更简单 - ezindie.com
月光博客
月光博客
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
量子位
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
博客园 - 叶小钗
V
Visual Studio Blog
T
Tailwind CSS Blog

博客园 - fariver

[PaperWritting] 多模态大模型架构图摘录 每日Paper - 2026-03-06 每日Paper | 2026年3月4日 [Paper Reading] Qwen3-VL-Embedding and Qwen3-VL-Reranker: A Unified Framework for State-of-the-Art Multimodal Retrieval and Ranking [PaperReading] OneSearch A Preliminary Exploration of the Unified End-to-End Generative Framework for E-commerce Search [PaperReading] OneRec Technical Report [Paper Reading] Tiger: Recommender Systems with Generative Retrieval [PaperReading] Generative Recommendation with Semantic IDs: A Practitioner’s Handbook [PaperReading] GME: Improving Universal Multimodal Retrieval by Multimodal LLMs [Paper Reading] UniME-V2: MLLM-as-a-Judge for Universal Multimodal Embedding Learning [PaperReading] UniME: Breaking the Modality Barrier: Universal Embedding Learning with Multimodal LLMs [PaperReading] Qwen2.5-VL Technical Report [PaperReading] DeepSeek-OCR: Contexts Optical Compression [PaperReading] SAIL-Embedding Technical Report: Omni-modal Embedding Foundation Model [PaperReading] VLM2Vec-V2: Advancing Multimodal Embedding for Videos, Images, and Visual Documents [PaperReading] REACT: SYNERGIZING REASONING AND ACTING IN LANGUAGE MODELS [PaperReading] MemGPT: Towards LLMs as Operating Systems [PaperReading] Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution [PaperReading] Mind Search: Mimicking Human Minds Elicits Deep AI Searcher [PaperReading] METAGPT: META PROGRAMMING FOR A MULTI-AGENT COLLABORATIVE FRAMEWORK
[PaperReading] VLM2VEC: TRAINING VISION-LANGUAGE MODELS F...
fariver · 2025-10-16 · via 博客园 - fariver

VLM2VEC: TRAINING VISION-LANGUAGE MODELS FOR MASSIVE MULTIMODAL EMBEDDING TASKS

link

TL;DR

Embedding模型是semantic语义相似性、信息检索与聚类等任务的关键模型。本工作针对embedding模型有三个contribution:

  1. 提出MMEB(大规模多模态embedding benchmark);
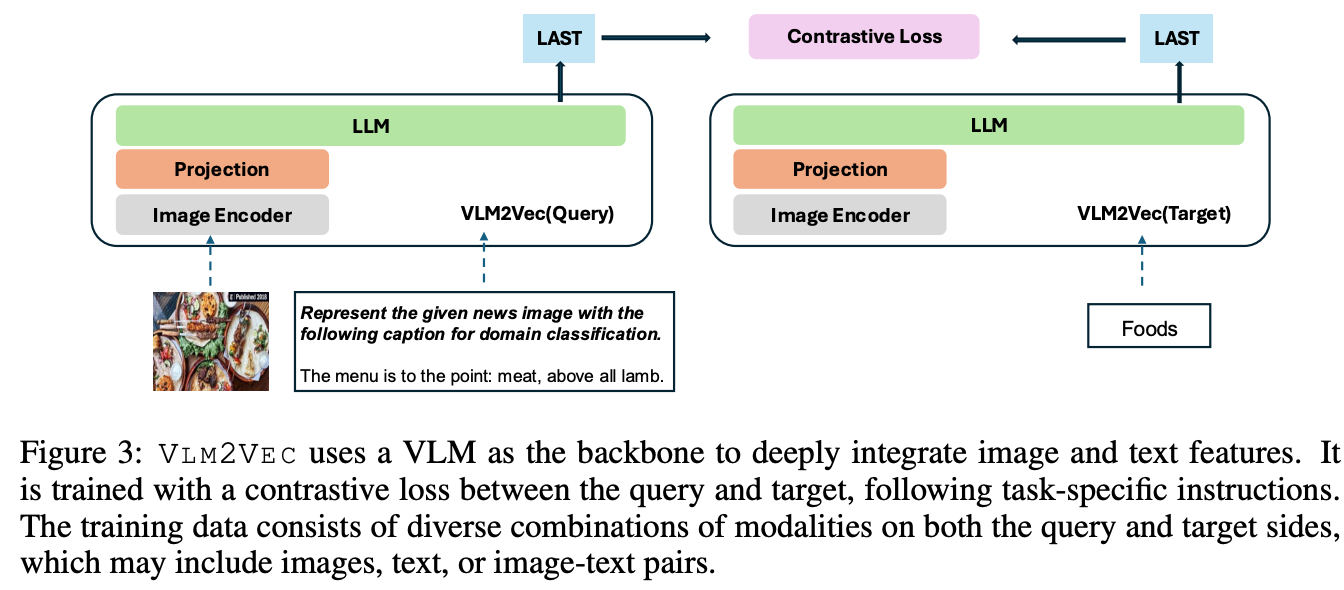
  2. VLM2VEC模型利用对比学习将任意VLM模型转为embedding模型;
  3. 效果上在MMEB benchmark上相对于已有方法;

Method

将query或者target输入VLM之后,将最后一层最后一个token取出作为embedding,通过以下公式来对齐query与target特征空间。
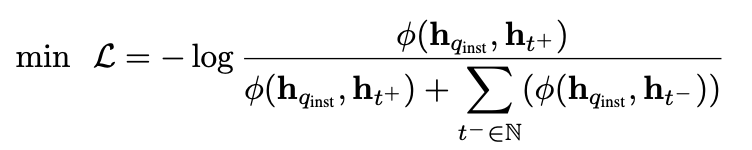
image
其中 \(h_{q}\)\(h_{t}\)分别为query与target,可以是图、文或者图文对。
image

Dataset

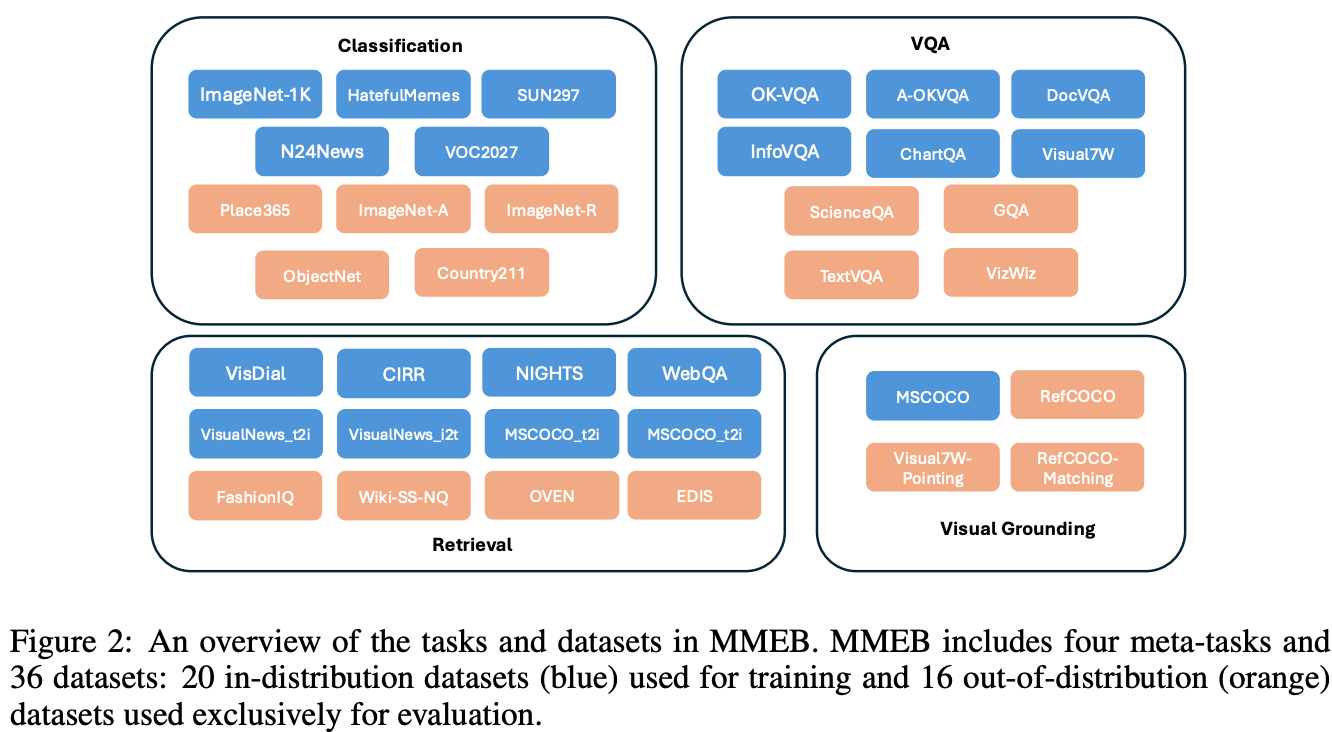
MMEB(massive multimodal embedding benchmark)
任务类型的图示说明
image

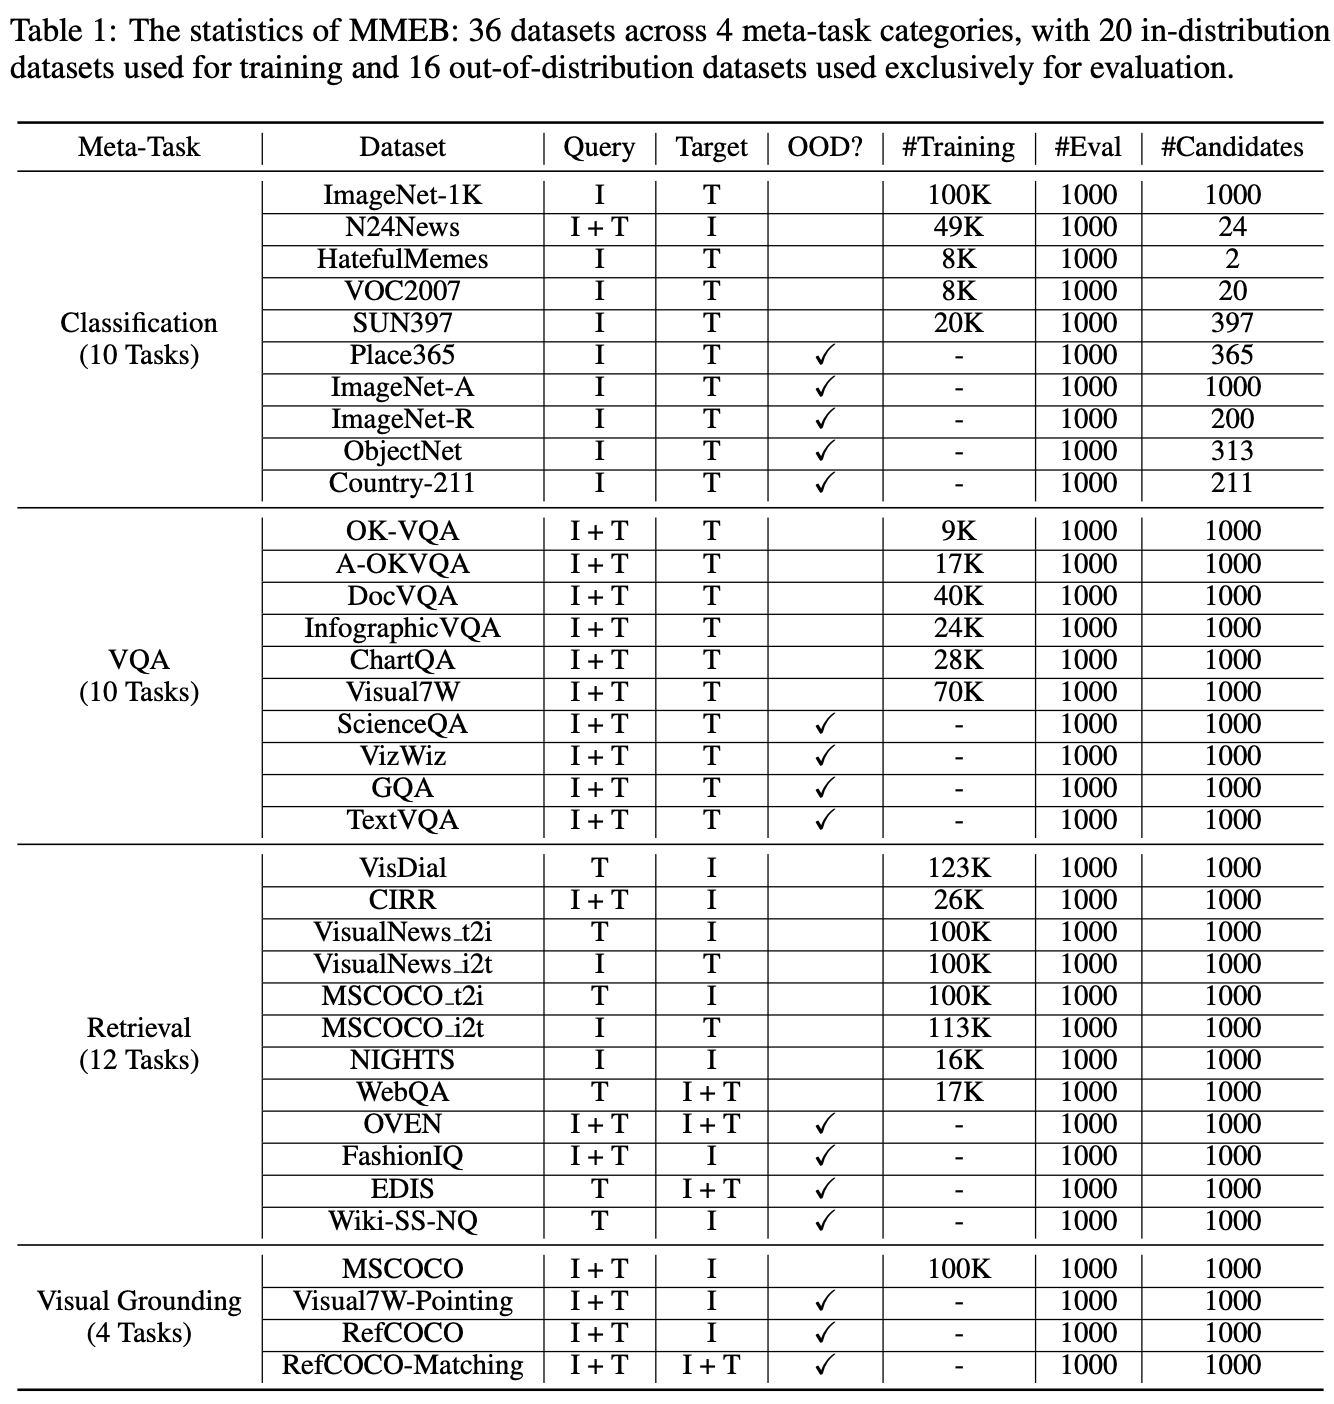
MMEB数据包含4个任务类别,总共36个数据集,以下表格与图示说明任务与子数据集之间的关系
image
image

Experiment

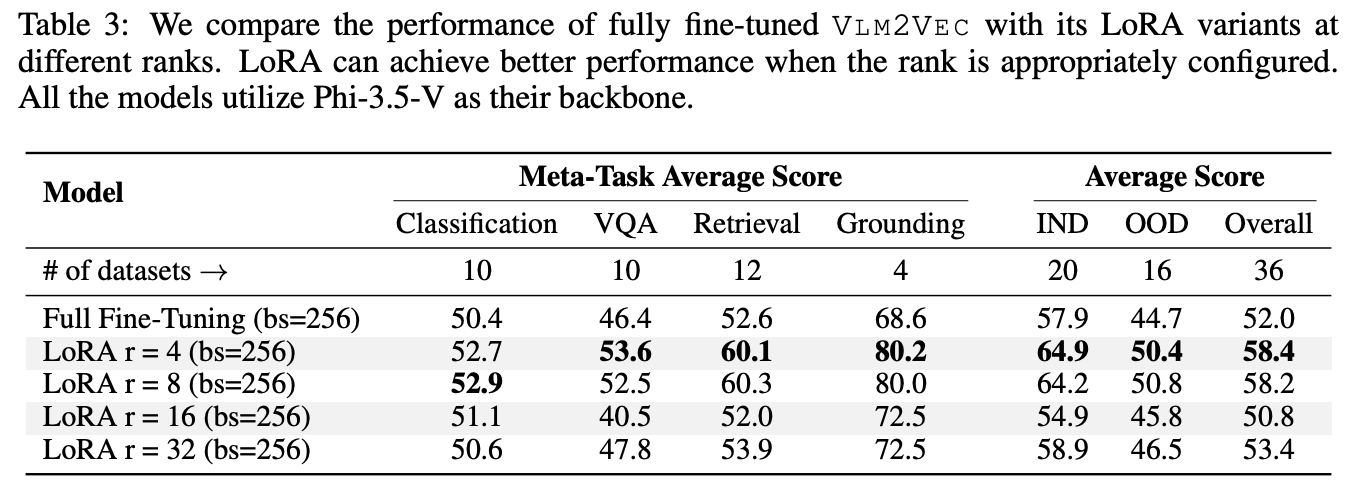
image

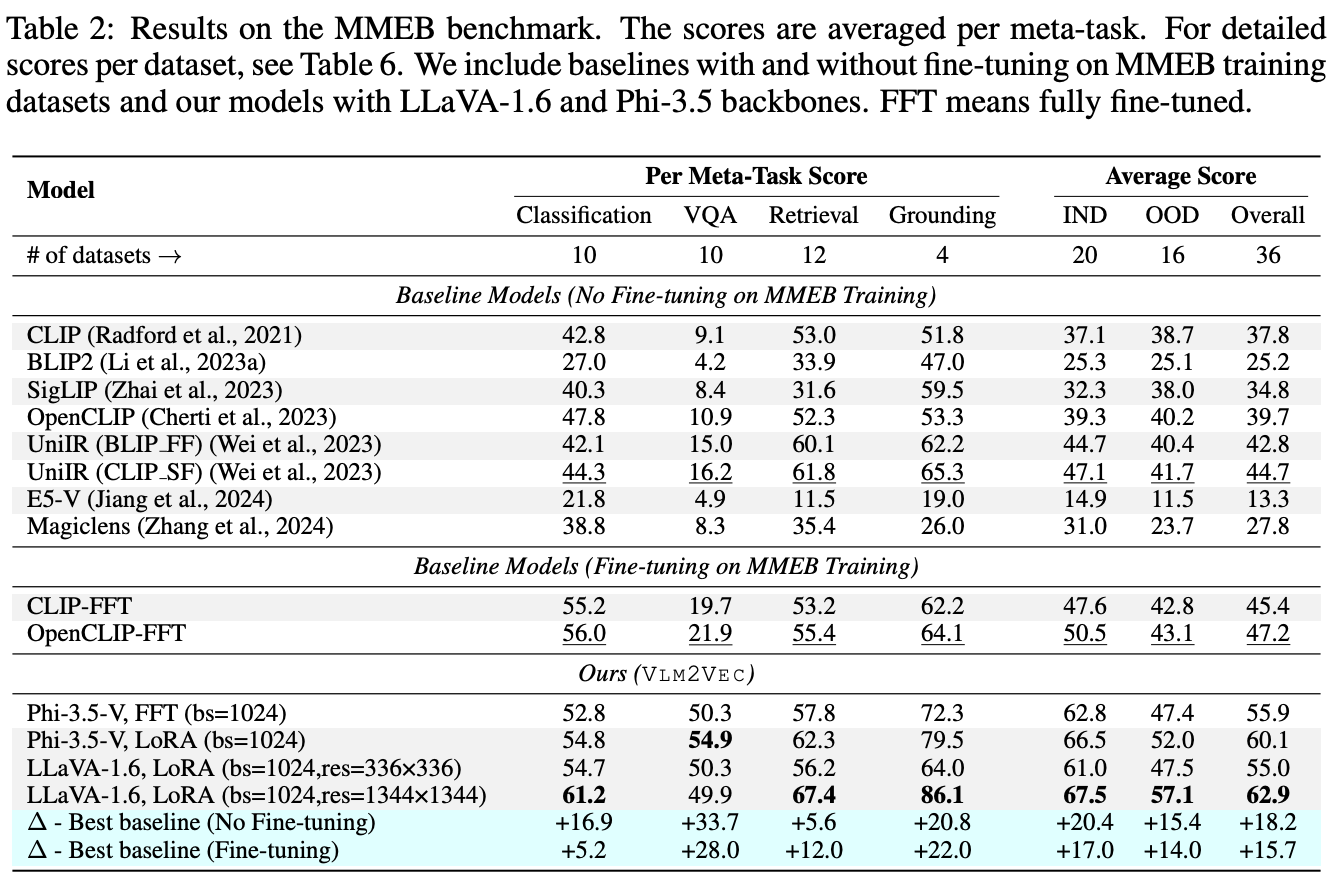
LoRA微调结果反而比全模型更好,一种高能性是LoRA参数量更少,不容易在Finetune数据集上过拟合。
image

Q&A

Q:VLM2Vec与普通VLM有什么区别?难道仅仅是会将embedding存出来?

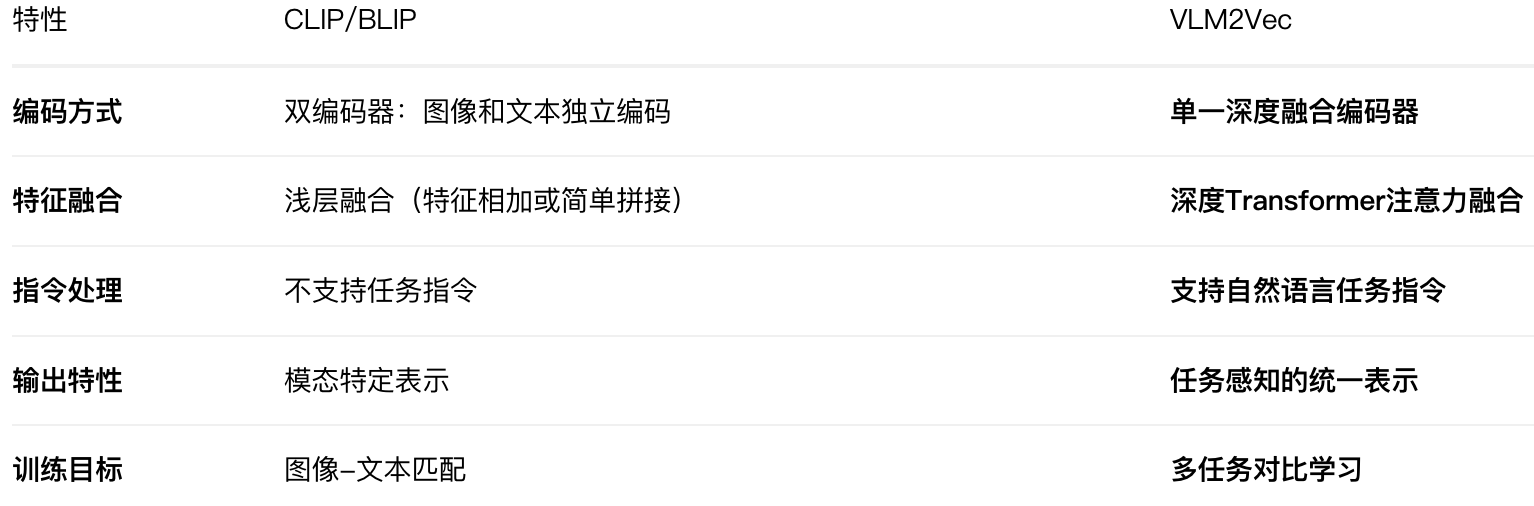
​​- 指令跟随能力​​:VLM2Vec能够理解和执行自然语言指令,根据不同的任务要求生成相应的嵌入表示,这是普通VLM不具备的专业化能力。
​- ​对比学习优化​​:通过大规模的对比学习训练,VLM2Vec的嵌入空间被优化用于相似性计算和检索任务,而普通VLM的输出空间主要针对生成任务优化。

Q:与CLIP/BLIP这类多模态模型的区别?
image

Q:query与target embedding为什么是从VLM的最后一层的最后一个token?

  • 信息完整性​​:最后一个token在Transformer架构中聚合了前面所有token的信息
  • 表示一致性​​:确保不同模态的输入都能转化为统一格式的向量表示

Q:为什么负样本存在一定噪声,加大Batch就可以缓解?

  • 负样本存在噪声的原因:标注错误、语义模糊
  • 为什么大BatchSize能够缓解:更大的batch提供更多随机负样本,降低个别噪声样本的影响

Q:阅读3.2章节,说明如何通过GradCache增大BatchSize?与梯度累积有什么区别?

GradCache

  • 梯度累积:​​解决的是​​前向传播和反向传播​​过程中的内存瓶颈。它通过“化整为零”的策略,将一个大批次分割成多个小批次顺序处理,并累积梯度,最终进行一次参数更新,从而​​模拟​​大批次训练的效果。
  • ​​GradCache:​解决的是​​对比学习任务本身​​的内存瓶颈。在对比学习中,计算损失需要在一个批次内进行大量的样本间交互(如计算所有样本对的相似度)。GradCache通过“解耦计算依赖”的策略,将嵌入表示的计算与对比损失的计算分离,从而真正实现​​超大批次​​的对比学习。

总结与思考

方法相对而言比较容易想到,建立了比较完善的Benchmark全面证明方法的有效性。

相关链接

https://zhuanlan.zhihu.com/p/1918974886321305223