






原文:https://www.cnblogs.com/yxysuanfa/p/19125864
附 安装
1、直接下载对应版本的DLL 文件,并复制到本机相关目录
vector.dll → C:\Program Files\PostgreSQL\17\lib\
vector.control → C:\Program Files\PostgreSQL\17\share\extension\
vector--*.sql → C:\Program Files\PostgreSQL\17\share\extension\
*.h → C:\Program Files\PostgreSQL\17\include\server\extension\vector\
附PG17的链接:https://gitee.com/xianmin_coding/postgresql-17-pgvector-windows-x64
2、下载后编译;
前言
这是我在这个网站整理的笔记,有错误的地方请指出,关注我,接下来还会持续更新。作者:神的孩子都在歌唱
pgvector 是 PostgreSQL 的开源扩展,用于在数据库中存储和处理向量数据,特别是高维嵌入向量(embedding)。
功能与特点
启用扩展:
CREATE EXTENSION IF NOT EXISTS vector;验证安装:
SELECT * FROM pg_extension WHERE extname='vector';成功后即可在表中创建向量列。

vector 或 vector(n),其中 n 是向量维度。CREATE TABLE documents (
id BIGSERIAL PRIMARY KEY,
embedding VECTOR(3) -- 假设嵌入向量是 3 维
);小贴士:向量列的维度必须固定,查询和索引时保持一致。
INSERT INTO documents (embedding) VALUES ('[1,2,3]'), ('[4,5,6]'),('[4,0,5]');-- 使用 L2 距离
SELECT id,embedding <-> '[1,2,3]' as score,embedding FROM documents ORDER BY embedding <-> '[1,2,3]' LIMIT 5;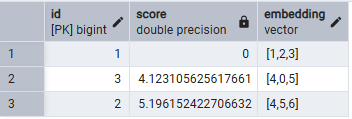
根据score的得分,就能查询出相近的向量,值越小代表越相似,算法如下
公式
d ( q , v ) = ∑ i = 1 n ( q i − v i ) 2 d(q, v) = \sqrt{\sum_{i=1}^{n} (q_i - v_i)^2} d(q,v)=i=1∑n(qi−vi)2
计算例子
假设查询向量 (q = [1,2,3]),表中某行向量 (v = [4,0,5]):
d
(
q
,
v
)
=
(
1
−
4
)
2
+
(
2
−
0
)
2
+
(
3
−
5
)
2
=
9
+
4
+
4
=
17
≈
4.123
d(q, v) = \sqrt{(1-4)^2 + (2-0)^2 + (3-5)^2} = \sqrt{9 + 4 + 4} = \sqrt{17} \approx 4.123
d(q,v)=(1−4)2+(2−0)2+(3−5)2=9+4+4=17≈4.123
| 操作符 | 相似度度量 | 说明 | 推荐场景 | 值越小代表 |
|---|---|---|---|---|
<-> |
欧氏距离 (L2 Distance) | 计算两个向量之间的几何距离 | 图像、音频、地理数据检索 | 越相似 |
<#> |
负内积 (- Inner Product) | 取负号后的内积,用于最大内积搜索 | 推荐系统、模型打分 | 越相似 |
<=> |
余弦距离 (Cosine Distance) | 1 - 余弦相似度,对向量长度不敏感 | 文本语义检索、跨语言向量匹配 | 越相似 |
后面会出一篇关于这些运算符计算使用的文章
# 向现有表中添加向量列
ALTER TABLE items ADD COLUMN embedding vector(3);
# 更新向量
UPDATE items SET embedding = '[1,2,3]' WHERE id = 1;
# 删除向量
UPDATE items SET embedding = '[1,2,3]' WHERE id = 1;使用 pgvector-python 或 psycopg2 处理向量:
import numpy as np
import psycopg2
from pgvector.psycopg2 import register_vector
# 连接数据库
conn = psycopg2.connect(host='192.168.1.101', dbname='test-agent', user='postgres', password='123456', port=5433)
register_vector(conn)  # 注册 vector 类型
cur = conn.cursor()
# 插入示例向量
embedding = np.random.rand(3).astype('float32')
print(embedding)
cur.execute(
"INSERT INTO documents (embedding) VALUES (%s)",
(embedding,)  # 注意这里的逗号,确保是元组格式
)
conn.commit()
# 查询最近邻
query_embedding = np.random.rand(3).astype('float32')
print(query_embedding)
cur.execute(
"SELECT id, embedding,embedding <-> %s as score  FROM documents ORDER BY embedding <-> %s LIMIT 5",
(query_embedding, query_embedding,)
)
rows = cur.fetchall()
for r in rows:
print(r)
cur.close()
conn.close()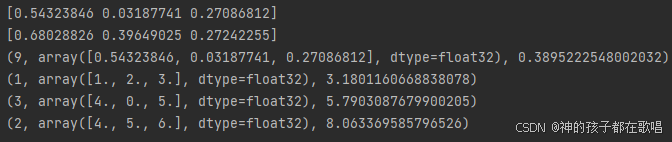
作者:神的孩子都在歌唱
本人博客:https://blog.csdn.net/weixin_46654114
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。