


本节将系统讲解大数据分析的完整流程,包括数据采集、预处理、存储管理、分析挖掘与结果可视化等核心环节。与此同时,我们还将对主流数据分析工具进行横向对比,帮助读者根据实际需求选用最合适的工具,提升数据价值挖掘的效率与深度。
数据采集是大数据分析的起点,旨在通过多种手段高效获取所需的原始数据,为后续处理与分析奠定基础。常见的数据源可分为内部数据与外部数据两大类:内部数据主要包括企业业务数据、交易记录、客户信息等,具有较高的相关性和准确性;外部数据则涵盖社交媒体动态、公开数据集、传感器数据等,能够为分析提供更丰富的视角与补充信息。
为确保数据的全面性与可靠性,常用的数据采集方式包括网络爬虫、API接口调用、传感器数据实时采集及人工数据录入等方法。根据数据类型和应用场景的不同,往往需要灵活组合多种手段,以构建多源异构的数据基础。
常见的数据采集方式包括:
如下图所示:
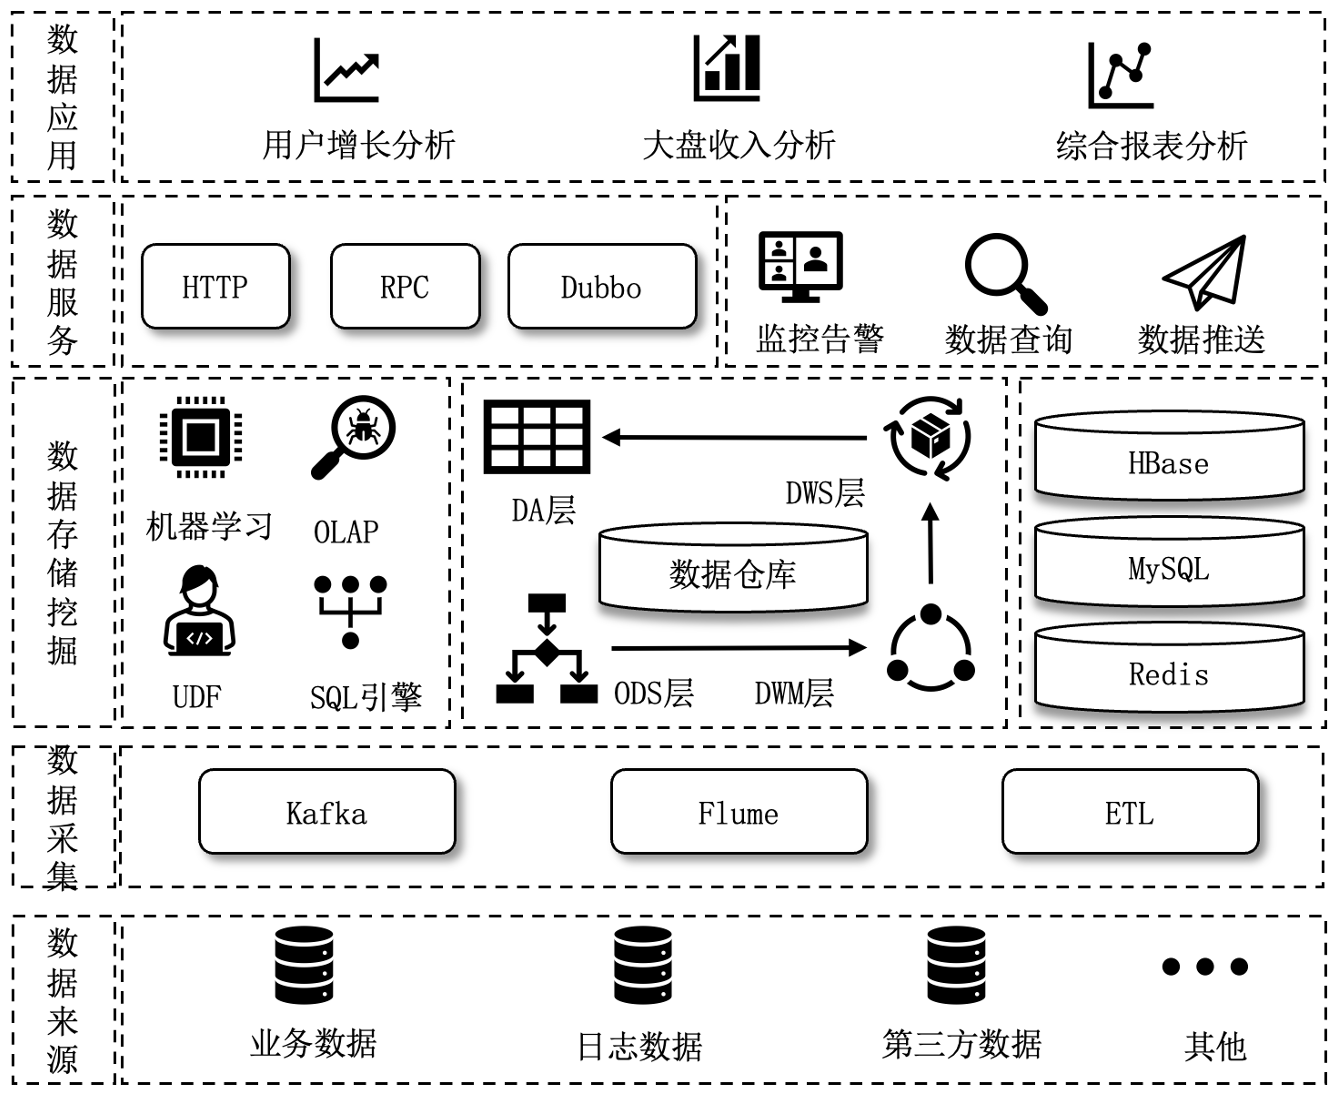
数据处理是确保数据质量与一致性的关键步骤,旨在清洗原始数据中的噪声、错误和重复项,为后续分析奠定坚实基础。作为大数据分析流程中的核心环节,数据处理的质量直接影响分析结果的准确性和可靠性。
在处理过程中,常用的技术工具包括Hadoop的MapReduce框架、Spark SQL等,这些平台提供了丰富的函数库和高效的数据清洗方法,能够支撑大规模数据的快速处理。与此同时,机器学习方法也被广泛应用于数据处理环节,以提升自动化水平和精度。例如,聚类算法可以用于自动检测数据中的异常值,回归模型则可用于智能填补缺失数据。这些技术手段显著降低了人工干预的需求,提升了整个数据处理流程的效率和效果。
数据存储是对采集到的数据进行分类管理的关键环节,旨在为后续的数据处理与分析提供高效、可靠的支撑。根据数据的结构化程度和应用需求,可选择不同的数据存储方案。
结构化数据通常存储在关系型数据库中,如MySQL。这类数据库通过表格化的数据模型、SQL查询语言与事务机制,保障了数据的一致性与完整性,适用于需要复杂查询、连接操作及事务支持的应用场景。
非结构化数据更适合存储在NoSQL数据库中,如HBase。NoSQL系统能够灵活处理文档、图像、日志等多种数据格式,支持弹性Schema设计与水平扩展,广泛应用于大规模数据存储、实时数据处理和高可用性场景。
在应对海量数据时,分布式存储系统显得尤为重要。Hadoop的分布式文件系统(HDFS)作为典型代表,通过数据分块并分散存储于多个节点,大幅提升了存储容量、访问速度与系统容错能力,即便部分节点故障也能实现数据自动恢复。
选择合适的存储方案时,需综合考虑数据类型、访问频率与存储成本。例如,针对频繁访问的热数据,可选用高性能存储方案,如固态硬盘(SSD)或内存数据库(如Redis),以实现高速读写;而对于访问频率较低的冷数据,则更适合采用成本更优的云存储解决方案,以提高长期存储的经济性。
数据备份与恢复机制同样是数据存储中不可忽视的重要保障,有效防范数据丢失或损坏的风险。常见备份策略包括:
此外,通过引入定期备份、异地备份与快照技术,可进一步提升数据的安全性与可恢复性。多数云存储服务商还提供内置的自动备份与灾难恢复功能,为数据安全保驾护航。
数据分析是通过多种算法与工具,对数据进行深入挖掘与解读,旨在提取有价值的信息与洞察,辅助科学决策。根据分析目标的不同,数据分析方法可分为描述性分析、诊断性分析、预测性分析和规范性分析,每种方法各具特色与应用场景。
在实际数据分析过程中,选择合适的方法与工具至关重要。对于大规模数据处理,分布式计算框架(如Hadoop、Spark)可显著提升计算效率与扩展能力;对于复杂分析任务,机器学习与深度学习算法(如线性回归、决策树、支持向量机、神经网络等)能够实现深层次的数据挖掘与洞察。
数据可视化是通过图表和视觉呈现方式,将复杂的数据分析结果直观表达,帮助用户更高效地理解数据内涵。作为数据分析流程中的关键环节,数据可视化不仅有助于识别模式和趋势,还能有效传达分析结论,辅助科学决策。
常用的数据可视化工具包括:
在可视化过程中,合理选择图表类型和设计风格至关重要:
良好的图表设计应遵循以下原则:
此外,数据可视化设计还需充分结合用户需求与应用场景:
企业管理
数据研究
综上所述,数据可视化不仅是将数据转化为视觉表现的过程,更是提升数据价值、增强分析洞察力与决策支持能力的重要手段。通过精心选择合适的图表类型与设计策略,结合具体的使用场景,数据可视化可以显著提升数据分析的效果与影响力。
分类算法是一类典型的有监督学习方法,旨在基于已有标注数据训练模型,以对新数据进行类别预测。分类技术广泛应用于金融风险评估、客户管理、医疗诊断等领域。常见的分类算法包括决策树(Decision Tree)、支持向量机(Support Vector Machine, SVM)、朴素贝叶斯(Naive Bayes)等,各有特点与适用场景。
分类算法的选择应综合考虑数据规模、特征维度、数据分布特性及应用需求,合理搭配模型可显著提升分类效果与应用价值。
预测算法是一类有监督学习方法,旨在基于已有数据集训练模型,以预测未来的数值或类别。预测技术在金融、医疗、零售等多个领域有着广泛应用,如股票价格预测、销售量预测等。常见的预测算法包括线性回归、时间序列分析、决策树回归等。
预测算法的选择应根据数据特性(如线性或非线性)、噪声水平、数据量大小等因素综合考虑,从而提高模型的预测准确性和实用价值。
聚类分析是一种无监督学习算法,旨在根据数据自身的特征将数据划分为相似的组别。与监督学习不同,聚类不依赖于标记数据集,而是自动识别数据中的潜在模式。聚类分析广泛应用于市场细分、社交网络分析、图像处理等领域。常见的聚类算法包括K-means、层次聚类和密度聚类等。
聚类算法的选择需根据数据的特点、簇的形状、噪声水平等因素进行合理评估,从而实现最优的聚类效果。
关联分析是一种无监督学习算法,旨在发现数据中的潜在关联关系。通过分析频繁项集,关联分析揭示了项集之间的规律性关系。该方法广泛应用于零售业、金融业等领域,如购物分析和欺诈检测。常见的关联分析算法包括Apriori和FP-Growth等。
关联分析不仅在单一场景下有效,在实际应用中,往往需要将多种算法结合使用以提升分析效果。例如,市场细分中,首先使用聚类算法对客户进行分群,再利用分类算法细分每个群体,最后通过关联分析发现群体间的关联关系。综合运用这些算法,可以全面深入地挖掘数据中的知识和价值。
在实际数据分析中,常常需要将多种数据挖掘算法结合使用,以获得更全面的洞察。例如,在市场细分中,首先可以使用聚类算法将客户划分为不同的群体;接着,使用分类算法对每个群体进行进一步细分,以识别不同类别之间的差异和特点;最后,运用关联分析算法发现各群体之间的潜在关系,如商品购买模式或消费行为的相互影响。
通过这种综合应用,能够更深入地挖掘数据中的潜在价值,不仅提高了分析的精度和效率,还能帮助企业在复杂的业务环境中做出更加科学和个性化的决策。例如,电商平台可以结合这些算法优化推荐系统、精准营销以及库存管理,从而提升用户体验和增加销售额。
决策树是一种常用于分类和回归任务的监督学习算法。它通过递归划分数据集,构建一棵树状结构,节点代表特征的判定,而叶子节点则表示最终的决策结果。决策树的关键在于选择最优的划分特征,常用的划分标准包括信息增益、信息增益率和基尼指数。
决策树算法的优点在于其易于理解和可解释性强,但它也容易受到过拟合的影响,因此通常需要通过剪枝或其他方法进行优化。
实现示例代码如下:
public class JavaDecisionTreeClassificationExample {

  public static void main(String[] args) {

    SparkConf sparkConf = new SparkConf()
        .setAppName("JavaDecisionTreeClassificationExample")
        .setMaster("local");
    JavaSparkContext jsc = new JavaSparkContext(sparkConf);

    // 加载并解析数据文件
    String datapath = "data/mllib/sample_libsvm_data.txt";
    JavaRDD<LabeledPoint> data = MLUtils
        .loadLibSVMFile(jsc.sc(), datapath).toJavaRDD();
    // 将数据分割成训练集和测试集(30%作为测试集)
    JavaRDD<LabeledPoint>[] splits = data.randomSplit(new double[]{0.7, 0.3});
    JavaRDD<LabeledPoint> trainingData = splits[0];     // 训练数据
    JavaRDD<LabeledPoint> testData = splits[1];         // 测试数据

    // 设置参数
    // 空的categoricalFeaturesInfo表示所有特征都是连续的
    int numClasses = 2;
Map<Integer, Integer> categoricalFeaturesInfo = new HashMap<>();
// 用于决策树节点划分的不纯度度量标准
String impurity = "gini";
// 决策树的最大深度
int maxDepth = 5;
// 用于表示特征的桶的数量
    int maxBins = 32;

    // 训练一个用于分类的决策树模型
    DecisionTreeModel model = DecisionTree
        .trainClassifier(trainingData, numClasses,
      categoricalFeaturesInfo, impurity, maxDepth, maxBins);

    // 在测试实例上评估模型并计算测试误差
    JavaPairRDD<Double, Double> predictionAndLabel =
      testData.mapToPair(p ->
          new Tuple2<>(model.predict(p.features()), p.label()));
    double testErr =
      predictionAndLabel.filter(pl -> !pl._1().equals(pl._2()))
          .count() / (double) testData.count();

    System.out.println("Test Error: " + testErr);
    System.out.println("Learned classification tree model:\n"
        + model.toDebugString());

    // 保存和加载模型
    model.save(jsc.sc(), "target/tmp/myDecisionTreeClassificationModel");
    DecisionTreeModel sameModel = DecisionTreeModel
      .load(jsc.sc(), "target/tmp/myDecisionTreeClassificationModel");
  }
}
随机森林是一种集成学习方法,通过构建多个决策树来提高模型的预测性能。它通过引入随机性来解决决策树易过拟合的问题,具体体现在两个方面:
适用场景
随机森林特别适用于以下应用场景:
随机森林的优势在于其高准确性、鲁棒性以及对过拟合的有效抑制,使其在许多实际应用中广泛使用。
实现示例代码如下:
public class JavaRandomForestClassificationExample {
  public static void main(String[] args) {
    // 创建Spark应用的配置对象,设置应用名称和运行模式(本地模式)
    SparkConf sparkConf = new SparkConf()
        .setAppName("JavaRandomForestClassificationExample")
        .setMaster("local");
    // 创建JavaSparkContext对象,用于与Spark集群进行交互
    JavaSparkContext jsc = new JavaSparkContext(sparkConf);

    // 加载并解析数据文件
    String datapath = "data/mllib/sample_libsvm_data.txt"; // 数据文件路径
    JavaRDD<LabeledPoint> data = MLUtils
        .loadLibSVMFile(jsc.sc(), datapath).toJavaRDD(); // 读取数据并转换为JavaRDD

    // 将数据随机分割为训练集和测试集(70%用于训练,30%用于测试)
    JavaRDD<LabeledPoint>[] splits = data.randomSplit(new double[]{0.7, 0.3});
    JavaRDD<LabeledPoint> trainingData = splits[0];     // 训练数据
    JavaRDD<LabeledPoint> testData = splits[1];         // 测试数据

    // 训练一个随机森林分类模型
    // 空的categoricalFeaturesInfo表示所有特征都是连续的
    int numClasses = 2; // 类别数,二分类问题
    // 特征信息,这里为空,表示所有特征都是连续的
    Map<Integer, Integer> categoricalFeaturesInfo = new HashMap<>();
    int numTrees = 3; // 树的数量,实际应用中应该更多
    String featureSubsetStrategy = "auto"; // 特征子集策略,让算法自动选择
    String impurity = "gini";     // 用于树节点划分的不纯度度量标准
    int maxDepth = 5;            // 树的最大深度
    int maxBins = 32;             // 用于表示特征的桶的数量
    int seed = 12345;             // 随机种子,用于结果的可重复性

    // 使用训练数据训练随机森林模型
    RandomForestModel model = RandomForest
        .trainClassifier(trainingData, numClasses,
              categoricalFeaturesInfo, numTrees,
              featureSubsetStrategy,
              impurity, maxDepth, maxBins,
              seed);
    // 在测试数据上评估模型,并计算测试误差
    // 将测试数据的特征和模型预测的标签组合在一起
    JavaPairRDD<Double, Double> predictionAndLabel =
      testData.mapToPair(p ->
          new Tuple2<>(model.predict(p.features()), p.label()));
    // 计算测试误差
    double testErr =
      predictionAndLabel.filter(pl -> !pl._1().equals(pl._2()))
          .count() / (double) testData.count();
    // 打印测试误差和学习到的随机森林模型的详细信息
    System.out.println("Test Error: " + testErr);
    System.out.println("Learned classification forest model:\n"
        + model.toDebugString());
    // 将模型保存到指定路径
    model.save(jsc.sc(), "target/tmp/myRandomForestClassificationModel");
    // 从指定路径加载模型
    RandomForestModel sameModel = RandomForestModel.load(jsc.sc(),
      "target/tmp/myRandomForestClassificationModel");
    // 停止JavaSparkContext对象
    jsc.stop();
  }
}
K均值聚类(K-means)是一种无监督学习算法,用于将数据集划分为k个互不重叠的子集(簇)。算法的目标是通过迭代优化簇的中心点(质心),使得每个簇内样本与质心的距离总和最小。
算法步骤
K均值聚类的效果较大程度依赖于k值的选择。常用方法包括“肘部法则”来确定最优的k值。
适用场景
K均值聚类适用于以下应用场景:
K均值聚类简单高效,尤其在处理大规模数据时表现出色,但其对初始质心的选择和k值的设定敏感。
实现示例代码如下:
public class JavaKMeansExample {
  public static void main(String[] args) {

    // 创建Spark应用的配置对象,设置应用名称和运行模式(本地模式)
    SparkConf conf = new SparkConf().setAppName("JavaKMeansExample")
        .setMaster("local");
    // 创建JavaSparkContext对象,用于与Spark集群进行交互
    JavaSparkContext jsc = new JavaSparkContext(conf);

    // 加载并解析数据
    // 数据文件路径
    String path = "data/mllib/kmeans_data.txt";
    // 读取文本文件并创建一个JavaRDD
    JavaRDD<String> data = jsc.textFile(path);
    JavaRDD<Vector> parsedData = data.map(s -> {
      String[] sarray = s.split(" "); // 按空格分割每行数据
      // 创建一个用于存储数值的数组
      double[] values = new double[sarray.length];
      for (int i = 0; i < sarray.length; i++) {
          // 将字符串转换为双精度浮点数
        values[i] = Double.parseDouble(sarray[i]);
      }
      return Vectors.dense(values);     // 创建稠密向量
    });
    parsedData.cache();                 // 缓存处理后的数据

    // 使用KMeans算法对数据进行聚类
    int numClusters = 2;             // 聚类数量
    int numIterations = 20;             // 迭代次数
    // 训练KMeans模型
    KMeansModel clusters = KMeans
        .train(parsedData.rdd(), numClusters, numIterations);

    // 打印聚类中心
    System.out.println("Cluster centers:");
    for (Vector center: clusters.clusterCenters()) {
      System.out.println(" " + center);
    }
    // 计算模型的成本
    double cost = clusters.computeCost(parsedData.rdd());
    System.out.println("Cost: " + cost);

    // 计算Within Set Sum of Squared Errors(WSSSE)来评估聚类效果
    double WSSSE = clusters.computeCost(parsedData.rdd());
    System.out.println("Within Set Sum of Squared Errors = " + WSSSE);

    // 将模型保存到指定路径
    clusters.save(jsc.sc(),
      "target/org/apache/spark/JavaKMeansExample/KMeansModel");
    // 从指定路径加载模型
    KMeansModel sameModel = KMeansModel.load(jsc.sc(),
      "target/org/apache/spark/JavaKMeansExample/KMeansModel");

    // 停止JavaSparkContext对象
    jsc.stop();
  }
}
Apriori算法是一种经典的关联规则挖掘算法,广泛应用于处理事务型数据(如超市购物篮分析)。该算法基于“先验”原理:如果一个项集是频繁的,那么它的所有子集也必然是频繁的。
核心步骤
Apriori算法的主要瓶颈是其需要多次扫描数据集,尤其在大数据集上效率较低。因此,FP-Growth等改进算法被提出,以提高挖掘效率。
适用场景
Apriori算法适用于以下场景:
Apriori算法能够发现数据中的潜在关联关系,但在大规模数据集上的性能较为有限。
实现示例代码如下:
public class JavaSimpleFPGrowth {

  public static void main(String[] args) {
    // 创建Spark应用的配置对象,设置应用名称和运行模式(本地模式)
    SparkConf conf = new SparkConf()
            .setAppName("FP-growth Example")    // 设置应用名称
            .setMaster("local");                 // 设置运行模式为本地模式
    // 创建JavaSparkContext对象,用于与Spark集群进行交互
    JavaSparkContext sc = new JavaSparkContext(conf);

    // $example on$
    // 读取数据文件,并创建一个JavaRDD对象
    JavaRDD<String> data = sc.textFile("data/mllib/sample_fpgrowth.txt");

    // 将数据文件中的每一行文本映射为一个由商品组成的列表
    JavaRDD<List<String>> transactions =
        data.map(line -> Arrays.asList(line.split(" ")));

    // 创建一个FP-growth模型对象,并设置最小支持度为0.2,分区数为10
    FPGrowth fpg = new FPGrowth()
      .setMinSupport(0.2)                 // 设置最小支持度阈值
      .setNumPartitions(10);             // 设置分区数

    // 运行FP-growth算法,生成模型
    FPGrowthModel<String> model = fpg.run(transactions);

    int count = 0;
    // 遍历模型中的频繁项集,并打印每个项集及其支持度
    for (FPGrowth.FreqItemset<String> itemset :
        model.freqItemsets().toJavaRDD().collect()) {
      count++;
      if (count > 5) {
          break;
      }
      System.out.println("[" + itemset.javaItems() + "], "
          + itemset.freq());
    }

    // 设置最小置信度为0.8,并生成关联规则
    double minConfidence = 0.8;
    for (AssociationRules.Rule<String> rule
      : model.generateAssociationRules(minConfidence)
          .toJavaRDD().collect()) {
      count++;
      if (count > 5) {
          break;
      }
      // 打印每个关联规则及其置信度
      System.out.println(
        rule.javaAntecedent() + " => "
            + rule.javaConsequent() + ", "
            + rule.confidence());
    }

    // 停止JavaSparkContext对象
    sc.stop();
  }
}
本篇博客深入探讨了数据分析与挖掘的核心技术,涵盖了大数据分析流程、数据挖掘算法和特征工程的实际应用。通过具体案例,详细解析了数据挖掘算法如何从复杂的数据中提取有价值的洞察,特征工程如何优化数据特征以提升模型性能,以及大数据分析如何高效处理海量数据,揭示其中潜在的趋势和模式。
这篇博客就和大家分享到这里,如果大家在研究学习的过程当中有什么问题,可以加群进行讨论或发送邮件给我,我会尽我所能为您解答,与君共勉!
另外,博主出新书了《Hadoop与Spark大数据全景解析》、同时已出版的《深入理解Hive》、《Kafka并不难学》和《Hadoop大数据挖掘从入门到进阶实战》也可以和新书配套使用,喜欢的朋友或同学, 可以在公告栏那里点击购买链接购买博主的书进行学习,在此感谢大家的支持。关注下面公众号,根据提示,可免费获取书籍的教学视频。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。