


就是把普通网址,转换成比较短的网址。比如:http://t.cn/RlB2PdD 这种,在微博这些限制字数的应用里。好处不言而喻。短、字符少、美观、便于发布、传播。
百度短网址 http://dwz.cn/
谷歌短网址服务 https://goo.gl/ 号称是最快的
当我们在浏览器里输入 http://t.cn/RlB2PdD 时
IP 地址DNS 获得 IP 地址以后(比如:74.125.225.72),会向这个地址发送 HTTPGET 请求,查询短码 RlB2PdDRlB2PdD 获取对应的长 URLHTTP301 转到对应的长 URL https://m.helijia.com 。这里有个小的知识点,为什么要用 301 跳转而不是 302 呐?
301 是永久重定向,302 是临时重定向。短地址一经生成就不会变化,所以用 301 是符合http语义的。同时对服务器压力也会有一定减少。
但是如果使用了301,我们就无法统计到短地址被点击的次数了。而这个点击次数是一个非常有意思的大数据分析数据源。能够分析出的东西非常非常多。所以选择302虽然会增加服务器压力,但是我想是一个更好的选择。
来自知乎 iammutex 的答案
此服务应该是频繁读操作。相比起加入新的URL而言,访问已有URL的短链接将会频繁很多。
我们可以假设读写操作的数量比为100:1。
我们打算对一些高访问的热门URL做cache操作,这些URL会存在于内存里面,而不是硬盘上,便于快速访问。
假设URL也遵从80-20 Rule,那么20%的URL产生了80%的流量,我们将对top20%的URL做cache。
每个月生成的新URL为500M,top20%~100M, 总共需要100Mx500B=500MB。
如果我们想cache更长时段的URL,则需要更大的空间。
我们可以以如下API生成/删除短URL:
createURL(api_dev_key, original_url, custom_alias=None, user_name=None, expire_date=None)
deleteURL(api_dev_key, url_key)
Parameters:
api_dev_key (string): The API developer key of a registered account. This will be used to, among other things, throttle users based on their allocated quota.
original_url (string): Original URL to be shortened.
custom_alias (string): Optional custom key for the URL.
user_name (string): Optional user name to be used in the encoding.
expire_date (string): Optional expiration date for the shortened URL.
Returns: (string)
A successful insertion returns the shortened URL; otherwise, it returns an error code.
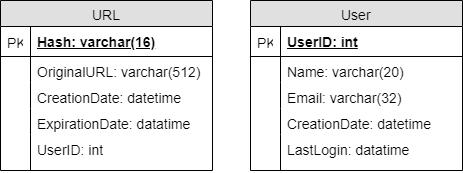
需要存储的数据的性质:
我们需要两个表:
数据库选择
既然我们需要存储三百亿条记录,而且记录与记录之间又没有关系,NoSQL的数据库是我们的最佳选择:DynamoDB, Cassandra 或者 Riak
这一部分我们解决如何把一个长链接映射成短链接的算法问题。
一般来说生成的短链接有如下格式:http://tinyurl.com/jlg8zpc
最后斜杠后面的那几位随机乱码是我们这一步要生成的对象。
利用Hash编码软件,例如MD5或者SHA256,对原始长链接进行编码。
一个必须考虑的问题是,生成多长的Hash码,才能满足我们系统的需求?
编码的base可以是base36 ([a-z ,0-9])或者base62 ([A-Z, a-z, 0-9]),如果再加上+和/,我们可以使用base64的编码。
因为我们的系统只需要存储30B条记录,6字母编码就足够了。
采取此算法应注意Hash collision问题。
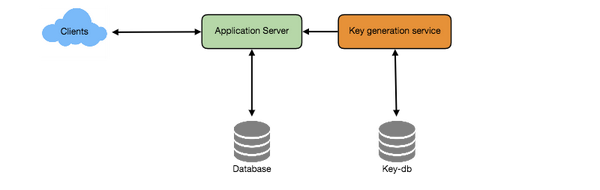
我们也可以使用独立的键生成服务(Key Generation Service)。它提前生成随机的6位字符串,然后存储在键数据库里,需要产生短链接的时候,就从里面拿一个来用。这会使得整个事情变得非常简单便捷:我们不仅不需要为长链接编码,而且也不需要担心重复或者Hash collision这样的事情。
并发问题
一个键被使用之后,数据库应该把它标记为已经被使用。但是,如果有多个服务器同时试图读写数据库里的键,并发问题就产生了。
一种解决办法是用唯一的KGS,而且KGS保证不会将同一个key分配给不同的服务器请求,这需要KGS有某种lock。
额外估计
为了适用于大规模场景,我们可能需要将数据库进行分区或者增加副本。
根据Hash key的首字母对数据库进行分区。更进一步,我们可以把更少访问的首字母分到一个区,更频繁访问的字母分成单独的区,以此来平衡分区大小。
美中不足的是无法严格控制分区大小,比如以e开头的字母会很多,远超过其他字母。
根据Hash编码来分区,这样分区大小是可预计且可控的,会更加均衡一些。
应该对经常被访问到的链接进行cache,可以提高访问速度。
缓存大小 和前面估计的一样,我们会cache top20%的链接。这部分估计很小,很容易放进内存里。
什么时候清理缓存? 当cache满了之后,我们要删除一些链接并放入新的,怎么选择呢?可以使用LRU。
更新副本缓存
我们可以在系统的三个地方添加负载均衡器(load balancer):
一开始,我们可以使用最简单的round-robin方式,将访问请求平均分配到各个服务器上面。这个方法的优点是没有overhead,而且容易实现。如果一个服务器坏了,就把它从负载均衡器里面拿掉。
这个方法的缺点是没有考虑到每个服务器的负载问题。
数据库累积太多数据的时候就应该被清理一下以腾出空间。当链接失效或者过时了,我们也应该清理掉相关数据。
我们应该做lazy cleanup来缓解数据库压力, 具体表现为:
利用遥测系统可以获得更多数据并作出分析,以提高系统性能,比如:
我们可以创立私密链接,或者只给一部分用户访问的链接吗?
为了达到此需求,我们需要给链接加上额外的permission级别。我们也可以创建单独的表存储允许被访问的用户信息。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。