





大语言模型生成文本的过程本质上是给定上下文,逐词预测下一个词。
但在实现上,这个过程被明确地分成两个阶段:
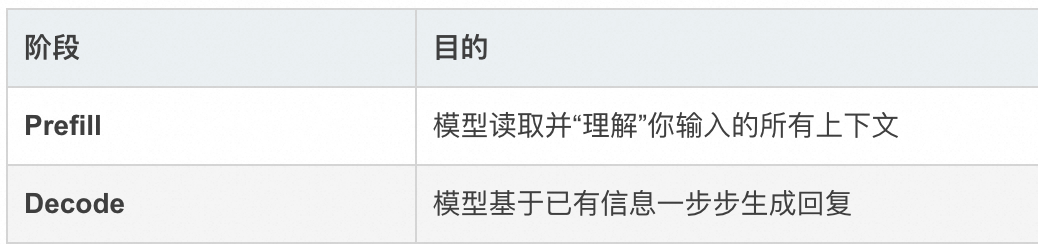
因为输入和输出的计算特性完全不同:
这种“数据形态差异”导致我们不得不把它们拆成两个阶段,并用不同方式处理。
原文链接:https://blog.csdn.net/keeppractice/article/details/147012874
大模型系列:深度解析 Prefill-Decode 分离式部署架构 https://zhuanlan.zhihu.com/p/1918334902492963669
为什么LLM推理要分成Prefill和Decode两个阶段? https://zhuanlan.zhihu.com/p/1925514980343677032
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。