







ZooKeeper 顾名思义 动物园管理员,他是拿来管大象(Hadoop) 、 蜜蜂(Hive) 、 小猪(Pig) 的管理员, Apache Hbase和 Apache Solr 以及LinkedIn sensei 等项目中都采用到了 Zookeeper。ZooKeeper是一个分布式的,开放源码的分布式应用程序协调服务,ZooKeeper是以Fast Paxos算法为基础,实现同步服务,配置维护和命名服务等分布式应用。
上面的解释感觉还不够,太官方了。Zookeeper 从程序员的角度来讲可以理解为Hadoop的整体监控系统。如果namenode,HMaster宕机后,这时候Zookeeper 的重新选出leader。这是它最大的作用所在。下面详细介绍zookeeper的作用
ZooKeeper命名空间中的Znode,兼具文件和目录两种特点。既(1)像文件一样维护着数据、元信息、ACL、时间戳等数据结构,又(2)像目录一样可以作为路径标识的一部分。
每个Znode由3部分组成:
ZooKeeper虽然可以关联一些数据,但并没有被设计为常规的数据库或者大数据存储,相反的是,它用来管理调度数据,比如分布式应用中的配置文件信息、状态信息、汇集位置等等。这些数据的共同特性就是它们都是很小的数据,通常以KB为大小单位。ZooKeeper的服务器和客户端都被设计为严格检查并限制每个Znode的数据大小一般在kb大小,至多1M,但常规使用中应该远小于此值。如果需要存储大型数据,建议将数据存放在hdfs等文件存储系统
教程:https://www.runoob.com/w3cnote/zookeeper-tutorial.html
mac下配置zookeeper:https://developer.aliyun.com/article/1148515
节点数据结构:
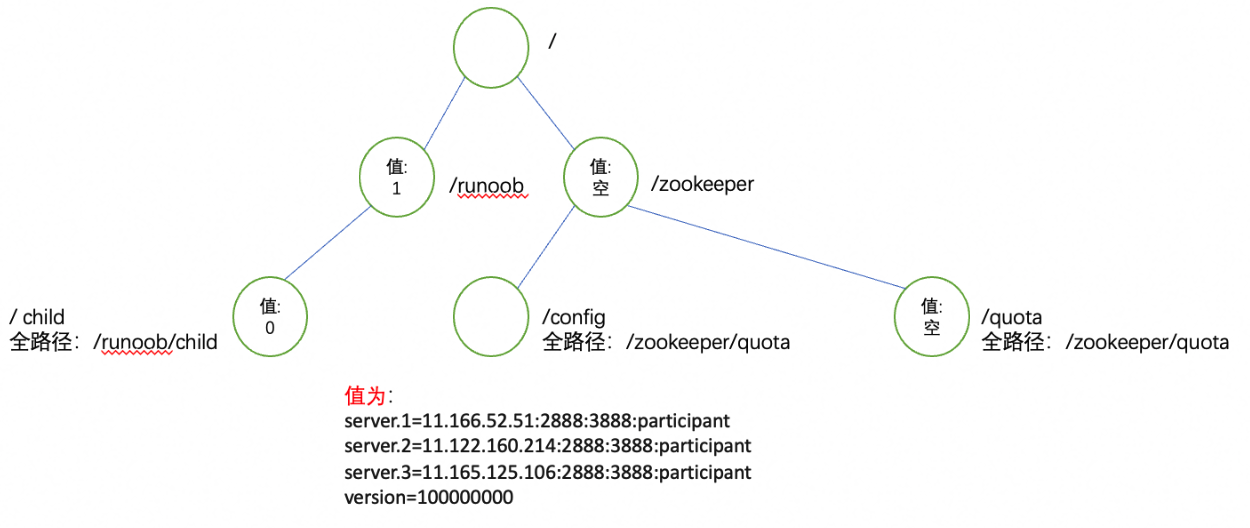
相关命令和注释:
[zk: localhost:2181(CONNECTED) 35] get /runoob 1 [zk: localhost:2181(CONNECTED) 36] get /runoob/child 0 [zk: localhost:2181(CONNECTED) 37] get /zookeeper [zk: localhost:2181(CONNECTED) 38] get /zookeeper/config server.1=11.166.52.51:2888:3888:participant server.2=11.122.160.214:2888:3888:participant server.3=11.165.125.106:2888:3888:participant version=100000000 [zk: localhost:2181(CONNECTED) 39] get /zookeeper/quota [zk: localhost:2181(CONNECTED) 40] get -s /runnob Node does not exist: /runnob [zk: localhost:2181(CONNECTED) 41] get -s /runoob #-s看该节点详情 1 cZxid = 0x100000004 # 创建(c create)节点时的事务ID 如下为/runoob节点的stat状态信息 ctime = Tue Sep 10 14:07:40 CST 2024 # 创建(c create)节点时的时间 mZxid = 0x10000000a # 最后修改(m modify)节点时的事务ID mtime = Tue Sep 10 14:24:45 CST 2024 # 最后修改(m modify)节点时的时间
#pZxid是proposed zxid的缩写,它是一个重要的内部标识符,用于唯一地标识事务日志中的每一个提议(Proposal)。zxid是transaction id的缩写,代表事务 ID pZxid = 0x100000023 #表示该节点的子节点列表最后一次修改的事务ID,添加子节点或删除子节点就会影响子节点列表,但是修改子节点的数据内容则不影响该ID(注意,只有子节点列表变更了才会变更pzxid,子节点内容变更不会影响pzxid) cversion = 3 # 子节点(c child)版本号,子节点每次修改版本号加1 dataVersion = 1 # 数据(data)版本号,数据每次修改该版本号加1 aclVersion = 0 # 权限版本号,权限每次修改该版本号加1 ephemeralOwner = 0x0 # 创建该临时节点的会话的sessionID。(**如果该节点是持久节点,那么这个属性值为0)** dataLength = 1 # 该节点的数据长度 numChildren = 1 # 该节点拥有子节点的数量(只统计直接子节点的数量) [zk: localhost:2181(CONNECTED) 42] ls /runoob [child] [zk: localhost:2181(CONNECTED) 43] ls / [runoob, zookeeper] [zk: localhost:2181(CONNECTED) 44] ls /zookeeper [config, quota]
zookeeper节点
节点类型有四种,分别是PERSISTENT、PERSISTENT_SEQUENTIAL、EPHEMERAL(ephemeral临时的/短暂的)、EPHEMERAL_SEQUENTIAL,分别为永久节点,永久有序节点,临时节点和临时有序节点。节点的类型在创建时即被确定,并且不能改变。
- 同级节点:同级节点是唯一的
- 临时节点:该节点的生命周期依赖于创建它们的会话。一旦会话(Session)结束,临时节点将被自动删除,当然可以也可以手动删除。虽然每个临时的Znode都会绑定到一个客户端会话,但他们对所有的客户端还是可见的。另外,ZooKeeper的临时节点不允许拥有子节点。
- 永久节点:该节点的生命周期不依赖于会话,并且只有在客户端显示执行删除操作的时候,他们才能被删除。
- 有序节点:当创建Znode的时候,用户可以请求在ZooKeeper的路径结尾添加一个递增的计数。这个计数对于此节点的父节点来说是唯一的,它的格式为"%10d"(10位数字,没有数值的数位用0补充,例如"0000000001")。当计数值大于2的32次方-1时,计数器将溢出。
通过命令get -s /node可以获取到如下所示信息:
[root: 127.0.0.1:2181(CONNECTED) 2] get -s /node
value #当前节点的信息
cZxid = 0x200000007 #创建的时候生成的事务ID
ctime = Thu Dec 07 16:37:55 CST 2019 #创建的时候时间戳
mZxid = 0x2400000006 #修改(modify)的时候生成的事务ID
mtime = Mon Dec 18 10:57:16 CST 2019 #修改(modify)的时候时间戳
pZxid = 0x2400000004 #子节点列表最后修改事务ID,子节点内容修改不影响pZxid
cversion = 4 #类似乐观锁保证原子性 ,子节点版本号
dataVersion = 8 #类似乐观锁保证原子性 ,数据节点版本号
aclVersion = 0 #类似乐观锁保证原子性 ,节点ACL版本号
ephemeralOwner = 0x0 #创建该临时节点的会话sessionID,如果是持久节点,那么就是0。这里是持久化节点
dataLength = 6 #数据节点内容长度
numChildren = 2 #当前节点的子节点数量
数据存储在DataTree中,用ConcurrentHashMap存储。
事务日志 : conf/zoo.cfg 中dataDir目录中。默认是/tmp/zookeeper,最好不要放在tmp目录下,这个是临时目录,会定时清理。一般挂载在某个磁盘下。日志文件的命名规则为log.**,**表示写入该日志的第一个事务的ID,十六进制表示。
快照日志 :conf/zoo.cfg 中dataDir目录中。zookeeper快照文件的命名规则为snapshot.,其中表示zookeeper触发快照的那个瞬间,提交的最后一个事务的ID。
运行时日志: bin/zookeeper.out文件中
集群搭建 参照:https://www.runoob.com/w3cnote/zookeeper-linux-cluster.html
$ wget https://archive.apache.org/dist/zookeeper/zookeeper-3.5.1-alpha/zookeeper-3.5.1-alpha.tar.gz
下载的是该文档里的版本zookeeper-3.5.1-alpha.tar.gz :https://developer.aliyun.com/article/1148515;
三台虚拟机 zoo.cfg 文件末尾添加配置:
server.1=192.168.3.33:2888:3888
server.2=192.168.3.35:2888:3888
server.3=192.168.3.37:2888:3888
(选举过程(后面详细解释):选择3为leader,1、2作为follower;集群不一定会有observer,需要手动设置,只是为了增加读的吞吐,不参与投票)
zookeeper 的三个端口作用
(1)2181 : 对 client 端提供服务
(2)2888 : 集群内机器通信使用
(3)3888 : 选举 leader 使用
配置3台虚拟机的myid 分别为1、2、3
cat /tmp/zookeeper/myid // 1、2、3
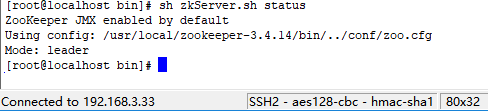
启动集群(会显示1、2为follower、3为leader):
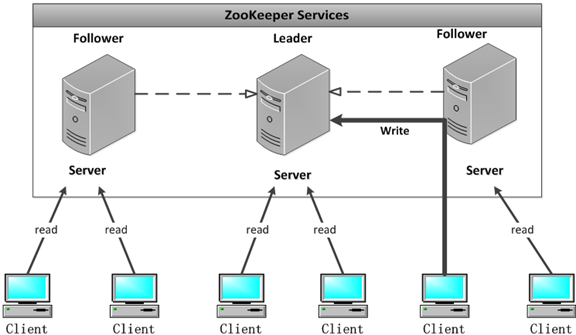
集群角色包含:Leader,Follower ,Observer;一个 ZooKeeper 集群同一时刻只会有一个 Leader,其他都是 Follower 或 Observer。
zooKeeper 默认只有 Leader 和 Follower 两种角色,没有 Observer 角色。为了使用 Observer 模式,在任何想变成Observer的节点的配置文件中加入:peerType=observer 并在所有 server 的配置文件中,配置成 observer 模式的 server 的那行配置追加 :observer
1.Leader:ZooKeeper 集群的所有机器通过一个 Leader 选举过程来选定一台被称为Leader
的机器,Leader服务器为客户端提供读写服务。
作用:
1)事务请求的唯一调度和处理者,保证事务处理的顺序性;
2)集群内部各服务器的调度者;
2.Follower:
作用:
1)处理客户端非事务请求-读,转发事务给Leader服务器;
2)参与事务Proposal请求的投票(超过半数,Leader才能发起commit通知)
3)参与Leader选举投票
3.Observer
作用: 1)处理客户端非事务请求-读,转发事务给Leader服务器;(不参与Proposal的投票)
此 Observer 可以在不影响写性能的情况下提升集群的读性能。当写请求到了的时候,会转发给Leader服务器
bin/zkServer.sh status 可以查看当前节点是什么角色
通常 zookeeper 是由 2n+1 台 server 组成,每个 server 都知道彼此的存在。对于 2n+1 台 server,只要有 n+1 台(大多数)server 可用,整个系统保持可用。我们已经了解到,一个 zookeeper 集群如果要对外提供可用的服务,那么集群中必须要有过半的机器正常工作并且彼此之间能够正常通信;
基于这个特性,如果向搭建一个能够允许 F 台机器down 掉的集群,那么就要部署 2*F+1 台服务器构成的zookeeper 集群。因此 3 台机器构成的 zookeeper 集群,能够在挂掉一台机器后依然正常工作。一个 5 台机器集群的服务,能够对 2 台机器怪调的情况下进行容灾。如果一台由 6 台服务构成的集群,同样只能挂掉 2 台机器。因此,5 台和 6 台在容灾能力上并没有明显优势,反而增加了网络通信负担。系统启动时,集群中的 server 会选举出一台server 为 Leader,其它的就作为 follower(这里先不考虑observer 角色)。
之所以要满足这样一个等式,是因为一个节点要成为集群中的 leader,需要有超过及群众过半数的节点支持,这个涉及到 leader 选举算法。同时也涉及到事务请求的提交投票。
https://www.runoob.com/w3cnote/zookeeper-leader.html
也参照:聊聊zookeeper的最终一致性(顺序一致性):https://time.geekbang.org/column/article/239261
zookeeper 的 leader 选举存在两个阶段,一个是服务器启动时 leader 选举,另一个是运行过程中 leader 服务器宕机。在分析选举原理前,先介绍几个重要的参数。
选举状态:
每个节点启动的时候都 LOOKING 观望状态,接下来就开始进行选举主流程。这里选取三台机器组成的集群为例。第一台服务器 server1启动时,无法进行 leader 选举,当第二台服务器 server2 启动时,两台机器可以相互通信,进入 leader 选举过程。
(1)每台 server 发出一个投票,由于是初始情况,server1 和 server2 都将自己作为 leader 服务器进行投票,每次投票包含所推举的服务器myid、zxid、epoch,使用(myid,zxid)表示,此时 server1 投票为(1,0),server2 投票为(2,0),然后将各自投票发送给集群中其他机器。
(2)接收来自各个服务器的投票。集群中的每个服务器收到投票后,首先判断该投票的有效性,如检查是否是本轮投票(epoch)、是否来自 LOOKING 状态的服务器。
(3)分别处理投票。针对每一次投票,服务器都需要将其他服务器的投票和自己的投票进行对比,对比规则如下:
(4)统计投票。每次投票后,服务器统计投票信息,判断是都有过半机器接收到相同的投票信息。server1、server2 都统计出集群中有两台机器接受了(2,0)的投票信息,此时已经选出了 server2 为 leader 节点。
(5)改变服务器状态。一旦确定了 leader,每个服务器响应更新自己的状态,如果是 follower,那么就变更为 FOLLOWING,如果是 Leader,变更为 LEADING。此时 server3继续启动,直接加入变更自己为 FOLLOWING。
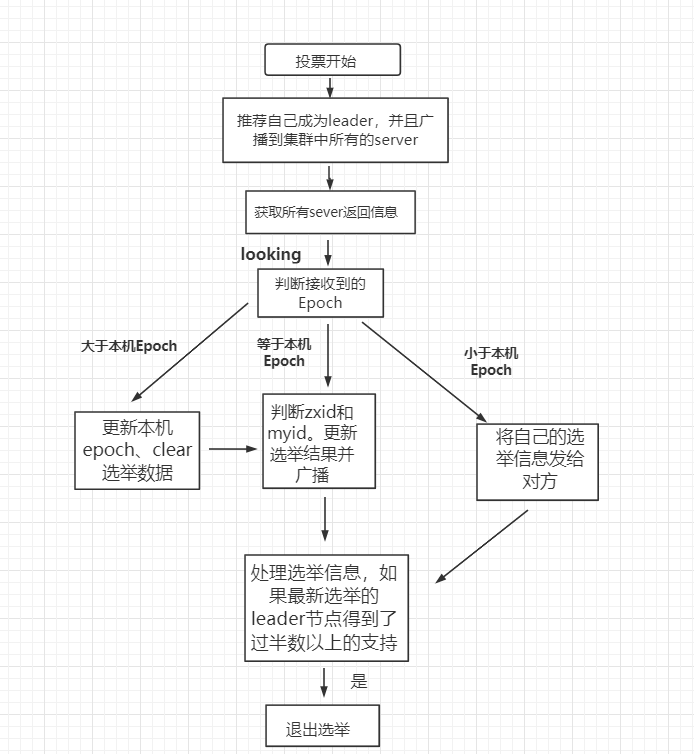
当集群中 leader 服务器出现宕机或者不可用情况时,整个集群无法对外提供服务,进入新一轮的 leader 选举。
在 Zookeeper 中,主要依赖 ZAB 协议来实现分布式数据一致性。
ZAB 协议分为两部分:
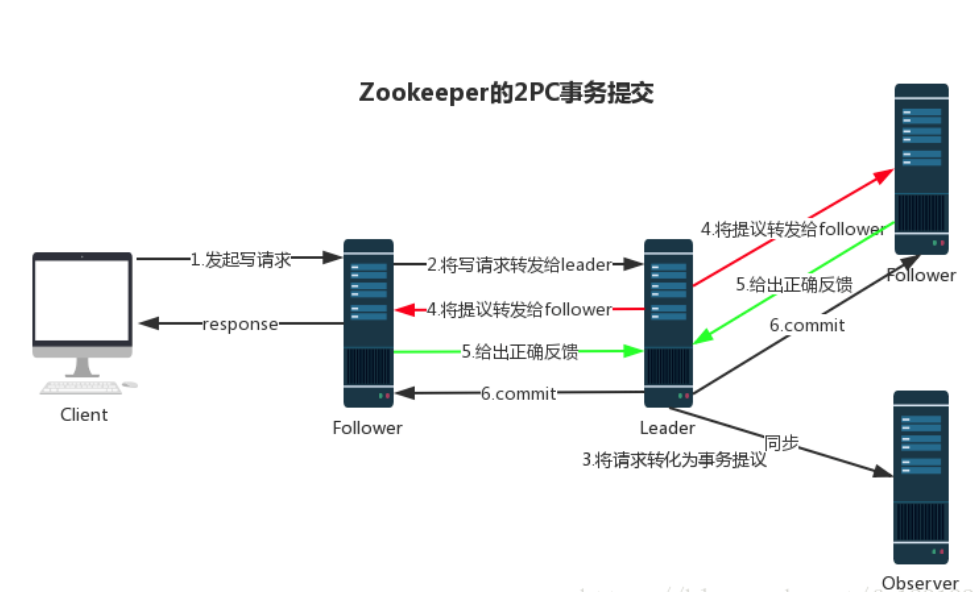
Zookeeper 使用单一的主进程 Leader 来接收和处理客户端所有事务请求(写数据),并采用 ZAB 协议的原子广播协议(两阶段协议2pc 事务提交,Two-phase Commit Protocol):
(1)将事务请求以 Proposal 提议广播到所有 Follower 节点,
(2)当集群中有过半的Follower 服务器进行正确的 ACK 反馈,那么Leader就会再次向所有的 Follower 服务器发送commit 消息,将此次提案进行提交。这个过程可以简称为 2pc 事务提交,整个流程可以参考下图,
注意: Observer 节点只负责同步 Leader 数据,不参与 2PC 数据同步过程。Observer简单地从Leader拉取差异数据(即它所缺少的更新),进行非事务性的快速同步。这意味着Observer不需要等待过半服务器的确认,它可以更快地应用这些更新并对外提供服务,但这也意味着Observer上的数据在某种程度上是“最终一致”的,而非强一致。
在正常情况消息广播情况下能运行良好,但是一旦 Leader 服务器出现崩溃,或者由于网络原理导致 Leader 服务器失去了与过半 Follower 的通信,那么就会进入崩溃恢复模式,需要选举出一个新的 Leader 服务器。在这个过程中可能会出现两种数据不一致性的隐患,需要 ZAB 协议的特性进行避免。
ZAB 协议的恢复模式使用了以下策略:
上个章节详细讲解 leader 选举过程。
https://www.cnblogs.com/cxuanBlog/p/14166322.html
CountDownLatch 能够使一个线程在等待另外一些线程完成各自工作之后,再继续执行。它相当于是一个计数器,这个计数器的初始值就是线程的数量,每当一个任务完成后,计数器的值就会减一,当计数器的值为 0 时,表示所有的线程都已经任务了,然后在 CountDownLatch 上等待的线程就可以恢复执行(countDownLatch.await()的线程会被唤醒)接下来的任务。
CountDownLatch 提供了一个构造方法,你必须指定其初始值,还指定了 countDown 方法,这个方法的作用主要用来减小计数器的值,当计数器变为 0 时,在 CountDownLatch 上 await 的线程就会被唤醒,继续执行其他任务。当然也可以延迟唤醒,给 CountDownLatch 加一个延迟时间就可以实现。
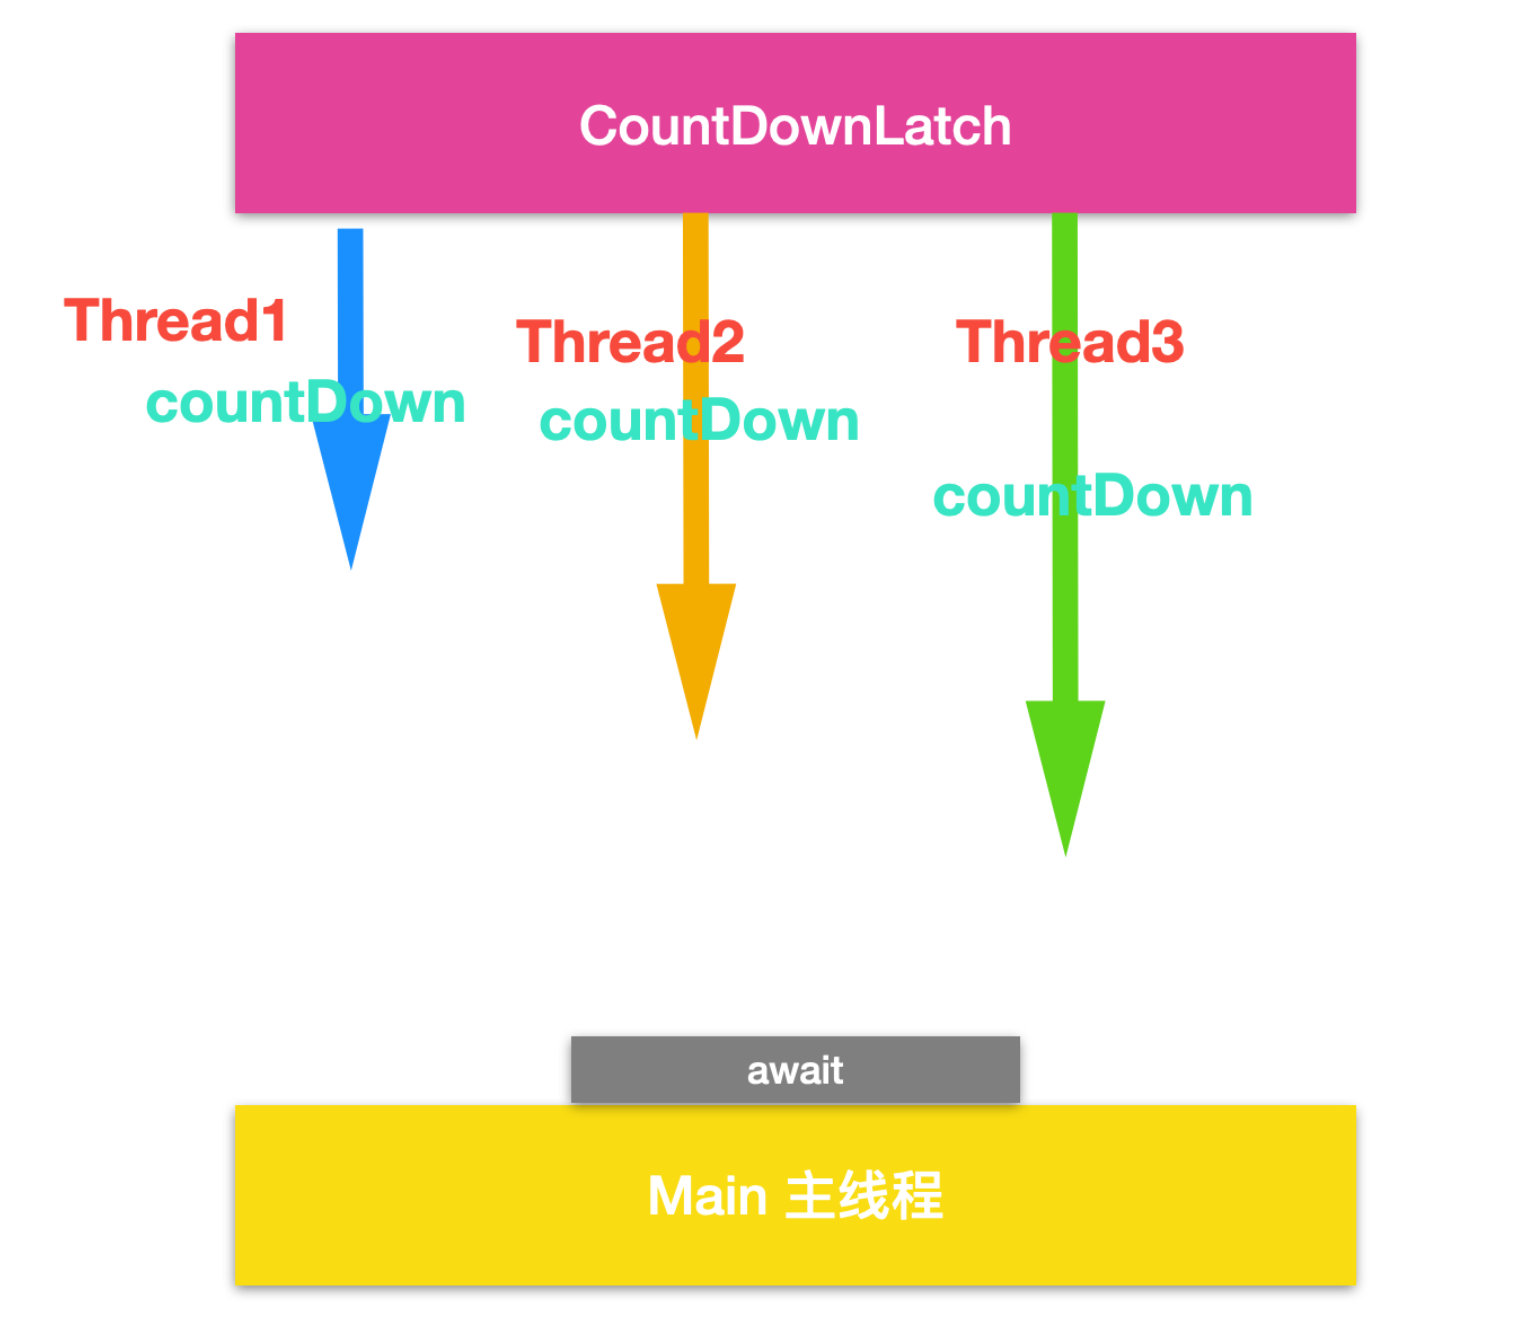
1. 典型的应用场景就是当一个服务启动时,同时会加载很多组件和服务,这时候主线程会等待组件和服务的加载。当所有的组件和服务都加载完毕后,主线程和其他线程在一起完成某个任务。
2. CountDownLatch 还可以实现学生一起比赛跑步的程序,CountDownLatch 初始化为学生数量的线程,鸣枪后,每个学生就是一条线程,来完成各自的任务,当第一个学生跑完全程后,CountDownLatch 就会减一,直到所有的学生完成后,CountDownLatch 会变为 0 ,接下来再一起宣布跑步成绩。
顺着这个场景,你自己就可以延伸、拓展出来很多其他任务场景。
https://www.runoob.com/w3cnote/zookeeper-java-setup.html
 1 package com.runoob.zookeeper;
 2
 3 import org.apache.zookeeper.WatchedEvent;
 4 import org.apache.zookeeper.Watcher;
 5 import org.apache.zookeeper.ZooKeeper;
 6
 7 import java.util.concurrent.CountDownLatch;
 8
 9 public class ConnectionDemo {
10     public static void main(String[] args) {
11         try {
12             /**
13              * CountDownLatch 能够使一个线程在等待另外一些线程完成各自工作之后,再继续执行。
14              * 它相当于是一个计数器,这个计数器的初始值就是线程的数量,每当一个任务完成后,计数器的值就会减一,
15              * 当计数器的值为 0 时,表示所有的线程都已经任务了,
16              *      然后在 CountDownLatch 上等待的线程就可以恢复执行(countDownLatch.await()的线程会被唤醒)接下来的任务。
17              */
18             // 因为连接需要时间,用 countDownLatch 阻塞,等待连接成功,控制台输出连接状态!
19             final CountDownLatch countDownLatch=new CountDownLatch(1);
20             ZooKeeper zooKeeper=
21                     new ZooKeeper("11.166.52.51:2181," +
22                             "11.122.160.214:2181,11.165.125.106:2181",   // 参数1:集群主机IP:客户端通信端口 字符串连接
23                             4000, new Watcher() {                       // 参数2:sessionTimeout,参数3:new一个watcher
24
25                         public void process(WatchedEvent event) {
26                             if(Event.KeeperState.SyncConnected==event.getState()){
27                                 //如果收到了服务端的响应事件,连接成功
28                                 System.out.println("in_before");  // 打印顺序:(2)
29                                 countDownLatch.countDown();  // 子线程countDown,计数器-1
30                                 System.out.println("in_after"); // 打印顺序:(3)
31                             }
32                         }
33                     });
34             System.out.println("outer_before"); // 打印顺序:(1)
35             countDownLatch.await(); // 当计数器变为0时,在CountDownLatch上await的线程(这里是主线程)就会被唤醒
36             System.out.println("outer_after:" + zooKeeper.getState()); // 打印顺序:(4),输出:CONNECTED
37
38         } catch (Exception e) {
39             System.out.println(e.getMessage());
40         }
41     }
42 }
输出结果:
outer_before
in_before
in_after
outer_after:CONNECTED
例2:创建节点
 1 package com.runoob.zookeeper;
 2
 3 import org.apache.zookeeper.*;
 4
 5 import java.util.concurrent.CountDownLatch;
 6
 7 public class CuratorDemo {
 8     public static void main(String[] args) {
 9         try {
10             final CountDownLatch countDownLatch=new CountDownLatch(1);
11             ZooKeeper zooKeeper=
12                     new ZooKeeper("11.166.52.51:2181," +
13                             "11.122.160.214:2181,11.165.125.106:2181",
14                             4000, new Watcher() {
15
16                         public void process(WatchedEvent event) {
17                             if(Event.KeeperState.SyncConnected==event.getState()){
18                                 //如果收到了服务端的响应事件,连接成功
19                                 countDownLatch.countDown();
20                             }
21                         }
22                     });
23             countDownLatch.await();
24
25             //CONNECTED
26             System.out.println(zooKeeper.getState());
27
28             // zooKeeper可以create、delete节点,可以setData、setAcl,可以getChildren
29             // 添加节点:CreateMode.PERSISTENTCreateMode.EPHEMERAL:短暂的
30             String  runoobPath = zooKeeper.create("/runoob","0".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT);
31             System.out.println("runoobPath="+ runoobPath);
32
33         } catch (Exception e) {
34             System.out.println(e.getMessage());
35         }
36     }
37 }
在zookeeper客户端和服务端成功完成链接后,就建立一个会话,Zookeeper会在整个运行期间的生命周期中,会在不同的会话状态中进行切换,这些状态有Connecting,Connected,ReConnecting,ReConnected,Close等。
Session 是指客户端会话,在ZooKeeper 中,一个客户端连接是指客户端和 ZooKeeper 服务器之间的TCP长连接。
ZooKeeper 对外的服务端口默认是2181,客户端启动时,首先会与服务器建立一个TCP连接,从第一次连接建立开始,客户端会话的生命周期也开始了,通过这个连接,客户端能够通过心跳检测和服务器保持有效的会话,也能够向 ZooKeeper 服务器发送请求并接受响应,同时还能通过该连接接收来自服务器的 Watch 事件通知。
Session 的 SessionTimeout 值用来设置一个客户端会话的超时时间。当由于服务器压力太大、网络故障或是客户端主动断开连接等各种原因导致客户端连接断开时,只要在SessionTimeout 规定的时间内能够重新连接上集群中任意一台服务器,那么之前创建的会话仍然有效。
客户端与服务端之间的连接是基于 TCP 长连接,client 端连接 server 端默认的 2181 端口,也就是 session 会话。
从第一次连接建立开始,客户端开始会话的生命周期,客户端向服务端的ping包请求,每个会话都可以设置一个超时时间。
sessionID: 会话ID,用来唯一标识一个会话,每次客户端创建会话的时候,zookeeper 都会为其分配一个全局唯一的 sessionID
zookeeper 的 leader 服务器在运行期间定时进行会话超时检查,时间间隔是 ExpirationInterval,单位是毫秒,默认值是 tickTime,每隔 tickTime 进行一次会话超时检查。
在 zookeeper 运行过程中,客户端会在会话超时过期范围内向服务器发送请求(包括读和写)或者 ping 请求,俗称心跳检测完成会话激活(激活后进行“迁移会话”的过程,然后开始新一轮超时检查;感觉像是会话的超时时间往后顺延),从而来保持会话的有效性。
“迁移会话”的另一解释:
Zookeeper客户端在初始化连接时会选择一个服务器建立连接,并开启一个会话(session)。此会话有一个超时时间,客户端必须在这个时间内通过发送请求(读、写操作或心跳包ping)来保持会话活跃。如果客户端长时间没有活动导致会话超时,服务器端会认为该客户端已断开连接并关闭会话。
当客户端与当前连接的服务器通信中断时,客户端不会直接使用"迁移会话"这样的动作,而是会自动尝试重新连接到Zookeeper集群中的其他可用服务器。这一过程包括发现可用服务器、建立新连接,并在认证通过后继续使用原有的会话ID进行操作,这样就可以保持会话状态不丢失,看起来就像是会话从一个服务器“迁移到”了另一个服务器,但实际上是在新的服务器上重建了与旧会话一致的上下文环境。因此,更准确的说法应该是“会话恢复”或“会话重新建立”,而非“会话迁移”。这个机制确保了Zookeeper服务的高可用性和客户端会话的连续性。
正常情况下,如果会话超时导致连接中断,客户端在重新连接到Zookeeper集群时,会尝试恢复最近一个有效会话的状态。这一过程不是简单地“继续使用”旧会话ID,而是尝试进行会话重连和恢复。客户端会发送一个包含原会话ID的连接请求,Zookeeper接收到这个请求后,会检查该会话ID是否还在其过期会话的重生窗口期内(session timeout时间内设置的一个重生时间窗口)。如果在重生窗口内,且没有新的客户端使用了这个会话ID,Zookeeper服务器可以恢复这个会话,这意味着客户端可以继续使用之前会话的状态和数据,仿佛连接从未中断过一样。
简而言之,客户端不是“继续使用”超时的会话ID,而是通过特定的重连流程尝试恢复这个会话ID所代表的会话状态。如果成功,尽管物理上是建立了新的连接,但从逻辑上看,客户端可以保持会话状态的一致性和连续性,即“会话不丢失”的效果。如果超过了重生窗口期,或者会话ID已被新客户端占用,则无法恢复原有会话,客户端需要创建全新的会话ID。
https://www.runoob.com/w3cnote/zookeeper-watcher.html
Watcher 是 ZooKeeper 中一个很重要的特性。ZooKeeper允许用户在指定节点上注册一些 Watcher,并且在一些特定事件触发的时候,ZooKeeper 服务端会将事件通知到感兴趣的客户端上去。该机制是 ZooKeeper 实现分布式协调服务的重要特性。
——在ZooKeeper中,则是通过客户端对相应的数据path注册Watcher,当数据有更新的时候,服务器会有事件通知,注意,这个通知仅仅是告诉客户端对应的数据有更新了,具体数据内容需要客户端根据自己的情况来决定是否需要获取最新数据。
zookeeper 的 watcher 机制,可以分为四个过程:
若服务端某个被监听的节点发生事务请求,服务端处理请求过程中调用 FinalRequestProcessor 类 processRequest 方法中的代码如下;
删除调用链最终到 DataTree 类中删除节点分支的触发代码段(triggerWatch)
进入 WatchManager 类的 triggerWatch 方法:
继续跟踪进入 NIOServerCnxn,构建了一个 xid 为 -1,zxid 为 -1 的 ReplyHeader 对象,然后再调用 sendResonpe 方法。
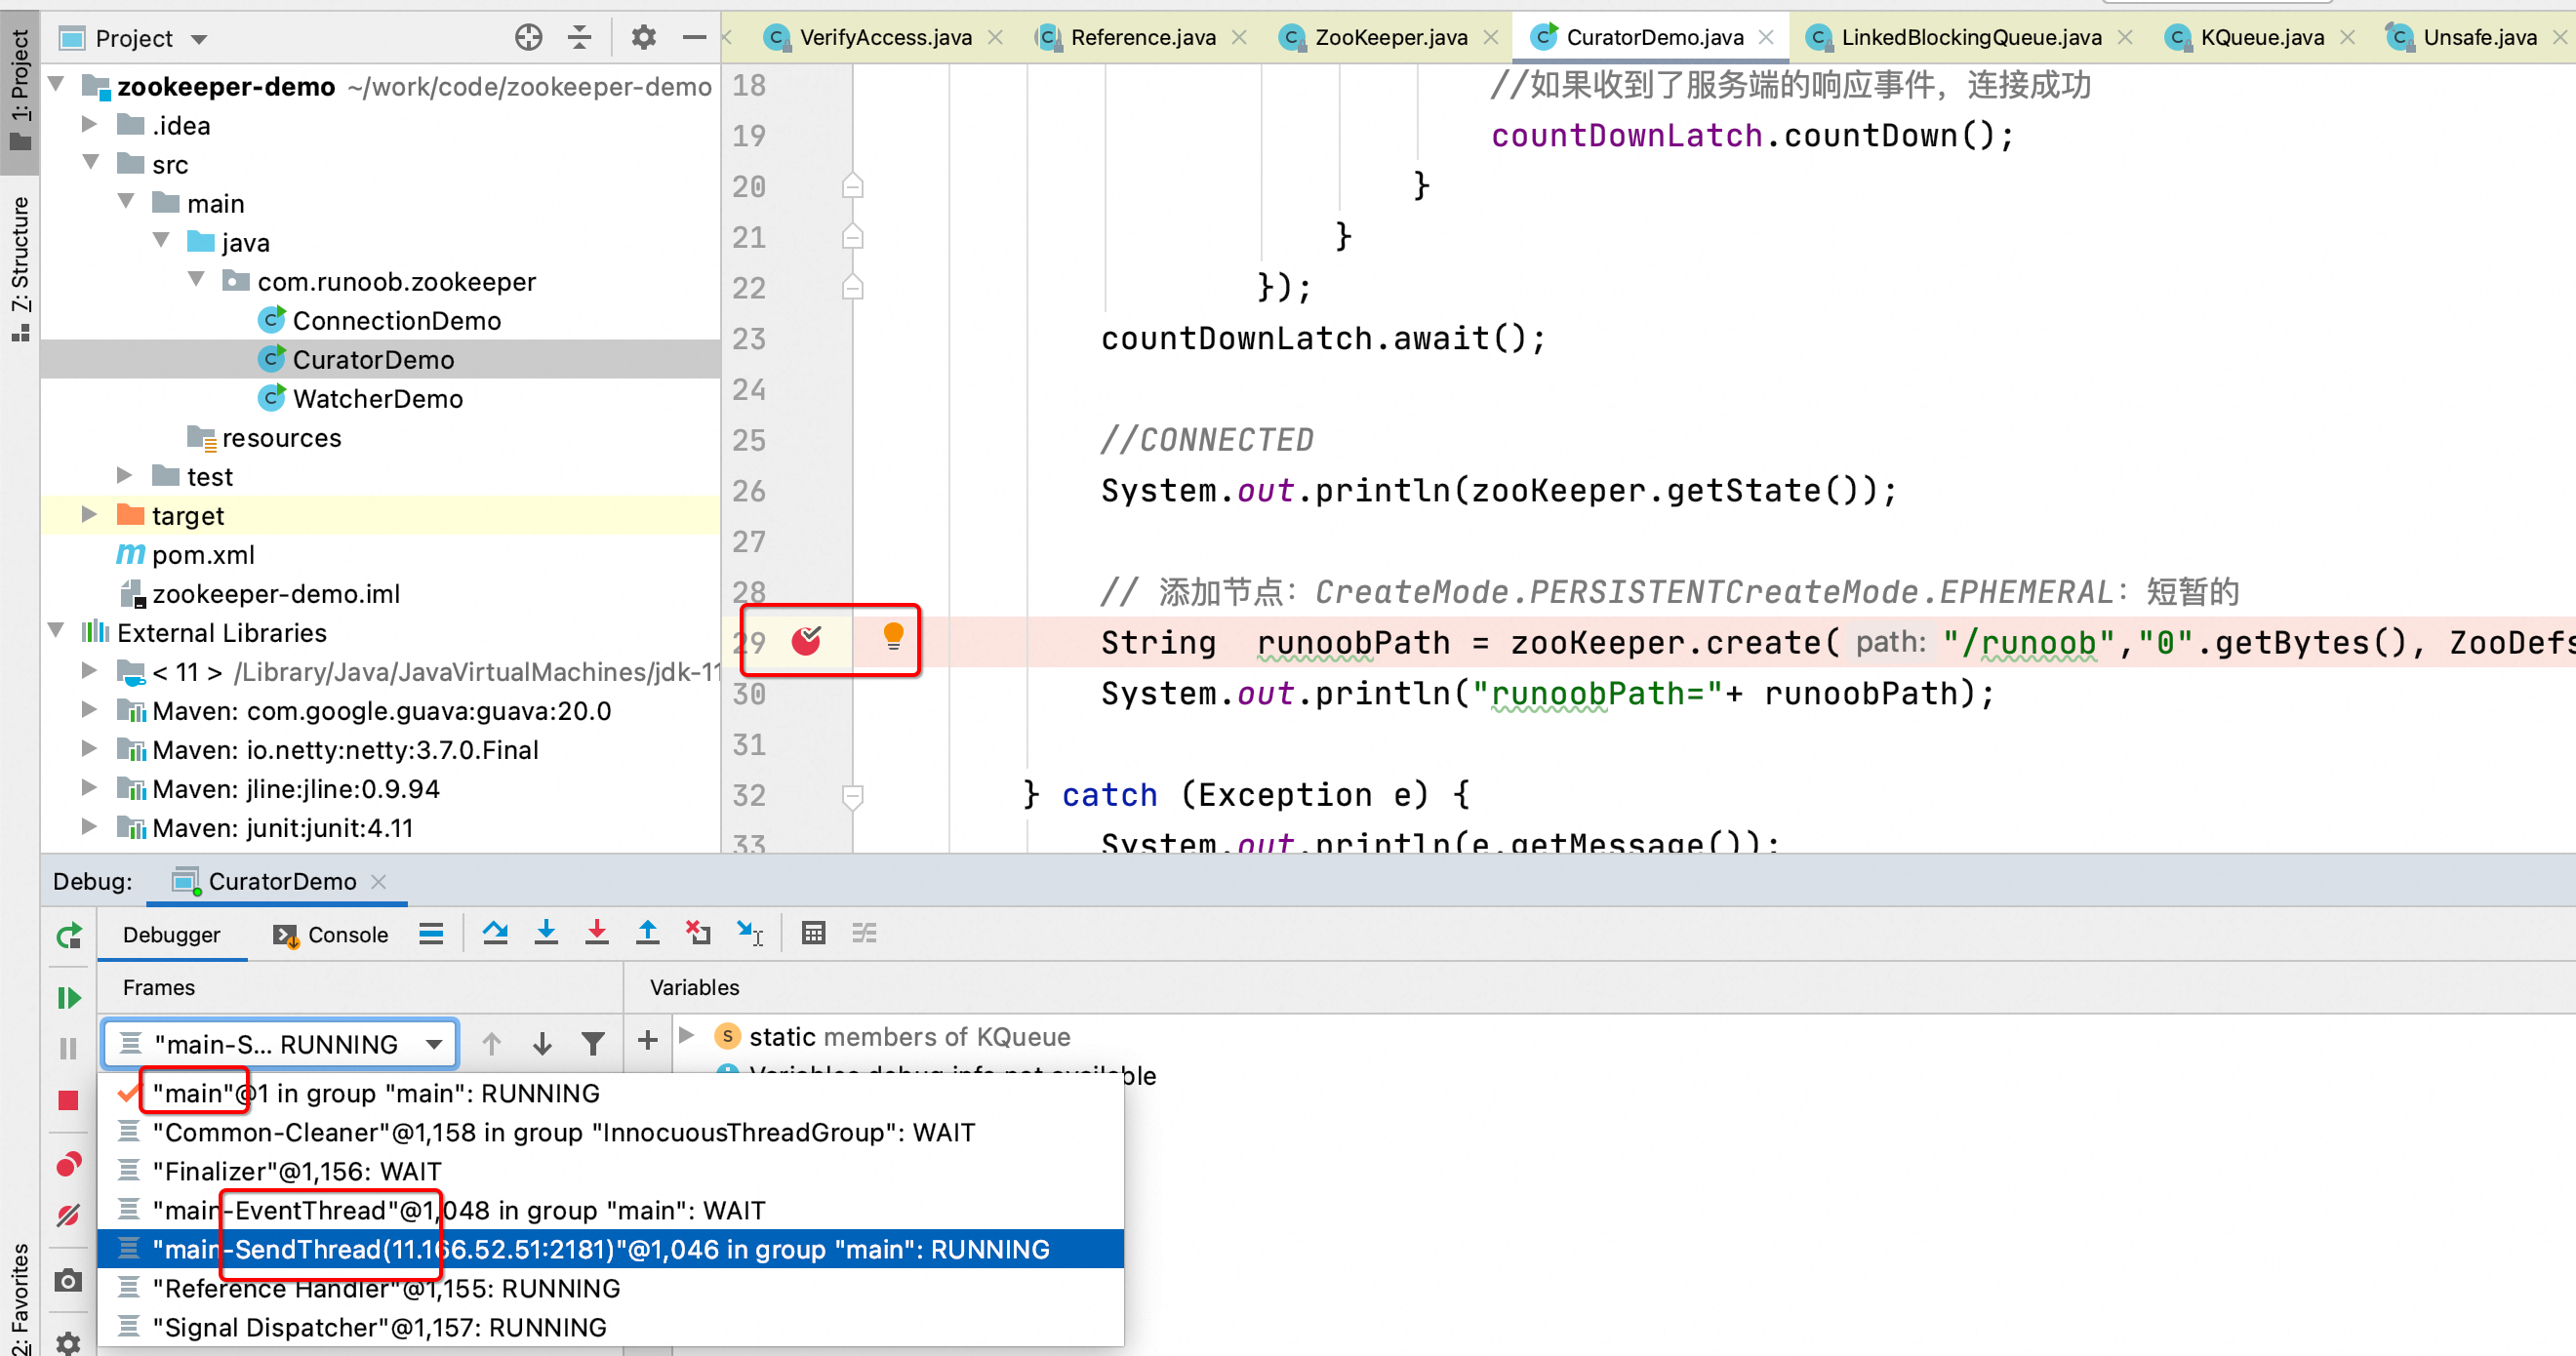
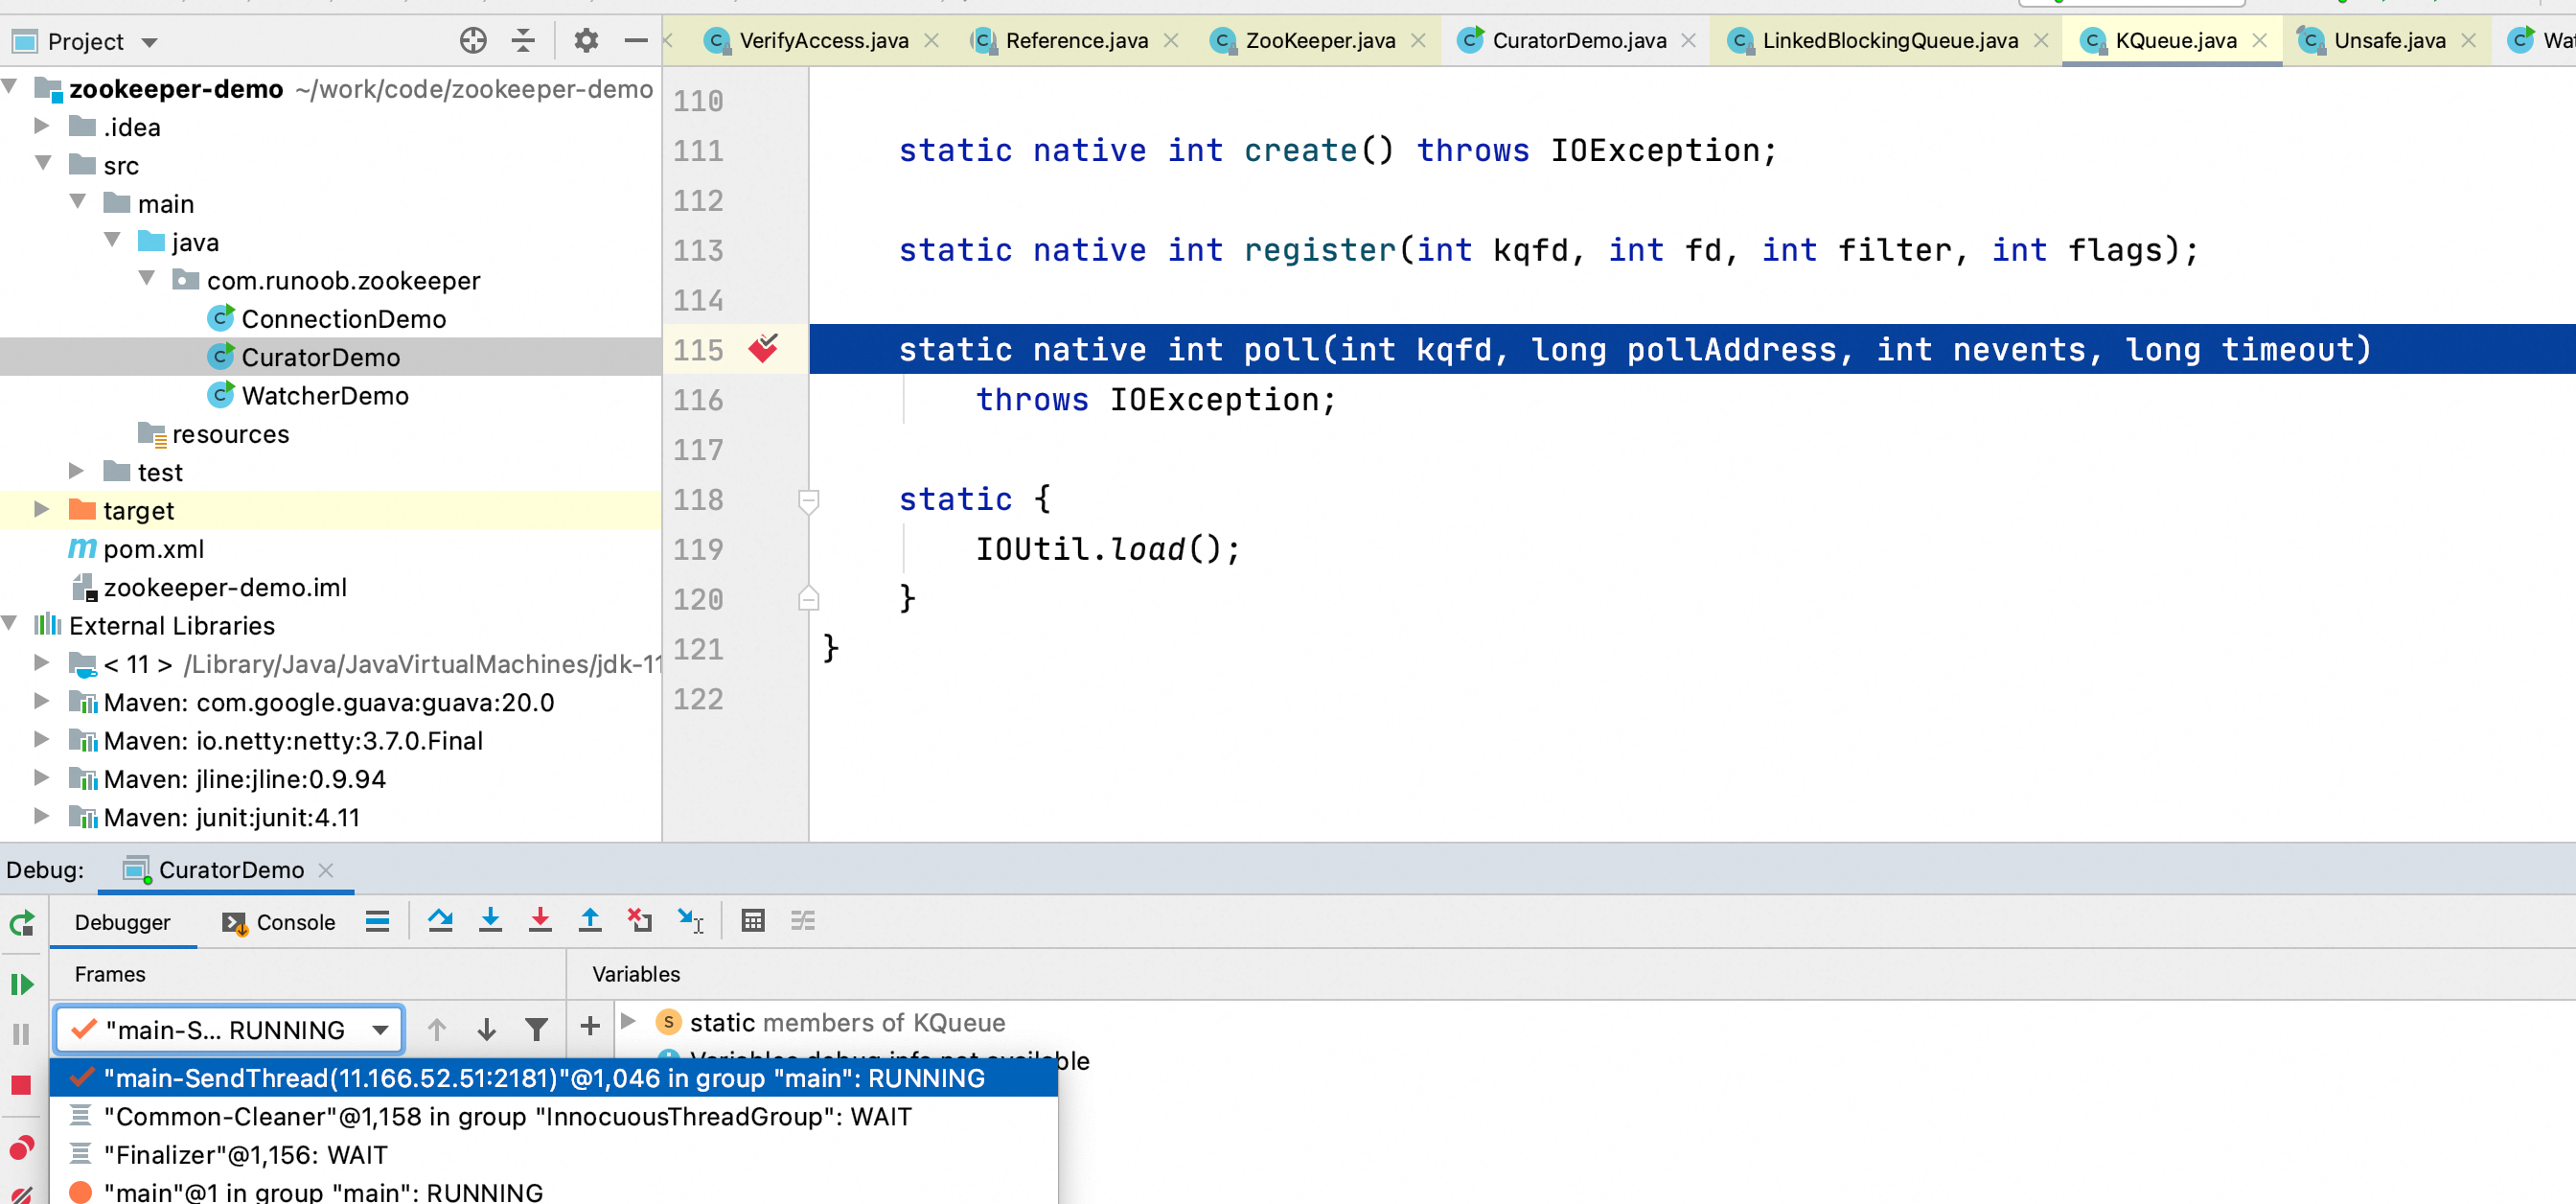
其中客户端注册 watcher 有三种方式,调用客户端 API 可以分别通过 getData、exists、getChildren 实现,利用前面章节创建的 maven 工程,新建 WatcherDemo 类,以 exists 方法举例说明其原理。
注册 watcher 监听事件流程图:
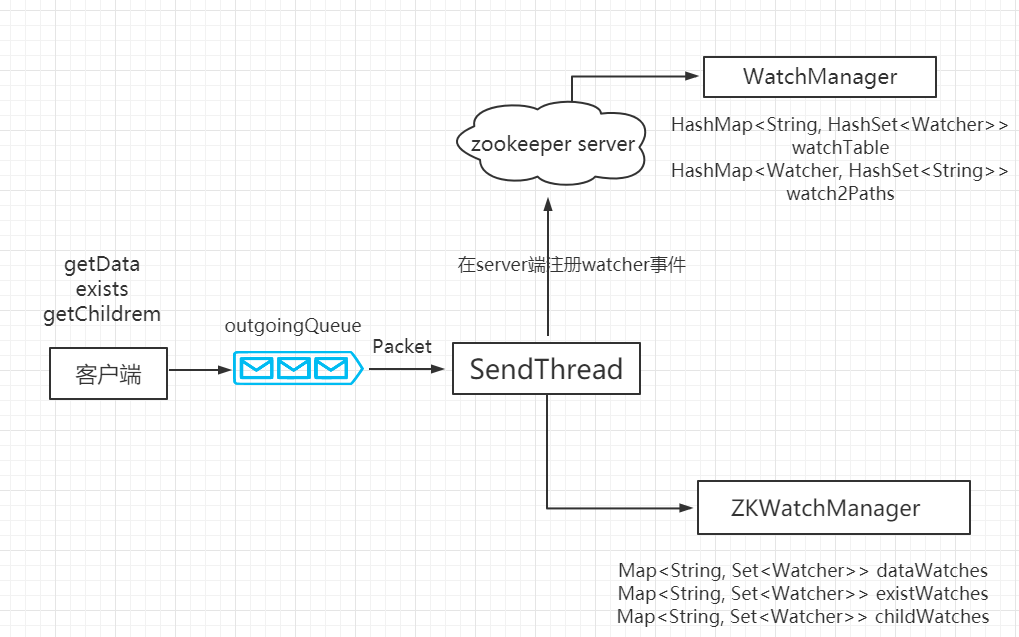
exists部分解释:
当exists("/path/to/node", true)被调用后,如果/path/to/node节点存在,Zookeeper会立即返回一个结果给客户端,并在该节点上设置一个监视器。这个监视器会在以下三种情况被触发:
exists监视器默认不监视子节点列表变化,要监视子节点列表变化需要使用其他API如getChildren并传入true作为watch参数。当监视器被触发时,客户端会收到一个事件通知,并通常会调用之前注册的回调函数(如process方法)来处理这个事件
 1 package com.runoob.zookeeper;
 2
 3 import org.apache.zookeeper.*;
 4 import org.apache.zookeeper.data.Stat;
 5
 6 import java.io.IOException;
 7
 8 public class WatcherDemo implements Watcher {
 9     static ZooKeeper zooKeeper;
10     static {
11         try {
12             // 实例化zooKeeper客户端,最后一个参数为new一个Watcher
13             zooKeeper = new ZooKeeper("11.166.52.51:2181," +
14                     "11.122.160.214:2181,11.165.125.106:2181", 4000, new WatcherDemo());
15         } catch (IOException e) {
16             e.printStackTrace();
17         }
18     }
19
20     // (1)实例化zooKeeper的时候就会执行process;(2)客户端回调watcher的时候也会执行(47行、29行设置了watcher)
21     @Override
22     public void process(WatchedEvent event) {
23         System.out.println("eventType:"+event.getType()); // 事件状态
24         if(event.getType()==Event.EventType.NodeDataChanged){ // 事件状态是否有变化
25             try {
26                 // 处理Watcher事件:这里可以添加更多的逻辑处理,如重新设置Watcher等
27                 // 因为:ZooKeeper的Watcher是一次性触发的,意味着一旦某个事件被触发并通知到客户端,该Watcher就会被移除。
28                 // 如果需要持续监听,客户端必须在收到事件通知后重新设置Watcher。
29                 zooKeeper.exists(event.getPath(),true);
30             } catch (KeeperException e) {
31                 e.printStackTrace();
32             } catch (InterruptedException e) {
33                 e.printStackTrace();
34             }
35         }
36     }
37     public static void main(String[] args) throws IOException, KeeperException, InterruptedException {
38         String path="/watcher";
39         if(zooKeeper.exists(path,false)==null) {
40             zooKeeper.create("/watcher", "0".getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT);
41         }
42         Thread.sleep(1000);
43         System.out.println("-----------");
44
45         // 原注释:true表示使用zookeeper实例中配置的watcher
46         // 当其值为true时,表示客户端希望在指定节点(path)上设置一个监视器(Watcher)
47         Stat stat=zooKeeper.exists(path,true);
48
49         // 当我们在屏幕中输入数据后,是直接放在缓冲区中,记录你每一次的输入,而System.in.read();的工作就是依次从这个缓冲区中读取下一个字符的ASCLL码。(
50         //System.in.read();  这个方法一次只能接收一个输入的字符
51         System.in.read();
52     }
53 }
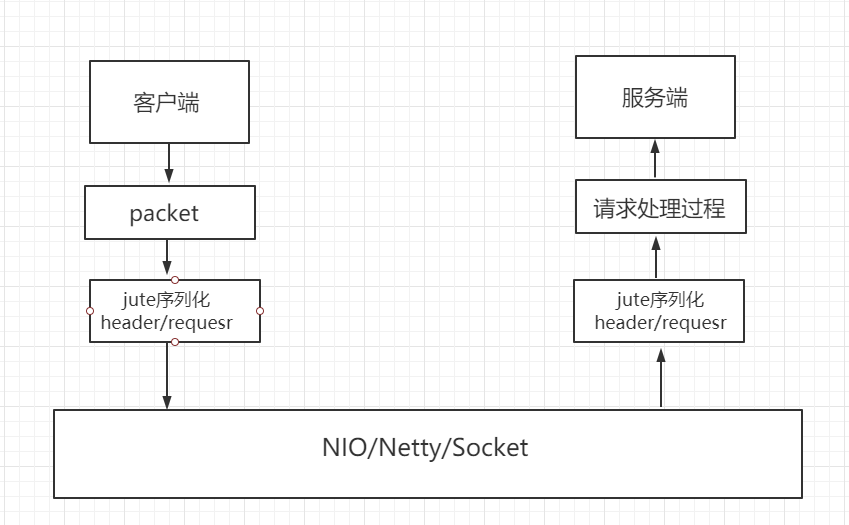
客户端发送请求给服务端是通过 TCP 长连接建立网络通道,底层默认是通过 java 的 NIO 方式,也可以配置 netty 实现方式。
Zookeeper采用ACL(access Control Lists) 策略来进行权限控制,类似于Unix文件系统的权限控制。Zookeeper定义了如下5中权限控制:
注意点这里CREATE和DELETE是针对子节点的权限控制。
本章节介绍一下 zookeeper 的节点特性和简单使用场景,正是由于这些节点特性的存在使 zookeeper 开发出不同的场景应用。
1、同一级节点 key 名称是唯一的
2、创建节点时,必须要带上全路径
3、session 关闭,临时节点清除
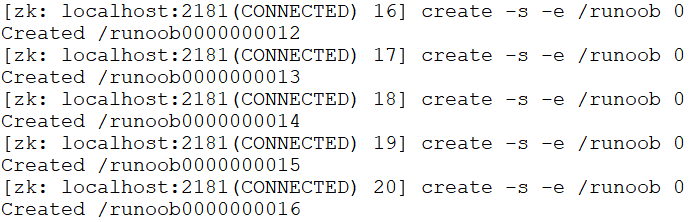
4、自动创建顺序节点(图片)
$ create -s -e /runoob 0
5、watch 机制,监听节点变化
事件监听机制类似于观察者模式,watch 流程是客户端向服务端某个节点路径上注册一个 watcher,同时客户端也会存储特定的 watcher,当节点数据或子节点发生变化时,服务端通知客户端,客户端进行回调处理。特别注意:监听事件被单次触发后,事件就失效了。
6、delete 命令只能一层一层删除 (delete /runoob,提示node not empty)
提示:新版本可以通过 deleteall 命令递归删除。
有了上述众多节点特性,使得 zookeeper 能开发不出不同的经典应用场景,比如:
1. 数据发布/订阅
2. 负载均衡
3. 分布式协调/通知
4. 集群管理
5. 集群管理
6. master 管理
7. 分布式锁
8. 分布式队列
————————————————
版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。
原文链接:https://blog.csdn.net/weixin_40792878/article/details/87099514
https://developer.aliyun.com/article/25656
简介: 本文主要是讨论下两个类似产品:ZooKeeper和Diamond在配置管理这个应用场景上的异同点。 Diamond,顾名思义,寄寓了开发人员对产品稳定性的厚望,希望它像钻石一样,提供稳定的配置访问。Diamond是淘宝网Java中间件团队的核心产品之一,服务于集团线上很多核心应用。目前已经开源,开
本文主要是讨论下两个类似产品:ZooKeeper和Diamond在配置管理这个应用场景上的异同点。
Diamond,顾名思义,寄寓了开发人员对产品稳定性的厚望,希望它像钻石一样,提供稳定的配置访问。Diamond是淘宝网Java中间件团队的核心产品之一,服务于集团线上很多核心应用。目前已经开源,开源地址在:http://code.taobao.org/p/diamond/wiki/index/。
Diamond主要针对的是持久数据,这些数据有个共同的特点是:集群中一批机器都会使用,但是数据的更新频率不大,且希望diamond能够永久存储。
ZooKeeper即可以存储持久数据,也可以存储非持久数据。持久数据和diamond中的持久数据都类似,所谓的非持久数据是指这些数据的生命周期和数据创建者的会话生命周期绑定,一旦会话结束,那么这些非持久数据也会被清除。
本质上,两个产品都是“拉”模式的,即都是通过客户端自己去服务器获取最新数据。具体实现上,两个产品分别如下:
在Diamond中,客户端每隔15s轮询服务器,比对数据是否更新,从而获取最新数据。
在ZooKeeper中,则是通过客户端对相应的数据path注册Watcher,当数据有更新的时候,服务器会有事件通知,注意,这个通知仅仅是告诉客户端对应的数据有更新了,具体数据内容需要客户端根据自己的情况来决定是否需要获取最新数据。
因此在实时性方面,ZooKeeper比Diamond高一些。
在数据存储上,ZooKeeper和Diamond差别比较大。
首先来看下Diamond的数据存储。Diamond的数据存储以mysql数据库为中心,所有在mysql中的数据都是最新的,客户端的所有写请求,都会首先写入数据库,同时会dump数据到Server的本地文件中,所有读请求都是直接走这个静态文件。
在ZooKeeper中,所有运行时数据都是存储在内存中,客户端的所有读写操作都是针对这份内存数据来进行的。同时,内存中的数据,ZK会以快照的形式dump到指定文件中去,配合事务日志,帮助服务器在下次重启的时候,能够加载正确的数据到内存中去。
Diamond的数据都是以行组织的,这也更便于它使用mysql来管理数据。Diamond的基本数据结构包含dataid,group和content,根据group,可以将一组相关的数据组合起来。
ZooKeeper中,使用树形结构来组织数据,每个节点类似于一个文件系统的路径,一个节点下面也可以创建多个子节点来规则一些相关的数据。
在容灾方面,diamond做得相当的完备:
1. 所有客户端的读请求,都是直接读取服务器端的本地静态文件,因此,即使数据库挂了,都不会影响diamond的读服务。而读服务在所有使用diamond的应用场景中,占到了绝大部分。
2. Diamond客户端还保存了数据的快照,客户端每次从服务器成功获取数据后,都会把这份数据保存到本地文件系统中,称为快照文件。这个快照文件是为了防止在服务器无法获取数据的时候,能够在这个快照中获取数据。
3. 客户端还会有一个容灾目录,变个容灾目录是在服务器完全不可用的时候,运维人员可以手动在这个容灾目录中创建相关目录结构的数据,diamond就就会优先从这个目录中获取数据。
4. 说到这里,我们就可以给diamond的数据获取优先级作一个总结:
首先都会从容灾目录中获取数据——无法从容灾目录获取数据的话,就通过网络到服务器请求数据——如果无法从服务器获取数据,那么就从本地的snapshot中获取数据。
接下来看看ZooKeepe的容灾,做得很少,只有以下一点:
1. ZooKeeper实现了paxos算法,有效的解决了分布式单点问题。以一个3台机器构成的集群为例,任意一台ZK挂掉,都不会影响集群的数据一致性。
总结:在容灾方面,diamond有很大的优势,也符合了diamond的稳定性要求。
Diamond对单个数据的大小,没有严格的限制,通常2M左右的数据大小都是没有问题的。而在ZooKeeper中,由于全量数据都是存储在内存中,并且需求进行集群机器间的数据两步,所以对单个数据的大小有严格的限制,默认单个数据节点的最大数据大小是1M。
Diamond支持对数据的追加与聚合功能,即对同一个dataid的写入操作,可以设置为追加。而ZooKeeper目前不支持,只有覆盖写。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。