





一, 红黑树所处数据结构的位置:
在JDK源码中, 有treeMap和JDK8的HashMap都用到了红黑树去存储
红黑树可以看成B树的一种:
从二叉树看,红黑树是一颗相对平衡的二叉树
二叉树-->搜索二叉树-->平衡搜索二叉树--> 红黑树
从N阶树看,红黑树就是一颗 2-3-4树
N阶树-->B(B-)树
故我提取出了红黑树部分的源码,去说明红黑树的理解
看之前,理解红黑树的几个特性,后面的操作都是为了让树符合红黑树的这几个特性,从而满足对查找效率的O(logn)
二,红黑树特性,以及保持的手段
1,根和叶子节点都是黑色的
2,不能有有连续两个红色的节点
3, 从任一节点到它所能到达得叶子节点的所有简单路径都包含相同数目的黑色节点
这几个特效,个人理解就是规定了红黑树是一颗2-3-4的B树了,从而满足了O(logn)查找效率
保持特性的手段,通过下面这些手段,让红黑树满足红黑树的特性,如果要尝试理解,可以从2-3-4树的向上增长,后面有详细介绍
当然,这些改变也都是在O(logn)内完成的,主要改变方式有
1, 改变颜色
2, 左旋
3, 右旋
三,从JDK源码来理解
主要看我的注释,逻辑的理解
先看TreeMap
再看看HashMap的实现,
在HashMap中,在JDK8后开始用红黑树代替链表,查找由O(n) 变成了 O(Logn)
源码分析如下:
红黑树的维护代码部分如下:
情况图如下
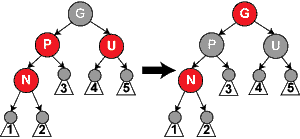
情况1

情况2
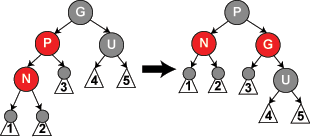
情况3
JDK源码处理红黑树的流程图

可见,其实处理逻辑实现都一样的
三,个人对红黑树理解的方法
1, 如何理解红黑树的O(lgN)的特性?
从2-3-4树去理解
红黑树,其实是一颗 2-3-4的B树,B树都是向上增长的,如果不理解向上增长可以先看看2-3树,这样理解就能知道为什么能O(logn)的查找了
2, 如何理解红黑树的红黑节点意义?
可以把红色节点看成是连接父节点的组成的一个大节点(2个或3个或4个节点组成的一个key),如下:

(此图转自网上)
红色的就是和父节点组成了大节点,
比如
节点7和6,6是红色节点组成,故和它父节点7组成了一个大节点,即 2-3-4树的 6, 7节点
又如
节点 9和10和11,9和10为红色节点,故和10组成了一个2-3-4的3阶节点, 9,10,11(注意顺序有的关性)
3 , B树是如何保持O(lgn)的复杂度的呢?
B+树都是从底布开始往上生长,自动平衡,如 2-3-4树,当节点达到了3个时晋升到上个节点,所以不会产生单独生长一边的情况,形成平衡。
留个问题
4, 数据库里的索引为什么不用红黑树而是用B+树(Mysql)呢?
后续解答
欢迎关注我的公众号,重现线上各种BUG, 一起来构建我们的知识体系

此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。