






在数据仓库和商业智能(BI)领域,Ralph Kimball 被誉为“维度建模之父”。他提出的 Kimball 维度建模 方法论,以其简单易懂、高性能、快速落地的特点,成为全球无数企业和数据团队的首选架构。
不同于 Bill Inmon “先建企业级数据仓库,再建数据集市”的自上而下思路,Kimball 倡导自下而上的构建方式:从具体的业务过程出发,先快速交付能解决实际业务问题的数据集市,最终通过一致性维度拼成企业级数据仓库。
今天,我们就来全面、深入地拆解 Kimball 维度建模,并结合真实业务案例帮你更好地理解和应用。
以业务过程为驱动,以用户理解和查询性能为目标。
Kimball 认为,数据仓库的最终用户是业务分析师和报表开发人员,而不是数据库专家。因此模型必须像星空一样清晰直观,让非技术人员也能快速看懂。
核心理念:
以一家大型电商平台为例,我们来走一遍完整的 Kimball 维度建模四步法。
选择一个清晰的业务活动。例如:
粒度决定一切。
正确做法:订单中的每一行商品(一行记录代表“2025年4月5日,用户ID=123 在上海门店购买了1件 iPhone16,单价 5999 元”)。
错误做法:按“每天订单汇总”或“每月销售额汇总”作为粒度(这样会丢失大量分析灵活性)。
案例粒度声明:
本事实表的粒度为:每个订单的每个商品行(Order Line Level)。
回答经典的“Who、What、Where、When、Why、How”问题。
针对电商订单支付过程,常用维度包括:
事实表中保存可度量、可聚合的数值指标:
| 代理键 | 维度外键 | 度量值 |
|---|---|---|
| order_key | date_key product_key customer_key store_key promotion_key |
order_amount paid_amount quantity discount_amount |
事实表特点:
| product_key(代理键) | product_id(自然键) | product_name | category | subcategory | price | start_date | end_date | is_current |
|---|---|---|---|---|---|---|---|---|
| 10001 | P001 | iPhone 16 | 手机 | 智能手机 | 5999 | 2025-09-01 | 9999-12-31 | Y |
| 10002 | P001 | iPhone 16 | 手机 | 智能手机 | 5799 | 2025-03-01 | 2025-08-31 | N |
缓慢变化维(SCD)处理:
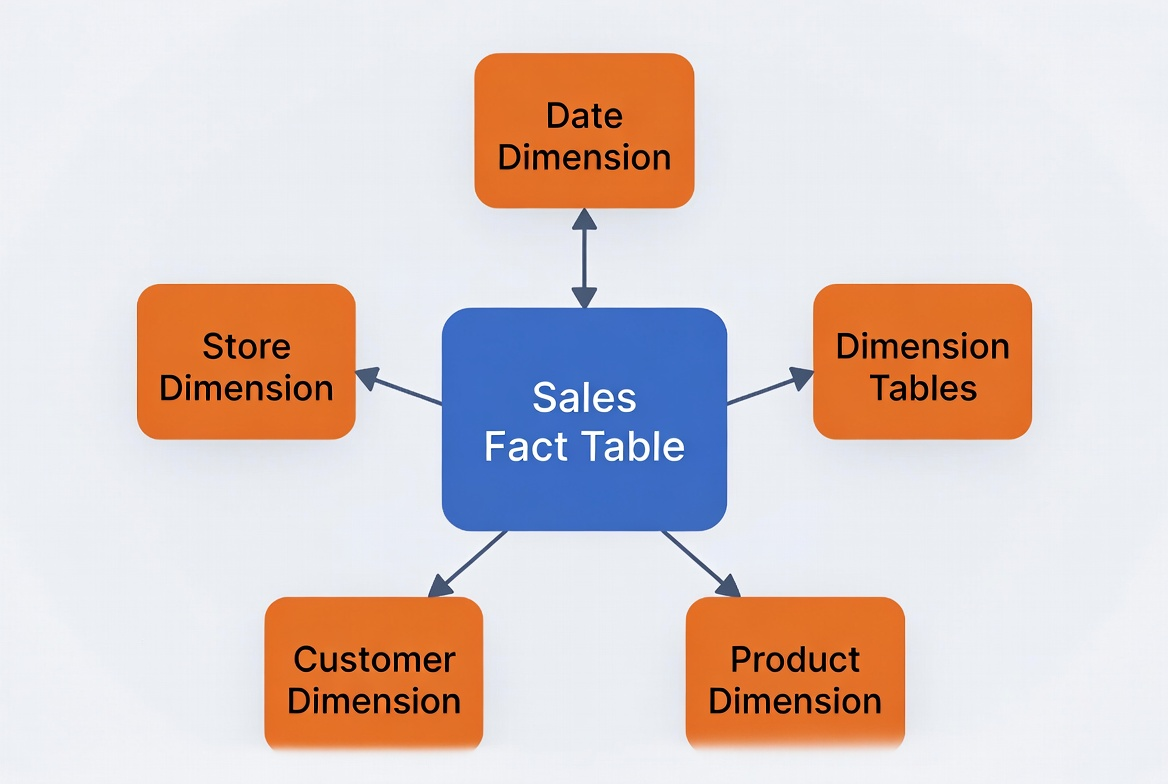
Kimball 强烈推荐星型模型:
雪花模型虽然更“规范化”,但会显著增加 Join 次数,在大数据环境下往往得不偿失。
当你为“销售”“库存”“物流”“营销”分别构建多个数据集市后,如何保证它们能相互关联分析?
解决方案:
电商企业总线矩阵示例:
| 业务过程 \ 维度 | 日期 | 产品 | 客户 | 门店 | 促销 | 供应商 |
|---|---|---|---|---|---|---|
| 订单支付 | ✓ | ✓ | ✓ | ✓ | ✓ | |
| 库存快照 | ✓ | ✓ | ✓ | ✓ | ||
| 物流发货 | ✓ | ✓ | ✓ | ✓ | ||
| 营销活动 | ✓ | ✓ | ✓ | ✓ |
通过总线矩阵,你可以清晰看到哪些维度需要做成一致性维度,从而实现跨事实表的 Drill-across 分析(例如:分析“某个促销活动在不同门店的销售转化率和库存周转率”)。
Kimball 维度建模不是追求数据库理论上的“完美”,而是追求“报表出得快、业务用得好”。
它像一把实用主义利器:在过去二十多年里,帮助无数企业从混乱的数据泥潭中走出来,快速构建起支持决策的数据体系。
在 2026 年的今天,虽然技术栈从传统数仓演进到 Lakehouse、大模型辅助建模,但 Kimball 的核心思想——以业务为驱动、以用户理解为目标、坚持星型/宽表设计,依然是数据仓库领域最经得起时间考验的方法论。
推荐阅读:
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。