








请关注微信公众号:阿呆-bot
Apache Hudi 采用多模块 Maven 架构,主要模块如下:
hudi-master/
├── hudi-common/              # 核心通用功能模块
│   └── src/main/java/org/apache/hudi/common/
│       ├── model/            # 数据模型(HoodieRecord, HoodieKey等)
│       ├── table/            # 表元数据管理
│       └── timeline/         # 时间线管理
├── hudi-client/              # 客户端实现
│   ├── hudi-client-common/   # 客户端通用基类
│   ├── hudi-spark-client/    # Spark客户端
│   ├── hudi-flink-client/    # Flink客户端
│   └── hudi-java-client/     # Java客户端
├── hudi-spark-datasource/    # Spark数据源集成
│   ├── hudi-spark-common/    # Spark通用功能
│   └── hudi-spark3.5.x/      # Spark 3.5版本实现
├── hudi-flink-datasource/    # Flink数据源集成
│   └── hudi-flink1.20.x/     # Flink 1.20版本实现
├── hudi-utilities/           # 工具类和实用程序
├── hudi-sync/                # 元数据目录同步
│   ├── hudi-hive-sync/       # Hive元数据同步
│   └── hudi-sync-common/      # 同步通用功能
├── hudi-io/                  # I/O操作和存储格式
├── hudi-cli/                 # 命令行工具
│   └── src/main/java/org/apache/hudi/cli/
│       ├── Main.java         # CLI入口类
│       └── HoodieCLI.java   # CLI核心类
├── hudi-hadoop-common/       # Hadoop通用功能
├── hudi-hadoop-mr/           # MapReduce支持
├── hudi-kafka-connect/        # Kafka连接器
├── hudi-timeline-service/    # 时间线服务
├── hudi-platform-service/    # 平台服务
├── hudi-examples/            # 示例代码
│   ├── hudi-examples-spark/  # Spark示例
│   └── hudi-examples-flink/  # Flink示例
└── packaging/                # 打包模块
    ├── hudi-spark-bundle/    # Spark bundle
    └── hudi-flink-bundle/    # Flink bundle
入口类:
hudi-cli/src/main/java/org/apache/hudi/cli/Main.java - CLI工具入口hudi-client/hudi-spark-client/.../SparkRDDWriteClient.java - Spark写入客户端hudi-client/hudi-flink-client/.../HoodieFlinkWriteClient.java - Flink写入客户端核心类:
hudi-common/.../HoodieTableMetaClient.java - 表元数据客户端hudi-common/.../HoodieTimeline.java - 时间线管理hudi-client/.../BaseHoodieWriteClient.java - 写入客户端基类Hudi 采用分层架构设计,从下到上分为存储层、核心层、引擎层和应用层:

这是最常用的场景,通过 SparkRDDWriteClient 写入数据到 Hudi 表:
// 1. 创建 Spark 上下文
JavaSparkContext jsc = new JavaSparkContext(sparkConf);

// 2. 配置 Hudi 写入参数
HoodieWriteConfig cfg = HoodieWriteConfig.newBuilder()
    .withPath(tablePath)
    .withSchema(schema)
    .forTable(tableName)
    .withIndexConfig(HoodieIndexConfig.newBuilder()
        .withIndexType(HoodieIndex.IndexType.BLOOM).build())
    .build();

// 3. 创建写入客户端
SparkRDDWriteClient<HoodieAvroPayload> client =
    new SparkRDDWriteClient<>(new HoodieSparkEngineContext(jsc), cfg);

// 4. 开始一个提交
String commitTime = client.startCommit();

// 5. 准备数据并插入
List<HoodieRecord<HoodieAvroPayload>> records = generateRecords();
JavaRDD<HoodieRecord<HoodieAvroPayload>> writeRecords = jsc.parallelize(records);
client.insert(writeRecords, commitTime);

// 6. 更新数据
commitTime = client.startCommit();
List<HoodieRecord<HoodieAvroPayload>> updates = generateUpdates();
writeRecords = jsc.parallelize(updates);
client.upsert(writeRecords, commitTime);
通过 Spark SQL 直接查询 Hudi 表,非常简单:
// 读取 Hudi 表
val hudiDF = spark.read.format("hudi").load(basePath)

// 查询数据
hudiDF.filter("partition = '2023/01/01'").show()

// 增量查询
val incrementalDF = spark.read.format("hudi")
  .option(DataSourceReadOptions.QUERY_TYPE.key(), DataSourceReadOptions.QUERY_TYPE_INCREMENTAL_OPT_VAL)
  .option(DataSourceReadOptions.BEGIN_INSTANTTIME.key(), "20230101000000")
  .load(basePath)
Hudi 提供了自动化的表服务,比如压缩和清理:
// 压缩(Merge-on-Read 表需要)
Option<String> compactionInstant = client.scheduleCompaction(Option.empty());
HoodieWriteMetadata<JavaRDD<WriteStatus>> compactionMetadata =
    client.compact(compactionInstant.get());
client.commitCompaction(compactionInstant.get(), compactionMetadata, Option.empty());

// 清理旧文件
client.clean(cleanInstant);
hudi-cli) - 命令行工具入口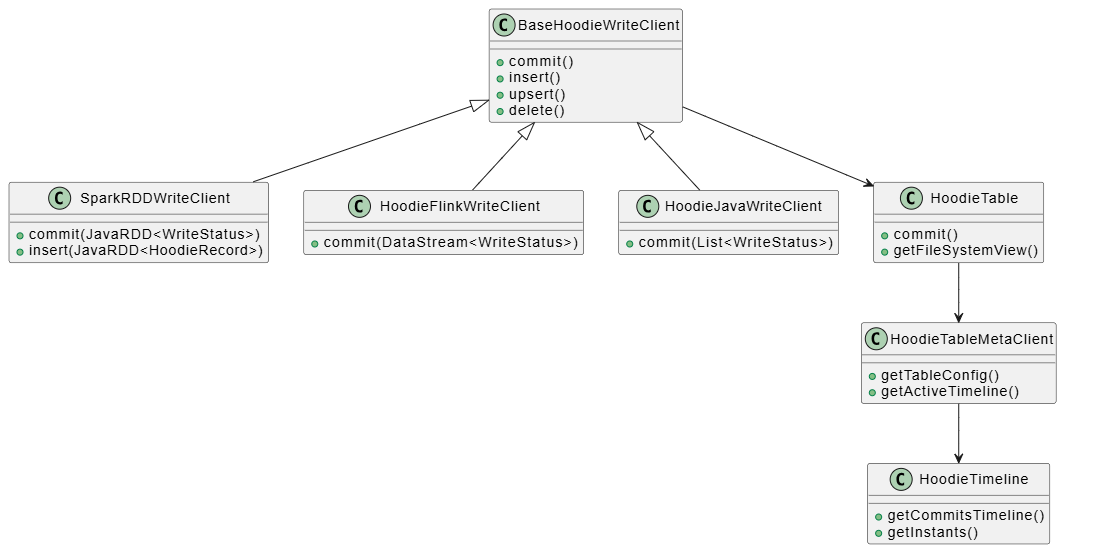
Hudi 的核心外部依赖包括:
Apache Hudi 是一个设计精良的数据湖平台,具有以下特点:
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。