








Иногда значение меняется на эквивалентное. И здесь существуют разные подходы к отсечению вырожденных вычислений в реактивной архитектуре…
👯 Every: Реакция на каждое действие
🆔 Identity: Сравнение по ссылке
🎭 Equality: Структурное сравнение
🔀 Reconcile: Структурное согласование
👯 Every: Реакция на каждое действие
В библиотеках типа RxJS каждое значение — это уникальное событие, из-за чего реакции срабатывают лишний раз.
777 != 777Чтобы этого избежать, нужно писать дополнительный код, который часто забывают и потом огребают.
🆔 Identity: Сравнение по ссылке
Многие библиотеки всё же сравнивают значения. Если состояние не изменилось, реакции не срабатывают. Если изменилось, даже на эквивалентное значение — срабатывают.
        777 == 777
[ 1, 2, 3 ] != [ 1, 2, 3 ]
Если мы нафильтровали новый массив с тем же содержимым, скорее всего, не нужно запускать каскад вычислений. Но вручную отслеживать все такие места нереалистично.
🎭 Equality: Структурное сравнение
Самые продвинутые библиотеки, как $mol_wire, делают глубокое сравнение нового и старого значения. В некоторых, например CellX, это можно включить в настройках.
        777 == 777
[ 1, 2, 3 ] == [ 1, 2, 3 ]
[ 1, 2, 3 ] != [ 3, 2, 1 ]
Это позволяет отсекать лишние вычисления как можно раньше — при внесении изменений, а не при рендеринге VDOM в реальный DOM, как часто бывает в React, чтобы понять, что менять в DOM ничего и не нужно.
Глубокое сравнение, конечно, дороже простой проверки ссылок. Но рано или поздно всё равно придётся сравнивать содержимое. Лучше делать это, когда данные рядом, а не когда они разбросаны по тысячам компонентов во время рендеринга.
Однако если данные изменились, они дальше пройдут по приложению и будут сравниваться глубоко снова и снова, что плохо. Поэтому важно реализовать кэширование результата глубокого сравнения для каждой пары объектов, но при этом не допустить утечек памяти.
🔀 Reconcile: Структурное согласование
Наконец, можно пойти ещё дальше и не просто глубоко сравнивать значения, а согласовывать их, сохраняя ссылки на старые объекты, если они эквивалентны новым.
const A = { foo: 1, bar: [] }
const B = { foo: 2, bar: [] }

reconcile( A, B )

assert( B.foo === 2 )
assert( B.bar === A.bar )
Как видим, A и B здесь разные, но свойство bar осталось прежним. Это хорошо для сборщика мусора, так как мы переиспользуем объекты из старого поколения. Объект из молодого поколения был отброшен при согласовании, что очень быстро.
Кроме того, при следующей проверке компонента, рендерящего bar, это будет очень быстро, так как старое и новое значения совпадут. Если объекты всё же отличаются, повторная проверка пройдёт по всем внутренностям. Здесь снова нужен кэш. Но…
Изменять поля нового объекта значениями из старого не всегда безопасно. Например, с DOM-элементами так не получится. В лучшем случае не сработает, в худшем — сломает. Иногда будет исключение при попытке изменить объект, иногда изменения просто игнорируются, а иногда срабатывают сеттеры с непредсказуемым результатом.
Кроме того, если объекты идентичны, сначала нужно глубоко сравнить их. Если они одинаковы — вернуть старый, иначе начать менять новый. Или сразу менять новый, а потом понять, что все свойства изменены, и вернуть старый.
По итогу, этот подход всё же не самый быстрый и надёжный, поэтому в $mol_wire мы от него отказались в пользу глубокого сравнения с кэшированием.
Быстрое глубокое сравнение
Некоторые объекты (например, Value Object) можно сравнивать структурно, другие (например, DOM-элементы или бизнес-сущности) — нет. Как их различать?
Стандартные типы (массивы, структуры, регулярные выражения и т.п.) можно просто определить и сравнивать структурно.
С пользовательскими сложнее. По умолчанию рисковать не будем и сравним по ссылке. Но если в объекте объявлен метод Symbol.toPrimitive, считаем, что это сериализуемый объект, значит такие объекты можно сравнивать по сериализованному представлению.
class Moment {

    iso8601:string
    timestamp: number
    native: Date

    [ Symbol.toPrimitive ]( mode: 'number' | 'string' | 'default' ) {
        switch( mode ) {
            case 'number': return this.timestamp
            case 'string': return this.iso8601
            case 'default': return this.iso8601
        }
    }

}
Если при глубоком сравнении структур мы нашли, что они в целом разные, то при обходе их поддеревьев бездумно сравнивать их снова не стоит — мы уже это сделали. Поэтому результат глубокого сравнения пар объектов кэшируем в двойном WeakMap, что обеспечивает автоматическую очистку кэша при сборке мусора.
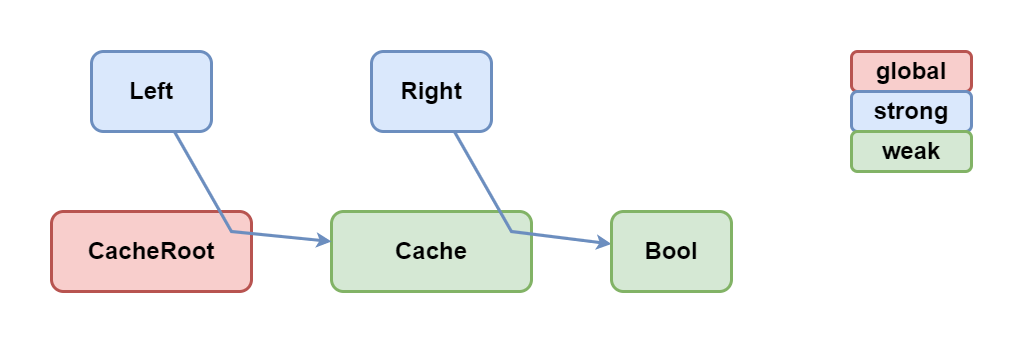
После сравнения один из объектов Left или Right обычно отбрасывается. В первом случае освобождается весь кэш и данные, значит при изменении значения не будет лишних данных в памяти. Во втором случае освобождаются только данные, а кэш остаётся для будущих сравнений, что предотвращает лишнее выделение кэша при частом появлении эквивалентных значений.
Наконец, в данных могут быть циклические ссылки. Как минимум, нельзя уходить в бесконечный цикл. Желательно сравнивать их корректно.
Например, следующие два объекта структурно эквивалентны:
const left = { id: 'leaf', kids: [] }
left.kids.push({ id: 'son', parent: left })

const right = { id: 'leaf', kids: [] }
right.kids.push({ id: 'son', parent: right })
Поддерживать циклические ссылки несложно, если есть кэш. Сначала записываем в него, что объекты эквивалентны, и углубляемся. Если встречаем пару снова — берём из кэша и идём дальше. Если найдём различия — позже исправим кэш, что объекты не эквивалентны.
В итоге получилась библиотека $mol_compare_deep размером 1 килобайт, которая в несколько раз компактнее и быстрее всех остальных в NPM:

🤹 Обоснованность вычислений
Лишние вычисления сами по себе постепенно замедляют приложение. Но это пол беды. Каждое лишнее вычисление приводит к другим лишним вычислениям. В результате чего лишние вычисления растут как снежный ком.

Поэтому, чем раньше мы их остановим, тем меньше ресурсов суммарно потратим. А значит получим более отзывчивое приложение, меньше жрущее батарейку. Именно поэтому в $mol_wire, в отличие от всех остальных стейт-менеджеров, глубокое структурное сравнение значений является поведением по умолчанию. И это далеко не единственно место его применения, но об остальных мы поговорим в другой раз.
А пока, подписывайтесь на что-нибудь, вступайте во что-то там, и держите руку на пульсе вот этого вот.