



发表于 | 分类于 Flink |
原文:https://data-artisans.com/blog/how-apache-flink-manages-kafka-consumer-offsets
作者:Fabian Hueske, Markos Sfikas
译者:云邪(Jark)
在本周的《Flink Friday Tip》中,我们将结合例子逐步讲解 Apache Flink 是如何与 Apache Kafka 协同工作并确保来自 Kafka topic 的消息以 exactly-once 的语义被处理。
检查点(Checkpoint)是使 Apache Flink 能从故障恢复的一种内部机制。检查点是 Flink 应用状态的一个一致性副本,包括了输入的读取位点。在发生故障时,Flink 通过从检查点加载应用程序状态来恢复,并从恢复的读取位点继续处理,就好像什么事情都没发生一样。你可以把检查点想象成电脑游戏的存档一样。如果你在游戏中发生了什么事情,你可以随时读档重来一次。
检查点使得 Apache Flink 具有容错能力,并确保了即时发生故障也能保证流应用程序的语义。检查点是以固定的间隔来触发的,该间隔可以在应用中配置。
Apache Flink 中实现的 Kafka 消费者是一个有状态的算子(operator),它集成了 Flink 的检查点机制,它的状态是所有 Kafka 分区的读取偏移量。当一个检查点被触发时,每一个分区的偏移量都被存到了这个检查点中。Flink 的检查点机制保证了所有 operator task 的存储状态都是一致的。这里的“一致的”是什么意思呢?意思是它们存储的状态都是基于相同的输入数据。当所有的 operator task 成功存储了它们的状态,一个检查点才算完成。因此,当从潜在的系统故障中恢复时,系统提供了 excatly-once 的状态更新语义。
下面我们将一步步地介绍 Apache Flink 中的 Kafka 消费位点是如何做检查点的。在本文的例子中,数据被存在了 Flink 的 JobMaster 中。值得注意的是,在 POC 或生产用例下,这些数据最好是能存到一个外部文件系统(如HDFS或S3)中。
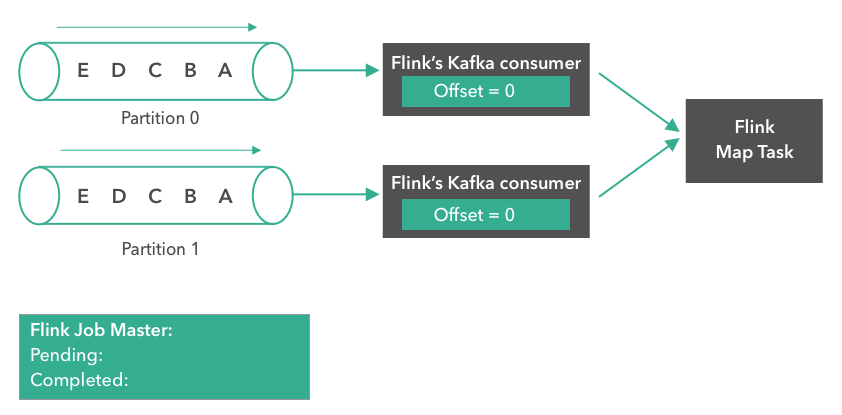
第一步:
如下所示,一个 Kafka topic,有两个partition,每个partition都含有 “A”, “B”, “C”, ”D”, “E” 5条消息。我们将两个partition的偏移量(offset)都设置为0.
第二步:
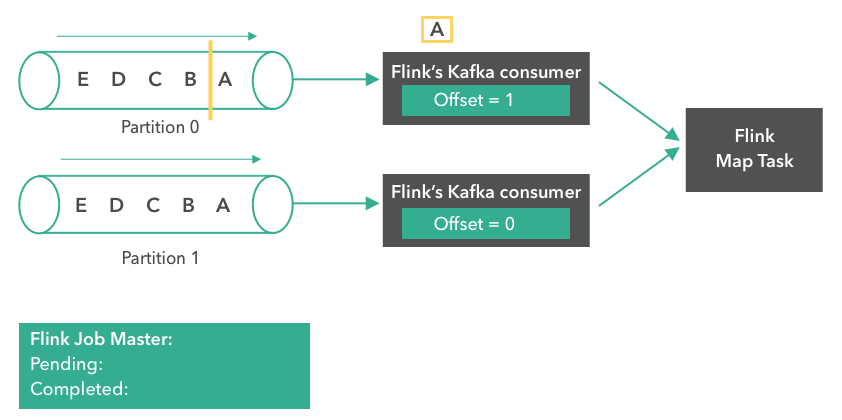
Kafka comsumer(消费者)开始从 partition 0 读取消息。消息“A”正在被处理,第一个 consumer 的 offset 变成了1。
第三步:
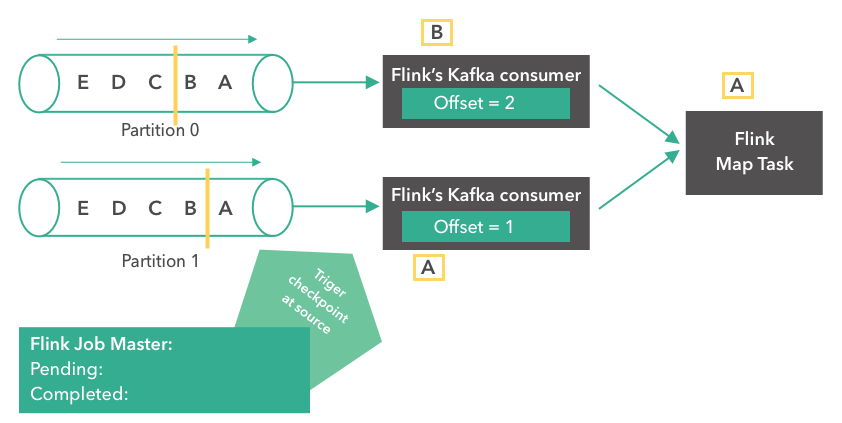
消息“A”到达了 Flink Map Task。两个 consumer 都开始读取他们下一条消息(partition 0 读取“B”,partition 1 读取“A”)。各自将 offset 更新成 2 和 1 。同时,Flink 的 JobMaster 开始在 source 触发了一个检查点。
第四步:
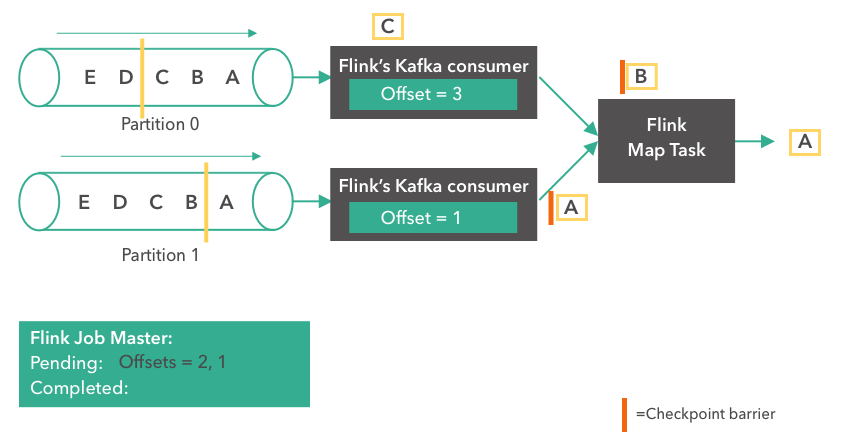
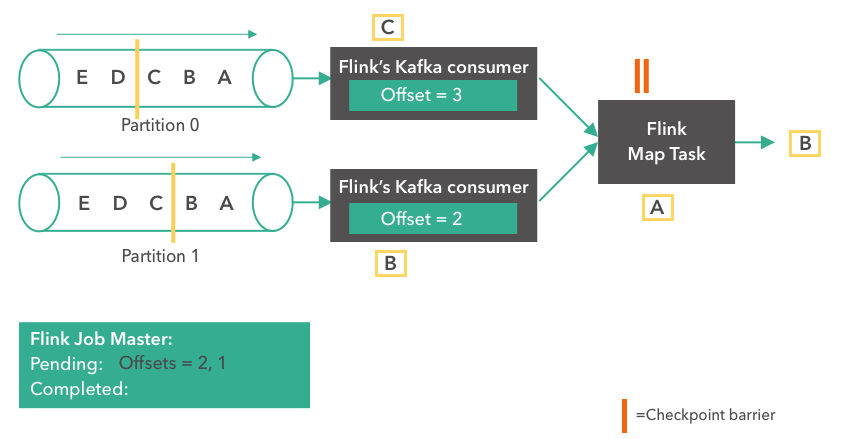
接下来,由于 source 触发了检查点,Kafka consumer 创建了它们状态的第一个快照(”offset = 2, 1”),并将快照存到了 Flink 的 JobMaster 中。Source 在消息“B”和“A”从partition 0 和 1 发出后,发了一个 checkpoint barrier。Checkopint barrier 用于各个 operator task 之间对齐检查点,保证了整个检查点的一致性。消息“A”到达了 Flink Map Task,而上面的 consumer 继续读取下一条消息(消息“C”)。
第五步:
Flink Map Task 收齐了同一版本的全部 checkpoint barrier 后,那么就会将它自己的状态也存储到 JobMaster。同时,consumer 会继续从 Kafka 读取消息。
第六步:
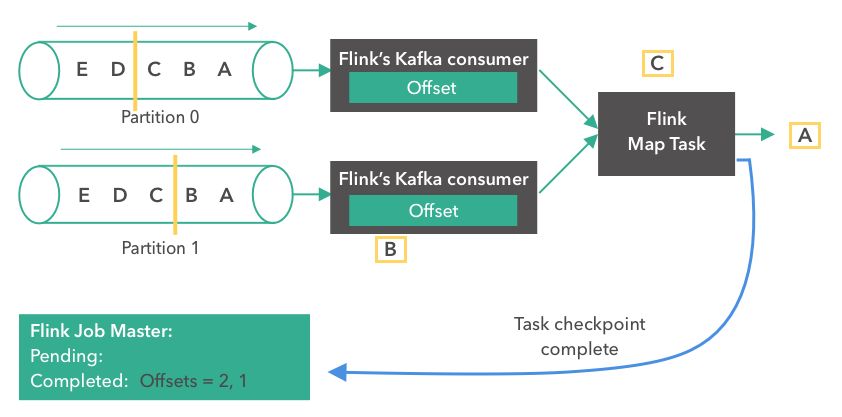
Flink Map Task 完成了它自己状态的快照流程后,会向 Flink JobMaster 汇报它已经完成了这个 checkpoint。当所有的 task 都报告完成了它们的状态 checkpoint 后,JobMaster 就会将这个 checkpoint 标记为成功。从此刻开始,这个 checkpoint 就可以用于故障恢复了。值得一提的是,Flink 并不依赖 Kafka offset 从系统故障中恢复。
故障恢复
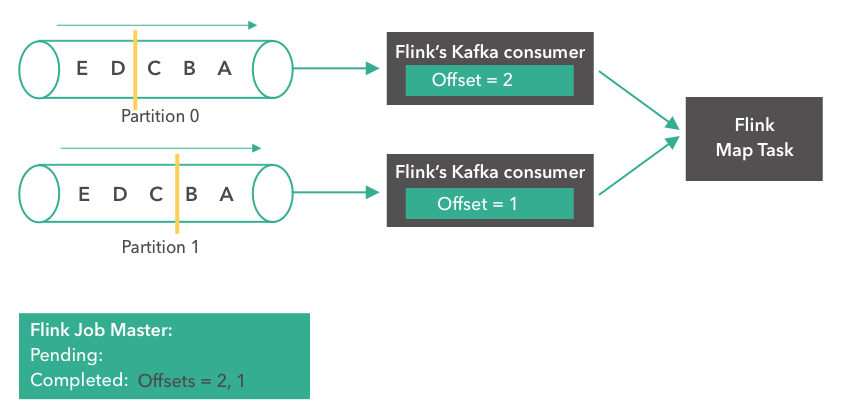
在发生故障时(比如,某个 worker 挂了),所有的 operator task 会被重启,而他们的状态会被重置到最近一次成功的 checkpoint。Kafka source 分别从 offset 2 和 1 重新开始读取消息(因为这是完成的 checkpoint 中存的 offset)。当作业重启后,我们可以期待正常的系统操作,就好像之前没有发生故障一样。如下图所示:
如果想了解更多有关如何最佳地使用 Apache Flink 与 Apache Kafka,以及一些常见问题,可以访问我们这篇文章 Kafka + Flink: A Practical, How-To Guide。
