
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

博客园_首页
J
Java Code Geeks
博客园 - 聂微东
量子位
C
Check Point Blog
T
The Blog of Author Tim Ferriss
T
Tailwind CSS Blog
G
Google Developers Blog
Google DeepMind News
B
Blog
罗磊的独立博客
腾讯CDC
GbyAI
GbyAI
博客园 - 【当耐特】
A
About on SuperTechFans
M
MIT News - Artificial intelligence
U
Unit 42
D
Docker
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
Y
Y Combinator Blog
大猫的无限游戏
大猫的无限游戏
小众软件
小众软件
S
SegmentFault 最新的问题
有赞技术团队
有赞技术团队

Comments for 后端技术 by Tim Yang

谈技术人员研究方向 – 后端技术 by Tim Yang 2010年总结 – 后端技术 by Tim Yang Lua coroutine 不一样的多线程编程思路 – 后端技术 by Tim Yang 是时候支持HTTPS了:免费SSL证书letsencrypt配置教程 – 后端技术 by Tim Yang 单元化与分布式架构的切分问题 – 后端技术 by Tim Yang 开发效率与系统稳定性杂谈 – 后端技术 by Tim Yang Memcached数据被踢(evictions>0)现象分析 – 后端技术 by Tim Yang 为什么我认为架构师需要坚持写代码? – 后端技术 by Tim Yang MacBook Air与工作效率 – 后端技术 by Tim Yang 微信架构的启示 – 后端技术 by Tim Yang C, Erlang, Java and Go Web Server performance test – 后端技术 by Tim Yang MemcacheDB, Tokyo Tyrant, Redis performance test – 后端技术 by Tim Yang 如何写nginx module – 后端技术 by Tim Yang 课题分离与他人叙事:认识自己的人生脚本 – 后端技术 by Tim Yang 我的半年健身心得:重塑精力与效率之路 – 后端技术 by Tim Yang 我们需要什么样的社会连接 – 后端技术 by Tim Yang 工程师如何规划新的一年计划 – 后端技术 by Tim Yang
Twitter系统运维经验 – 后端技术 by Tim Yang
Josephten · 2026-05-05 · via Comments for 后端技术 by Tim Yang

Monday, Nov 2nd, 2009 by Tim | Tags: , , ,

最近看到的另外一个介绍Twitter技术的视频[Slides] [Video (GFWed)],这是Twitter的John Adams在Velocity 2009的一个演讲,主要介绍了Twitter在系统运维方面一些经验。 本文大部分整理的观点都在Twitter(@xmpp)上发过,这里全部整理出来并补充完整。

Twitter没有自己的硬件,都是由NTTA来提供,同时NTTA负责硬件相关的网络、带宽、负载均衡等业务,Twitter operations team只关注核心的业务,包括Performance,Availability,Capacity Planning容量规划,配置管理等,这个可能跟国内一般的互联网公司有所区别。

1. 运维经验

* Metrics

Twitter的监控后台几乎都是图表(critical metrics),类似驾驶室的转速表,时速表,让操作者可以迅速的了解系统当前的运作状态。联想到我们做的类似监控后台,数据很多,但往往还需要浏览者做二次分析判断,像这样满屏都是图表的方法做得还不够,可以学习下这方面经验。 据John介绍可以从图表上看到系统的瓶颈-系统最弱的环节(web, mq, cache, db?)
根据图表可以科学的制定系统容量规划,而不是事后救火。Twitter operation dashboard
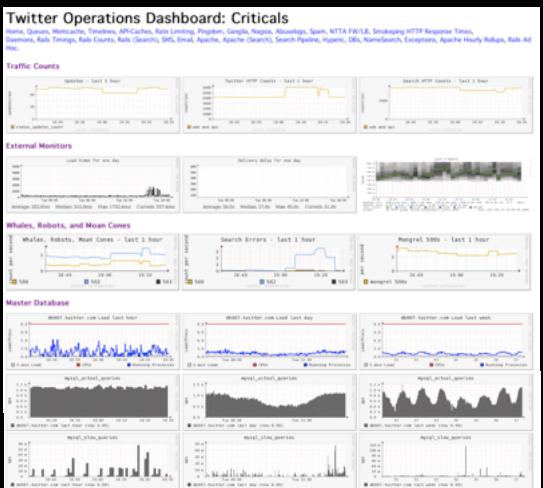
* 配置管理

每个系统都需要一个自动配置管理系统,越早越好,这条一整理发到Twitter上去之后引起很多回应。

* Darkmode

配置界面可以enable/disable 高计算消耗或高I/O的功能,也相当于优雅降级,系统压力过大时取消一些非核心但消耗资源大的功能。

* 进程管理

Twitter做了一个”Seppaku” patch, 就是将Daemon在完成了n个requests之后主动kill掉,以保持健康的low memory状态,这种做法据了解国内也有不少公司是这样做。

* 硬件

Twitter将CPU由AMD换成Xeon之后,获得30%性能提升,将CPU由双核/4核换成8核之后,减少了40%的CPU, 不过John也说,这种升级不适合自己购买硬件的公司。

2. 代码协同经验

* Review制度

Twitter有上百个模块,如果没有一个好的制度,容易引起代码修改冲突,并把问题带给最终用户。所以Twitter有一强制的source code review制度, 如果提交的代码的svn comment没有”reviewed by xxx”, 则pre-commit脚本会让提交失败, review过的代码提交后会通过自动配置管理系统应用到上百台服务器上。 有@xiaomics同学在Twitter上马上就问,时间成本能否接受?如果有紧急功能怎么办?个人认为紧急修改时有两人在场,一人修改一人review也不是什么难事。

* 部署管理

从部署图表可以看到每个发布版本的CPU及latency变化,如果某个新版本latency图表有明显的向上跳跃,则说明该发布版本存在问题。另外在监控首页列出各个模块最后deploy版本的时间,可以清楚的看到代码库的现状。

* 团队沟通

Campfire来协同工作,campfire有点像群,但是更适合协同工作。对于Campfire就不做更多介绍,可参考Campfire官方说明。

3. cache

  • Memcache key hash, 使用FNV hash 代替 MD5 hash,因为FNV更快。
  • 开发了Cache Money plugin(Ruby), 给应用程序提供read-through, write-through cache, 就像一个db访问的钩子,当读写数据库的时候会自动更新cache, 避免了繁琐的cache更新代码。
  • “Evictions make the cache unreliable for important configuration data”,Twitter使用memcache的一条经验是,不同类型的数据需放在不同的mc,避免eviction,跟作者前文Memcached数据被踢(evictions>0)现象分析中的一些经验一致。
  • Memcached SEGVs, Memcached崩溃(cold cache problem)据称会给这种高度依赖Cache的Web 2.0系统带来灾难,不知道Twitter具体怎么解决。
  • 在Web层Twitter使用了Varnish作为反向代理,并对其评价较高。