





前两天刚用Qwen3.8完成了Taint的PHP8适配(见上一篇),昨天DeepSeek发布了V4 Pro,号称都说各方面都有大幅提升,编程能力也逼近顶级闭源大模型。正好我手上有个给yaconf做优化的想法,就干脆就拿它试试。
先说下yaconf,这是我2015年写的一个PHP配置管理扩展,思路很简单:PHP启动的时候把所有的ini配置文件解析一次,结果放进内存,之后所有的Yaconf::get()都是纯内存查找,不再有文件IO和解析开销。配置数据被标记为immutable,FPM的各个worker进程通过操作系统的COW机制共享这份内存,只要配置不变,无论多少个worker,这份内存只分配一份。
对比传统的使用PHP Array或者Yaml来做配置的话,可以避免每次请求都需要解析,载入配置,无论内存占用还是性能提升都非常明显。
这次给yaconf做1.2.0版本,主要干了两件事:
sub/x.ini直接用Yaconf::get("sub.x")访问,子目录也支持分层的hot reload。这部分是前两天Qwen3.8干的。在opcache中,编译结果是被持久化到共享内存(SHM)里的,这块SHM在进程启动的时候一次性申请,所有编译结果都从这里面切。
它持久化一个script的方式,是两阶段的:先空跑一遍zend_persist_calc,把这个script需要的总尺寸算出来,确认剩余空间够了,才一次性分配一整块连续内存,把所有数据紧凑的填进去,修改其中的指针指向,最终让一个Oparray的数据都连续的存储在一起。
这样做有几个好处:
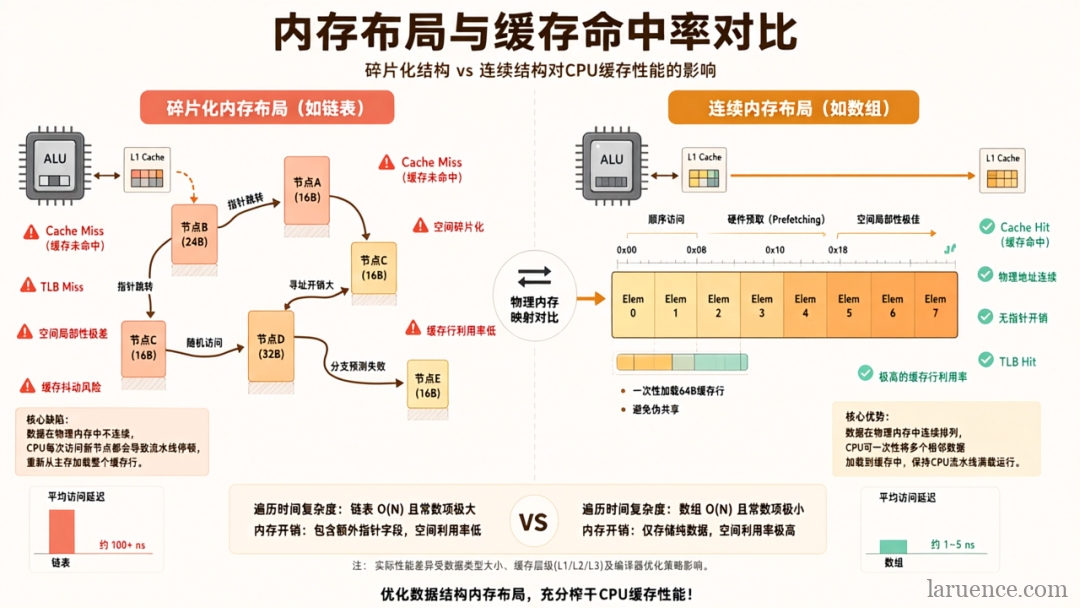
而yaconf目前的存储方式是每个value单独pemalloc,分散在各处。于是我就想把这套搬过来:在MINIT阶段处理完所有ini之后,先空跑一遍计算总尺寸,然后申请一块大的连续内存统一存储,配置中相同的内容可以复用,从而可以降低内存使用,以及提高缓存友好性。
我本地还是Obsidian + Claudian + CC Switch,这次把模型路由到deepseek-v4-pro。
把两阶段compact的想法丢给它,顺便让它参考我其他几个项目的代码风格,它就开工了。
第一感觉是:快,是真的快。响应、写代码,明显比前两天的qwen3.8要快一个档次。
我让它写了个bench:生成2000多条配置,对比原生PHP array、旧版yaconf、新版compact后的yaconf,分别读取十万次的性能差异。又让它参考opcache加了个mprotect,把我们申请的那块连续内存设成只读,在所有测试用例里都打开,方便发现预期外的写入。
看起来一切顺利,不过有一些小问题让我觉得隐隐不对,直到最后甚至开始翻车。
一直碰壁,一直碰:
我们改代码的工具,是靠"在文件里找到一段旧字符串,替换成新字符串"来工作的。整个过程DeepSeek调了Edit将近160次,其中100多次直接失败——String to replace not found in file:它凭记忆认为文件里是某段代码,实际文件里根本不是,只能重新读文件再试,来来回回浪费了大量token。它一点都不知道迭代自己的工具使用。
上下文压缩后的失忆:
因为任务太长,会话被自动compact了二十多次,每次compact之后,它就会忘掉一些之前的决定。比如有次我让它把bench文件挪到了stashes目录,compact之后它就忘了这回事,又要在本地新建bench,我不得不提醒它:
你是不是傻?你记得不记得你把bench文件挪到哪里了?
它这才想起来。类似的还有几次,都是compact之后忘了之前讨论好的方案,又走了一遍弯路。
然后是大的来了:
当时我让它整理commit,把compact、mprotect、bench拆成独立的提交。它一阵git reset加amend之后,跑测试挂了,过去一看,它跟我说:当前代码里没有compact block。
什么叫没有compact block?
它grep了一下,yaconf.c里compact、mmap、mprotect一个都搜不到。再看commit记录,message明明写着"Two-phase compact block + mprotect support",实际提交进去的却只有tests和bench——核心实现的几百行代码,被它reset --hard冲掉了。
更让我无语的是,它发现代码没了之后的第一反应是:改单元测试,想去掉所有mprotect相关的测试..... 把我都整无语了,不能解决问题,就解决问题的提出者。🤣
被我喝止以后。它才去翻reflog、fsck,最后在一个stash自动产生的WIP commit里找到了完整的compact实现,一个git apply捡了回来,30多个测试用例全部通过。
失而复得,惊出一身冷汗。
代码捡回来之后,得说说性能到底怎么样。
我们设计了一个bench(发布在github/laruence/stashes):模拟一个大型微服务集群的配置,400个服务、每个40个section,总共25万多个key,加载后工作集约140MB;然后以随机顺序读取,让硬件预取帮不上忙。这才是compact真正要解决的场景。结果:
| 场景 | 旧版 | 新版 | 提升 |
|---|---|---|---|
| 单键热点读 | 20.1 ns | 20.5 ns | 持平 |
| 随机访问(冷缓存) | 176.7 ns | 105.0 ns | 提升40% |
| 顺序遍历 | 39.3 ns | 31.3 ns | 提升20% |
| 内存占用 | 146.4 MB | 122.8 MB | 降低16% |
随机访问耗时降了约40%(吞吐约1.7倍):配置数据现在连续存储在一整块内存里,随机跳转时cache locality好得多,不再东一个西一个地到处踩内存。顺序遍历也快约20%。内存因为calc阶段把相同的字符串去重,省了16%。单键热点读两边持平——符合预期,热点key本来就在缓存里,布局无所谓。
最终yaconf 1.2.0提交:子目录支持 + compact存储,30多个测试用例,PHP 7.1到8.5的多版本CI全部通过(当然,7.1上它先栽了两次才修对)。
客观评价一下DeepSeek V4 Pro:
这次测试下来,我的结论是:DeepSeek V4 Pro写代码还可以,速度确实快,但是如果要写代码,就目前(2026年8月14日)国内的大模型来看,目前还是Qwen3.8更稳妥一些。
快很重要,但是稳更重要,毕竟代码被搞丢,是真的会吓出一身冷汗。
当然,也相信并期待DeepSeek在未来的更新,一定会越来越强!
yaconf 1.2.0已经发布在我的Github,欢迎大家去Review。
Note:本文由 Jarvis(作者的 AI 助理)从公众号「风雪之隅」自动同步至本博客。
阅读公众号原文:《用DS V4P改进Yaconf:快是真快,但它把我代码搞丢了》
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。