








2012来实验室交流,提到了一个未来可能的发展方向——协议层面的故障检测,我不太能理解这个词的意思,张觉学长让我阅读《Resilient AI Supercomputer Networking using MRC and SRv6》这篇文章,也许我能从中理解“协议级故障检测”
switch radix: 交换机基数?不,是指的是交换机上的端口数
与radix相似的一个词是radius,但radius是半径的意思,我们一般说network diameter,也就是网络直径,指的是任意两个节点之间跳数的最大值
the use of static source-routing using SRv6 to allow MRC the freedom to bypass failures by itself.
从摘要来看,我在这篇中最需要关注的是SRv6的机制
每轮通信由最慢节点决定,随着规模扩大,通信越来越受离群值影响
为了降低离群值拖慢同步过程,解决方案应该做到:
协议设计上有容错性、控制面简单、故障自动绕过
MRC: Multipath RC
RC: RDMA的RC(可靠连接)
部署MRC时禁用了交换机的动态路由,而使用SRv6进行静态路径上的源路由,这个后续解释
二分带宽:把所有GPU分成数量相同的两部分,跨切分线的所有带宽加起来就是二分带宽。这对AllReduce很重要。
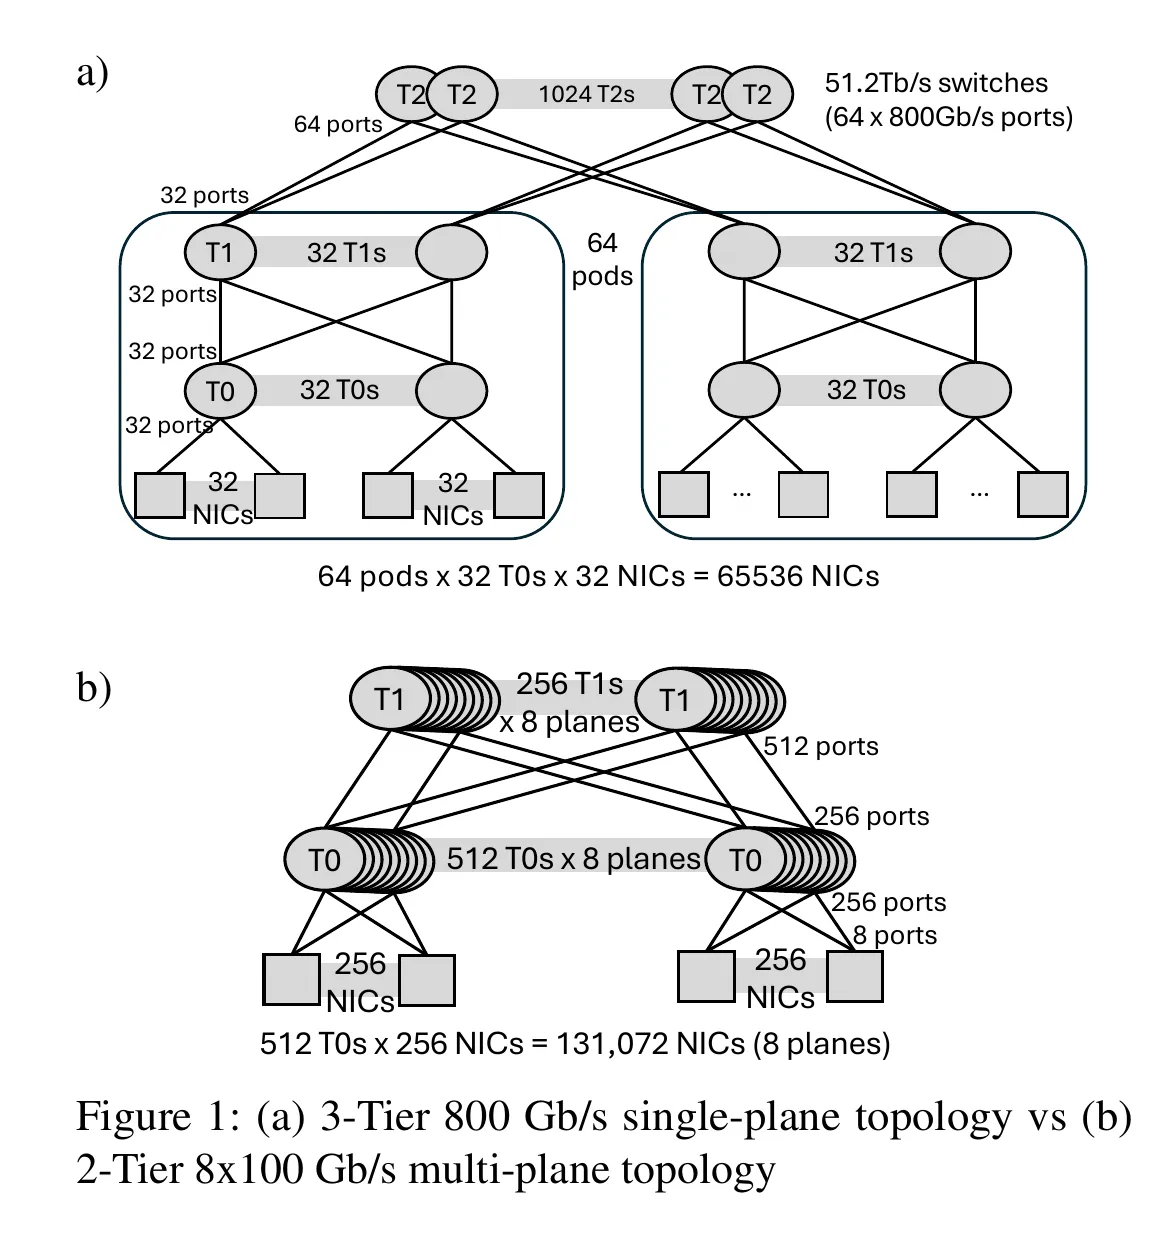
先贴一下原文的翻译:
考虑一个假设的拥有10万个GPU的集群,每个GPU配备一个800Gb/s的网卡。我们希望实现完全的二分带宽(full bisection bandwidth)以简化工作负载放置。一种选择是使用当今最快的以太网交换机构建传统的三层Clos拓扑(图1a)。目前数据中心级交换机可以达到51.2Tb/s,提供64个800Gb/s端口。每个Tier-0(T0)交换机向下连接32个网卡,向上连接32个Tier-1(T1)交换机,形成一个包含1024个网卡的Pod。每个T2交换机连接到64个不同的Pod,形成一个包含6.5万网卡的集群。如果我们希望连接10万个GPU,我们要么需要使用四层交换机,要么对网络进行超额订阅,要么构建多个独立的导轨(rails)。
或者,我们可以按通道拆分800Gb/s网卡,将其用作8个100Gb/s端口(图1b)。我们使用相同的51.2Tb/s交换机构建八个并行的100Gb/s Clos平面,但现在每个交换机拥有512个端口。每个T0交换机向下连接256个网卡端口,向上连接256个T1交换机。每个T1交换机又向下连接512个T0交换机,形成一个包含131,072个GPU的网络。
这里面对我的新知识是原来一个800Gb/s的网卡可以分成8个100Gb/s的网卡。
多平面拓扑的优势在于:
write和write-with-immediate,基本用于AI预训练够了。我总结来看最亮眼的是乱序写入和按包负载均衡,这个“按包负载均衡”可能就是我要找的“协议级别的故障检测了”,毕竟很容易可以想到,通过某种方式检测到一个链路出了故障之后可以直接从下一个包开始换路,不走有问题的链路,非常快速。
数据中心内动态路由(如BGP)收敛需要大量RTT(具体的过程我可能看过但记不住了), 本文中直接把动态路由关掉了,根据EV使用SRv6进行静态的源路由,就是说发送这个包的时候,包头里已经嵌入了这个包接下来要走的每一跳。
MRC使用了一个IPv6-in-IPv6的头部。我们知道,IPv6地址有128位。这里内层的IPv6地址是对端网卡的实际地址,外层假的IPv6地址用于决定路径。
外层这个"IPv6"的组成是32位定位符,这是固定的,后面96位被划分成6个16位的uSID,路由器每次读取locator和最前面的uSID组成的48位,根据机内静态的路由表决定这个包从哪个端口离开,然后将第一个uSID去掉,后面的左移16位,右侧补零,然后发送。
SRv6提供了一种源路由的信息表示,但是具体怎么路由还是由上面的EV来决定。
这里要提到“条带化”,条带化简单来说就是把一个整体拆成几个部分分散开来放,和RAID里是一样的。
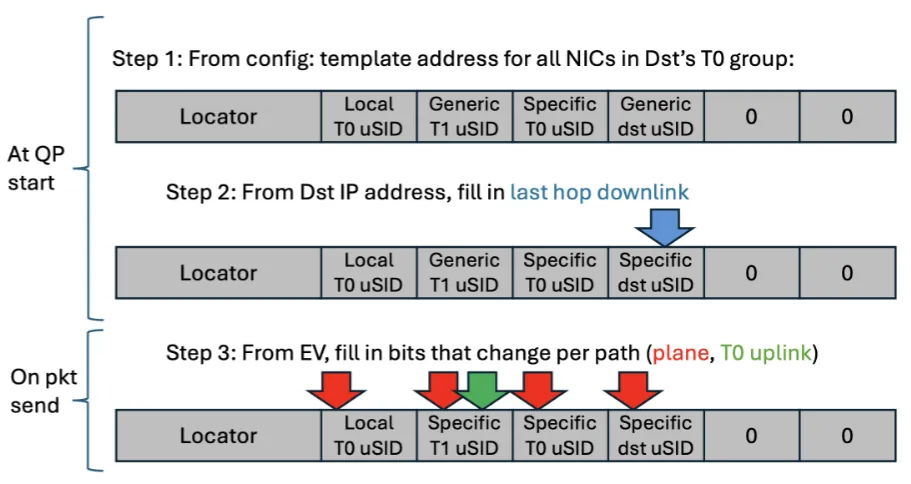
结合论文里的图来说:
创建QP时一组可供轮换的EV就生成好了,这个时候SRv6还是一个模板,根据对端不同,从配置文件中拿到的模板也不同。以跨tier 1的通信为例,模板的基础上要改的不过是最后一跳的downlink number,只有这样对面的To交换机才能把数据包发给正确的机器。
仅仅是这样的话,那所有包的源路由都一样的。EV需要给SRv6加上一些变化。
这里条带化就发挥出作用了,uSID内部具体的结构我不太清楚,不过看图片能知道16位uSID里有几位控制在哪个平面,多平面拓扑的图里也能看出来一个T0连接了两个T1,有几位是决定走哪条链路到T1的。然后这个EV就填充决定了平面与uplink的这些位。注意同一个包走的平面需要是一样的。
如果根据这个SRv6路由去发送数据包,结果丢包了,或者重传了,那么只要把这个EV换掉,就可以绕开故障。
MRC使用Clustermapper进行故障检测,它运行在每个节点上,毫秒级地定时通过源路由来指定探测包在agent和TO或agent和T1之间来回一次,以此检测故障链路。
为什么不用ping?:用ICMP需要经过控制平面处理,而SRv6源路由纯粹是数据平面处理了,可以实现更高的频率。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。