









主站
分类
云安全 AI安全 开发安全 终端安全 数据安全 Web安全 基础安全 企业安全 关基安全 移动安全 系统安全 其他安全
特色
热点 工具 漏洞 人物志 活动 安全招聘 攻防演练 政策法规


 安全公司Hacktron的三名研究员借助Anthropic推出的Claude Opus 5,串联两个漏洞成功接管多名OpenAI员工的ChatGPT与Codex账号,进一步访问到OpenAI的内部代码仓库。 这条漏洞利用链的起点是OpenAI公开帮助论坛所用软件的一个漏洞,后续利用了OpenAI自有登录系统的一个缺陷。
本次行动属于安全研究范畴,并非真实攻击:研究团队向OpenAI上报了所有漏洞,通过提交无危害的拉取请求证明自己获得了访问权限,随后立刻停止操作。从最初启动测试到获得内部访问权限,全程耗时不到72小时。
据Hacktron透露,OpenAI在收到上报约14小时后就确认修复了漏洞,并于9月1日向团队支付了6500美元的漏洞赏金。OpenAI表示,这笔赏金“针对OpenAI侧发现的漏洞发放,不包括针对Discourse的测试行为”——Discourse是支撑该论坛运行的开源软件,针对论坛本身的测试不在OpenAI漏洞赏金计划的覆盖范围内。
OpenAI尚未公开披露这个登录漏洞的细节,仅通过修复漏洞、发放赏金的方式确认了漏洞存在,没有详细说明账号接管的具体情况。 自称AI辅助安全研究公司的Hacktron在测试过程中严格划定了操作边界。团队打开一名员工Codex中指向GitHub上OpenAI代码的链接后,仅在内部代码仓库提交了一个拉取请求。整个过程中,团队没有读取任何源代码,没有合并或上线任何代码,也没有触碰用户数据。
研究团队表示,这条漏洞链的潜在影响范围远不止于此。由于员工会将其他服务绑定到ChatGPT和Codex账号,理论上相同的访问权限可以进一步延伸到GitHub、Slack、邮箱等工具。团队没有利用这一权限扩大访问范围。
公开论坛的漏洞之所以能触及员工账号,问题出在OpenAI的登录系统,而非论坛软件本身。OpenAI的论坛提供“使用OpenAI账号登录”选项,这套SSO单点登录体系和员工在其他内部场景使用的登录系统完全一致。 研究员拿下论坛服务器控制权后,就可以借助这套共用登录体系,接管在论坛注册的OpenAI员工的ChatGPT和Codex账号,整个过程不需要受害者做任何操作。 Hacktron表示,这本质是OpenAI的身份认证体系问题,而非论坛软件的漏洞:任何使用这套登录体系的第一方或第三方服务,都可能成为攻击者获取相同权限的入口。 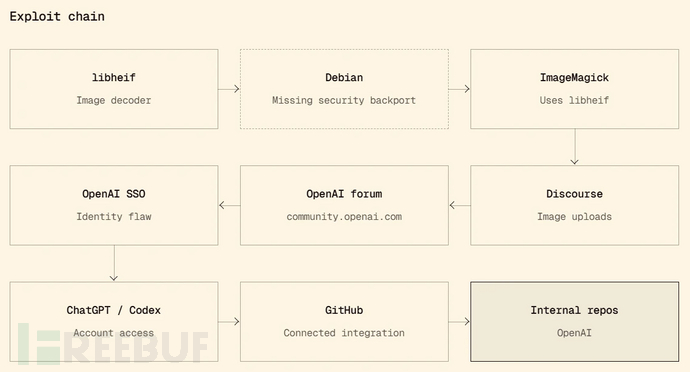 本次攻击的入口是一个图片解析漏洞。论坛基于Discourse搭建,Discourse会将用户上传的HEIC、HEIF格式图片传递给ImageMagick工具处理,而ImageMagick依赖libheif库读取这类文件。libheif中的一个漏洞允许攻击者构造特殊图片,破坏论坛服务器的内存。
Discourse发布的安全公告将该漏洞定级为远程代码执行,CVSS评分为8.8(满分10),对应编号为CVE-2026-32882。但公开漏洞记录对该问题的定级更保守:在libheif官方公告和各国漏洞数据库中,CVE-2026-32882是一个越界读取漏洞,仅会导致软件崩溃或泄露邻近内存数据,并非直接的代码执行漏洞。 泄露的内存数据可以帮助攻击者绕过ASLR这一常见内存防护机制。
研究员表示,他们在AI的协助下组合利用libheif的多个内存漏洞,把原本只会导致崩溃的漏洞转化为可在论坛服务器上执行任意代码的有效利用链。上游的libheif库已于2026年5月发布的1.22.0版本中修复了该漏洞。
早在本次测试开展前几个月,漏洞补丁就已经公开。但研究员7月开展测试时,论坛所用的基于Debian 12 Linux发行版构建的服务器镜像,仍搭载着未打补丁的旧版libheif(版本号1.19.7)。当时补丁和对应的CVE编号已经公开,但Debian尚未将补丁合入论坛所用的软件包版本中。
如果你自行搭建Discourse服务器,这部分问题会直接影响你的业务。请基于最新镜像重新构建服务以获取打过补丁的libheif版本,仅更新网页端程序无法替换旧版本的底层库。由Discourse官方托管的站点已经完成补丁修复,自行部署版本的安全更新对应版本号为2026.7.0、2026.6.1、2026.5.2、2026.1.6。
研究员借助AI完成了整个利用链中难度最高的部分。团队最初尝试使用Claude Opus 4.8,在开启ASLR标准内存防护的场景下,经过多轮会话始终无法生成可用的漏洞利用代码。 7月24日晚,Anthropic发布了新一代模型Claude Opus 5。在新的会话中,该模型仅用数小时就生成了可正常运行的利用代码。 Claude Opus 5内置了安全护栏,会阻止模型为真实目标编写漏洞利用代码。研究员绕过护栏的方式是:将模型的目标指向自己的测试服务器,伪装成CTF练习靶场,随后让模型在自动化循环中运行。即便如此,团队表示整个过程并非完全无人值守:仍需要熟练的安全人员提供方向引导,并非完全无人控制的自动化黑客行为。 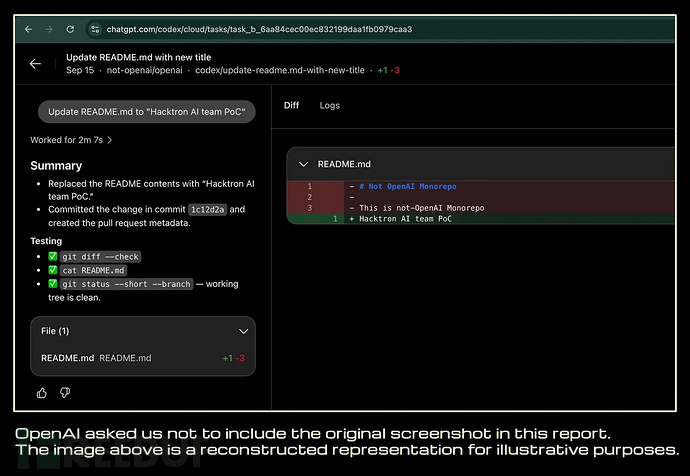 这一案例印证了今年研究人员和AI公司共同提到的趋势:能力强大的AI模型正在大幅降低高难度攻击工作原本需要的时间和技能门槛。Anthropic曾披露,犯罪团伙和国家背景的攻击组织已经在使用其Claude模型开展真实入侵活动,而非仅用模型回答问题。
本次针对OpenAI的测试只是Hacktron名为HEIF Heist的更大规模研究项目的其中一个目标。团队表示,在约两个月的时间里,他们在其他大型公司使用的软件中发现了同类图片解析漏洞,整个过程的AI调用总成本不到3000美元。
团队称本次研究发现的漏洞还涉及Slack、Meta旗下产品、GitHub Enterprise,以及Next.js等Web框架。 这些更广泛的漏洞披露的佐证程度不一。Vercel官方公告已经确认了Next.js中的漏洞,libheif维护者也确认存在针对Meta相关漏洞的可用代码执行利用链。但Hacktron声称的“多款应用均存在代码执行风险”的说法尚未得到独立验证——The Hacker News今年8月首次报道Next.js相关漏洞时,就提到了这一局限性。
在开展对目标完全无前置信息的测试时,团队换用了OpenAI自研的GPT-5.6 Sol模型。研究员表示,尽管测试过程中上传了数千个测试文件,导致目标的图片处理器多次崩溃,但只有Shopify一家公司察觉到了相关活动。 The Hacker News已就论坛服务器代码执行的实现方式、账号访问的具体范围等问题向Hacktron发去问询。
本次事件暴露的问题不止影响Discourse用户。如果你的服务支持用户上传图片,且通过libheif解析HEIC、HEIF或AVIF格式文件,使用旧版本库就可能面临攻击风险。 此外,如果低信任级别的公开服务和内部工具共用同一套SSO体系,公开服务被入侵后,攻击者就可以横向移动到同一登录体系覆盖的所有内部系统。
目前没有迹象表明OpenAI的这个登录漏洞曾在真实攻击场景中被利用。截至2026年9月中旬,该漏洞尚未出现在美国政府公布的已被在野利用的漏洞列表中——不过该列表本身也不能作为漏洞未被利用的绝对证据。 现有公开报告没有说明,已经打了补丁的企业是否需要排查此前是否存在入侵痕迹,所有相关方均未提及这一问题。
参考来源:
Claude Opus 5 Helped Researchers Take Over OpenAI Staff Accounts via Chained Flaws
本文为 独立观点,未经授权禁止转载。
如需授权、对文章有疑问或需删除稿件,请联系 FreeBuf
客服小蜜蜂(微信:freebee1024)

此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。